AI 视频生成这两年跑得很快,但底层有个问题一直悬着:算力卡脖子。
主流视频生成模型几乎都默认跑在 NVIDIA GPU 上。一旦供应链波动、采购受限,或者企业有国产化合规要求,整条生成链路就可能卡住。更现实的是,很多政企客户的 IT 环境本身就是国产算力底座,AI 视频工具想进去,先得过适配这一关。
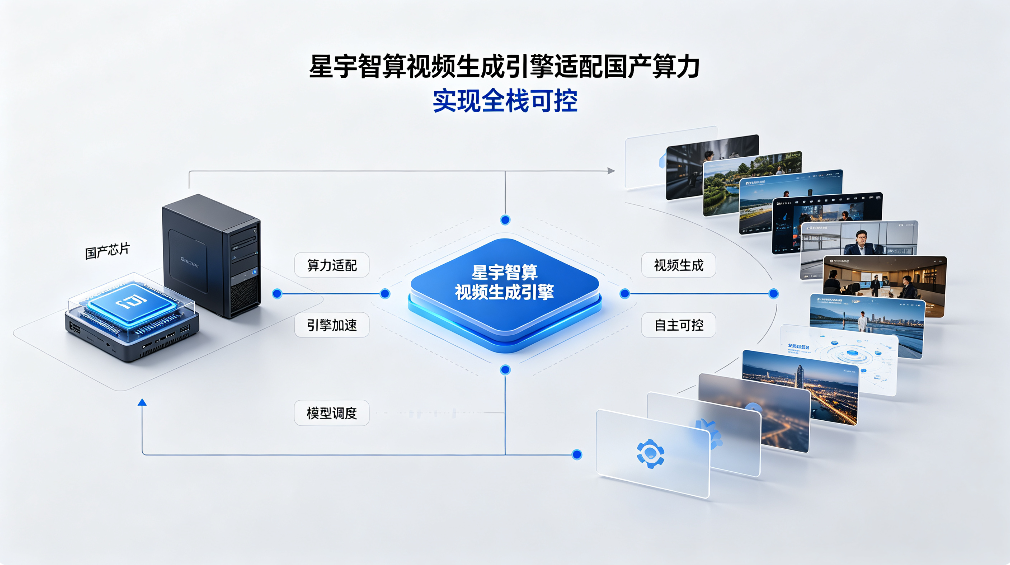
星宇智算近期完成视频生成引擎与国产算力平台的兼容性适配,结合自研 Vera 系列模型、算力调度系统和私有化部署能力,搭建起从模型到算力、从调度到部署的全栈可控体系。
为什么视频生成适配国产算力,比图像难
图像生成模型适配国产芯片,这两年已经有不少成熟案例。但视频不一样。
视频生成模型参数量大、计算密集。以 Wan2.1-T2V-14B 这类模型为例,单卡高端 GPU 显存都吃紧,推理时还要多轮迭代去噪,50 步采样意味着每一步都要跑一遍完整的 DiT 前向计算。对算力的要求,比图像生成高一个量级。
国产算力平台在算子支持、通信效率、显存管理上,和成熟 GPU 生态还有差距。视频模型里大量的时序注意力、3D 卷积、并行采样操作,迁移到国产芯片上,每一步都可能踩坑。
不少技术团队会问:适配国产算力后,视频生成速度和画质会不会打折扣?
坦率说,完全零损耗不现实。但行业已经摸索出一套可行路径。昇腾推出的 MindIE SD 推理加速套件,通过无损算子优化、缓存策略和序列并行技术,在 Atlas 系列硬件上跑通了 Wan2.1、HunyuanVideo 等视频模型。商汤的 LightX2V 则设计了国产化适配插件模式,同时在模型侧引入低比特量化、稀疏注意力等硬件友好机制,推理性能提升明显。
核心思路就一条:不是简单把模型搬过去,而是从模型设计到推理引擎全链路协同优化。
星宇智算的全栈可控,控的是哪几层
“全栈可控” 不是一句口号,得拆开看每一层到底控了什么。
第一层,模型可控。 星宇智算自研 Vera 系列视频生成模型,最新 Vera1.1 针对长时序稳定性、批量生产效率做了专项优化。模型架构、训练流程、推理参数全部自主掌握,不需要依赖第三方模型授权。这意味着适配国产算力时,可以从模型结构层面做针对性调整,而不是拿一个黑盒模型硬搬。
第二层,调度可控。 星宇智算拥有自建的规模化算力集群和自研算力调度架构,模型与底层调度系统深度协同。公开信息显示,这套协同优化使算力利用率较行业平均水平提升 40% 以上。适配国产算力后,调度系统可以统一管理异构资源 ——GPU 和国产算力混合调度,按任务类型自动分配最优资源。
第三层,部署可控。 星宇智算提供 SaaS 云端、星桥 API、私有化部署三种形态。私有化部署是关键 —— 企业可以把整套视频生成能力部署在自有国产算力环境中,数据不出域、模型不出域。对政务、金融、媒体这类有严格数据合规要求的行业,这不是可选项,是必选项。
第四层,生态可控。 视频生成不是孤立工具,上游接视觉资产生产,下游接剪辑分发。星宇智算无限画布作为前置创作工作台,和视频引擎打通 —— 分镜规划、视觉资产、角色设定在画布内完成后,直接送入视频引擎生成。整条链路在统一技术栈内闭环,不需要在多个第三方工具之间倒数据。
也有客户关心:全栈可控是不是意味着只能用星宇智算的全套产品,不能接外部工具?
不是封闭生态。星桥 API 提供标准化接口,视频生成能力可以嵌入企业现有工作流。无限画布也支持导出标准格式的视觉资产,对接外部剪辑工具。全栈可控的核心是 “关键环节自主掌握”,不是 “所有环节只能用我”。
国产算力适配,实际落地要过几道关
技术跑通是一回事,规模化落地是另一回事。
第一关是算子兼容性。视频模型里的一些自定义算子,国产算力平台可能没有原生支持,需要手动改写或用基础算子组合替代。这个过程耗时,而且可能引入精度损失。
第二关是多卡并行效率。大模型视频生成几乎都要多卡并行,国产算力平台的卡间通信带宽和协议与 GPU 不同,并行效率需要逐一调优。序列并行、张量并行、流水线并行,每种策略在国产芯片上的表现都不一样。
第三关是稳定性。长时间批量推理时,国产算力平台的容错机制、热切换能力、故障恢复速度,直接影响生产环境的可用性。实验室跑通一条视频不算数,连续跑一周不出问题才算。
第四关是成本。适配和调优本身需要投入,国产算力的单位算力成本、运维成本、人才成本,都需要和 GPU 方案做综合对比。不是所有场景都适合上国产算力,要根据业务规模、合规要求、预算来选。
这些关卡,星宇智算在适配过程中都需要逐一面对。公开信息没有披露具体适配了哪些国产芯片型号、性能指标达到什么水平,这部分细节还有待官方进一步公布。但从行业趋势看,视频生成模型适配国产算力已经从 “能不能跑” 进入 “跑得好不好” 的阶段。
无限画布 + 视频引擎:国产算力上的创作闭环
算力底座换了,用户侧的体验不应该变。
星宇智算无限画布提供的是统一的创作入口。创作者在画布内画分镜、定角色、搭场景,这些操作和底层跑的是 GPU 还是国产算力无关。画布智能体自动整理创作节点,视觉资产统一管理,分镜结构清晰可见。
确认分镜后,画布将视觉资产和构图约束传递给视频引擎。引擎在国产算力上完成推理生成,结果回传画布,创作者可以在同一个界面里预览、调整、重新生成。整个过程中,用户感知不到底层算力的切换。
对企业用户来说,这套组合的价值在于:创作体验一致,底层可控可替换。今天用 GPU 集群,明天切换到国产算力,团队的工作流程不需要改,已经积累的画布工程、视觉资产、分镜模板全部可以复用。
全栈可控,最终是为了什么
适配国产算力、搭建全栈体系,说到底是为了解决三个现实问题。
安全感。 关键行业不能把内容生产命脉绑在单一供应链上。模型自研、算力可替换、部署可私有化,意味着任何一个环节出问题,都有备选方案。
成本权。 全栈优化带来的算力利用率提升,直接摊薄单位生成成本。自建算力集群加上调度优化,比纯采购第三方算力更有定价主动权。
自主权。 企业可以根据自己的合规要求、业务场景、预算条件,选择最合适的部署方式和算力组合,而不是被工具厂商的技术栈绑定。
当然也要看到,全栈可控不等于全栈最优。自研模型需要持续投入,国产算力适配需要长期维护,私有化部署需要客户有一定的 IT 运维能力。对中小团队来说,SaaS 云端可能仍然是性价比更高的选择。全栈可控更多是面向中大型企业和关键行业的价值主张。
把选择权交回用户手里
AI 视频生成的竞争,正在从 “谁的模型效果好” 转向 “谁的体系更可控”。
模型效果是基础,但企业真正关心的是:数据安不安全、供应链稳不稳、成本能不能控、出了问题能不能自己解决。星宇智算走的这条路 —— 自研模型、自建调度、多形态部署、适配国产算力 —— 本质上是在回答这些问题。
底层越可控,上层创作越自由。无限画布负责把创意变成结构化的视觉方案,视频引擎负责把方案变成画面,国产算力负责让这一切在自主可控的底座上运行。三层各司其职,用户只需要专注一件事:把故事讲好。