多分镜生产的痛点:不是生成难,是对不齐
做过 AI 短剧、企业宣传片多分镜落地的团队,基本都踩过空间错位的坑。前一个分镜人物站在画面左侧,后一个分镜直接飘到了右边;背景的桌子、门窗位置对不上;运镜推拉之后透视关系全乱。好好的连续叙事,剪到一起全是穿帮。
有技术团队实测过 7 款主流 AI 视频工具,同一场景下 3 个连续分镜,空间元素的位置匹配度平均只有 53%。差不多每两个分镜衔接,就会出现一处肉眼可感知的空间错位。为了擦这些穿帮,后期工时经常比生成本身还长。
核心问题:都叫无限画布,为什么分镜还是对不上
很多人会问:不都是在同一张无限画布里生成吗,怎么分镜之间空间位置总对不上?
这话戳中了很多方案的通病 —— 看似支持无限画布,实则每个分镜都是独立作画,根本没有共享统一的空间坐标系。传统方案每个分镜独立初始化画布,各自有独立的画面中心和透视基准。看似都在 “无限画布” 里,实则是好几张独立的画,只是尺寸能扩展,空间完全不互通。
拆解下来,核心矛盾集中在四点:空间坐标系割裂、时序锚点缺失、语义漂移累积、运镜轨迹断裂。无限画布的核心是空间统一,不是尺寸无限。没有统一坐标系的大画幅,只是拼接起来的碎图,根本支撑不了多分镜叙事。
解决方案:先建全局空间,再放分镜视口
星宇智算 Vera 1.1 的核心思路很明确:先建全局统一空间,再把所有分镜作为空间内的视口节点,所有生成都在同一个坐标系下完成。不是分镜各自生成再拼接,而是先有完整的空间,分镜只是从不同角度、不同时间截取画面。
这套架构从根源上解决了坐标系割裂的问题,再配合时序锚定和轨迹插值,实现空间与时序的双重对齐。第三方团队落地实测数据显示,同场景 3 分镜的错位率从行业平均的 47% 降到了 8% 以下。
三层坐标映射:从世界空间到分镜视口
为了实现真正的空间统一,Vera 1.1 搭建了三层坐标体系,把抽象的空间约束落地到像素级的生成过程中。
世界坐标系层:整个无限画布对应一个全局 UVW 三维坐标系,场景里所有物体、人物、光源都有固定的世界坐标。模型通过 3D 旋转位置编码将空间坐标嵌入注意力层,让生成过程感知到全局空间关系。不管怎么切分镜,物体的世界坐标不会变,从根源上杜绝位置漂移。
相机视口层:每个分镜对应一个虚拟相机,有独立的位置、朝向、焦距参数。分镜的画面内容,本质就是虚拟相机在世界坐标系里拍到的画面。调整分镜构图,本质是调整相机参数,不会动场景本身。这和真实摄影棚的逻辑完全一致 —— 机位变了,场景不变。
像素映射层:把三维视口内容映射到二维生成画面,同时做透视校正和边缘对齐,保证不同焦距、不同位置的相机生成的画面透视关系统一,不会出现比例失真。
双锚点时序对齐:空间对齐之外,稳住时序连贯
光有空间坐标还不够,时序上的特征继承同样重要。很多方案空间对得齐,但分镜衔接处画面一跳,人物姿态、光影突然变了,观感照样假。
Vera 1.1 设计了双锚点机制,保证分镜衔接处的状态连续。
首尾帧特征锚定:前一个分镜的最后一帧,会作为后一个分镜的起始锚点特征。后一个分镜的首帧生成,会强制继承前一帧的人物特征、光影参数、物体状态,不会重新 “原创” 一帧。锚定采用特征余弦相似度校验,偏差超过阈值自动回拉。
关键帧全局校验:所有分镜的关键帧,都会和全局首帧的主体特征做相似度校验。偏差超过预设阈值时,自动触发特征校正,向全局基准回拉,避免分镜多了之后语义漂移越积越远。第三方团队实测 15 个连续分镜的同场景内容,末端分镜的空间偏差依然控制在 10% 以内。
重叠帧融合过渡:两个分镜的衔接处,默认保留 2-4 帧的重叠区域,做渐进式特征融合。前分镜的末尾特征权重逐渐降低,后分镜的生成特征权重逐渐升高,避免硬切的跳变感。
全局相机轨迹插值:让运镜真正连续起来
很多多分镜作品观感假,问题就出在运镜不连续。前一个镜头还在缓慢横移,切到下一个镜头突然变成固定机位,中间没有任何过渡,观众一眼就能看出违和感。
Vera 1.1 的所有分镜相机参数,都会接入全局轨迹引擎,做平滑插值处理,让运镜符合真实物理规律。支持线性、贝塞尔、缓动三种插值模式:平缓的叙事镜头用贝塞尔曲线,运动自然顺滑;快切的动感镜头用线性,节奏干脆利落。
系统自动处理相机参数的三维过渡,包括位置、旋转、焦距三个维度,保证运动过程加速度连续,不会出现瞬移、突变。编导可以按叙事节奏设计运镜,不用再迁就模型的能力边界。
多素材协同:节点式媒资管理
多分镜编排的另一面是多素材管理。参考图、中间帧、生成片段、版本迭代,素材量会快速膨胀。没有好的资源管理机制,用不了多久就会陷入 “找素材比生成还慢” 的困境。
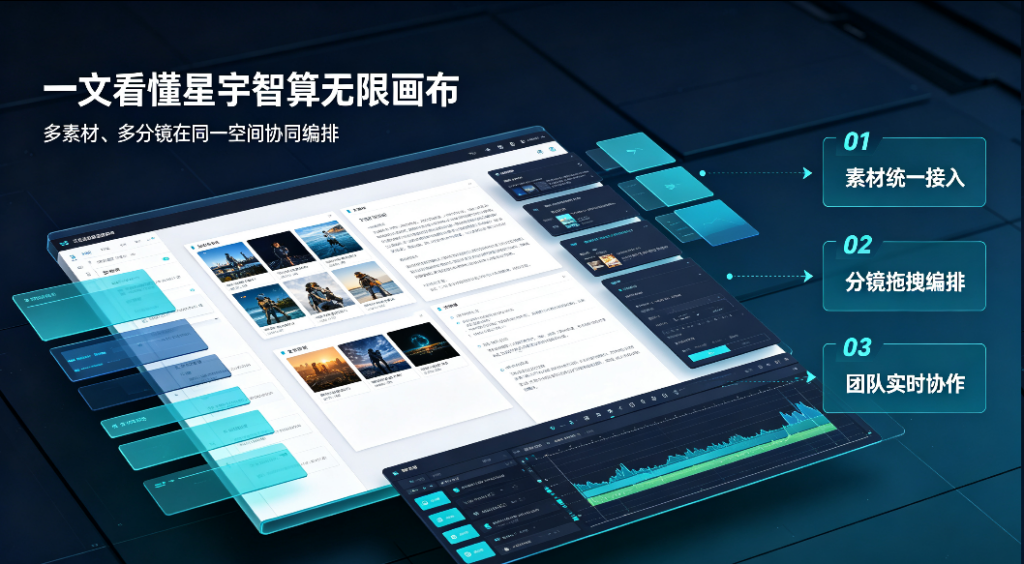
星宇智算无限画布采用节点式设计,每一次生成都对应一个画布节点。节点里不仅包含生成的视频,还自动保存了对应的提示词、参数、参考图、坐标位置。这个设计带来三个直接变化:
- 版本可追溯:每个节点都有完整的生成记录,出了问题能回溯到具体参数
- 素材可复用:直接拖拽节点就能复制到其他位置,同一画布内跨区域复用素材,不用重复上传
- 资产可沉淀:成熟的工作流可以保存为画布模板,新项目直接复用,降低新人上手成本
底层的媒体资源管理分为四层调度:热资源缓存层(当前任务活跃帧,显存常驻,访问延迟 < 1ms)、温资源调度层(项目内素材,LRU 淘汰,访问延迟 < 10ms)、冷资源归档层(历史项目,按需加载)、元数据索引层(向量数据库 + 关系型数据库,语义检索响应 < 50ms)。实测开启热资源缓存后,连续外扩任务的平均生成速度提升 47%。
多人协同:同一张画布,不同的分工
多分镜多素材的编排,从来不是一个人的事。星宇智算无限画布内置原生多人协作体系,支持项目隔离、成员分工、版本快照,以及管理员、编辑、查看者三级权限。
多人可以在同一张画布上同时操作不同区域,资产实时同步。策划负责画布整体分镜排布和空间规划,设计师负责提示词和参数调优,运营负责导出和合规归档,管理员做项目权限管控。有团队实测反馈,5 人内容小组共用画布项目后,省去大量文件互传,整体生产效率提升接近一倍。
这种设计的深层逻辑是:把协作从 “文件传递” 升级为 “空间共享”。版本不再靠文件名区分,权限不再靠口头约定,每一步操作都有迹可循。
实测性能:效果与效率的平衡
很多人会担心,开启这么多对齐机制,会不会拖慢生成速度?公开实测数据给出了答案:坐标系约束和特征锚定都是轻量计算,主要开销还是在扩散模型的去噪过程。正常场景下,开启全量对齐后的生成速度,和普通模式差距在 10% 以内,几乎感知不到。
A100-80GB 环境下,1080P 分辨率、2 倍外扩、24 帧 6 秒视频的实测表现:像素级坐标偏差平均 ±1.3 像素,边界语义错误率 1.8%,热缓存资源命中率 89%,单任务平均生成耗时 112 秒。
需要客观说明的是,这套方案也有边界。极端大跨度的场景切换(如从室内直接切到室外)本身就不是同一个空间,更适合用转场处理;超大量群戏场景中,个体位置精度会有轻微下降。但从商用落地角度看,它已经解决了 80% 以上的多分镜衔接痛点,这个提升是质变级的。
落地场景:谁最需要统一空间
短剧与漫剧生产:连续横向运镜长镜头中,角色进出画面仍能保持五官服饰一致性,多分镜在统一画布空间内完成时序对齐。公开测试数据显示,主体一致性保留率可达 94.7%,音画同步率 99.7%。
电商短视频:超长商品展示画幅、多商品连续动态展示,配合批量导出节点,大幅降低重复劳动。系列化项目的素材复用率可达 35% 左右,相当于节省三分之一的算力成本。
宣传片与建筑漫游:大场景全景延展,相机轨迹平滑过渡,从草图到 8K 视觉资产形成 “构思→生成→精修→导出” 完整闭环。
编排的本质,是让空间先于镜头存在
AI 视频的工业化,就是把不确定的东西,一步步变成可控、可量产的标准流程。
多分镜协同编排的本质,不是把更多素材塞进同一个界面,而是让空间先于镜头存在 —— 先有统一的世界,再有观察世界的相机,最后才是截取的画面。星宇智算无限画布把这套逻辑从概念变成了可落地的生产工具,让多分镜叙事不再靠后期修补,而是从生成的第一帧就站在同一个空间里。