什么是 “像素牢笼”
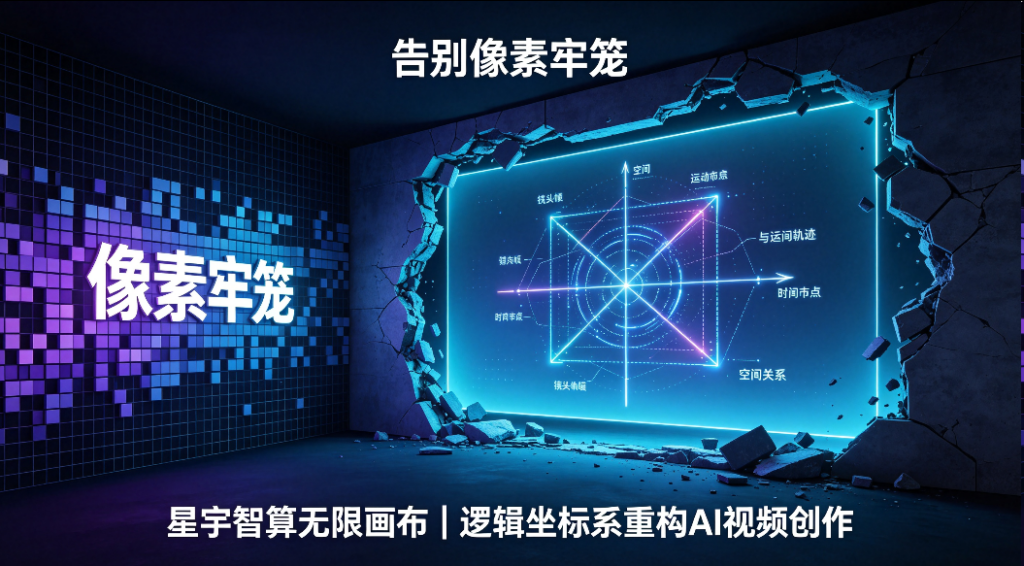
传统 AI 视频生成有一个看不见的边界:模型以固定尺寸的张量为输入和输出,画幅的边界就是模型的计算边界。模型只理解 “这一块像素是什么”,不理解 “这个物体在空间的什么位置”。
这导致了一系列行业顽疾:每个分镜独立生成,没有共享的空间基准,同一个角色在不同镜头里五官服饰变来变去;前一个分镜人物站在画面左侧,后一个分镜直接飘到右边;运镜推拉之后透视关系全乱;画布向外扩展时,边界区域语义断层,出现拼接痕迹和畸形崩坏。
本质原因只有一个:AI 被关在像素的牢笼里,它看得见像素,却看不见空间。
问题的本质:模型缺一套 “空间语言”
人眼理解世界的方式,不是逐像素扫描,而是先构建空间 —— 这个房间有多大,桌子在什么位置,人站在哪里,镜头从哪个角度拍。空间关系确定了,画面细节才有意义。
传统 AI 视频生成恰恰缺了这一步。它直接从文本跳到像素,中间没有空间建模的环节。提示词里写 “人物站在桌子旁边”,模型并不知道桌子在空间的哪个坐标,人物和桌子的相对位置关系是什么,只能在每一帧里重新 “猜” 一个布局。分镜越多,猜的偏差累积越严重。
行业内不少方案试图用后期拼接解决这个问题 —— 先生成多个固定画幅的片段,再用算法对齐拼接。但这是治标不治本:每个片段生成时就没有共享的空间基准,后期再怎么对齐,也只能做到像素层面的勉强贴合,做不到语义层面的空间统一。
逻辑坐标系的核心思想:先建空间,再放内容
星宇智算无限画布的底层突破,就是在文本和像素之间插入了一层 “逻辑坐标系”。它的核心思想很简单:先构建一个连续的、无边界的虚拟空间,把所有角色、场景、道具、分镜都放进这个空间里,赋予每个元素唯一的空间坐标,然后再从不同角度、不同时间截取画面。
这和真实摄影棚的逻辑完全一致:先搭好场景,摆好道具,演员站好位置,然后摄影师拿着相机从不同角度拍摄。机位变了,场景不变;镜头切了,演员的位置不变。
在逻辑坐标系里,分镜不再是一张张独立的画,而是同一个空间里的不同视口。角色不再是每帧重新生成的像素集合,而是空间里有固定坐标、固定特征的实体。运镜不再是每个分镜独立计算的运动,而是全局相机轨迹上的一段连续路径。
四层坐标空间:从全局世界到输出像素
逻辑坐标系不是一个单一的坐标系统,而是一套四层映射的空间架构。每一层各司其职,把抽象的空间约束逐层落地到像素级的生成过程中。
第一层:全局世界坐标系 —— 唯一基准
这是整个无限画布的根坐标系,是一个连续的二维 / 三维虚拟空间,单位是虚拟长度,没有边界。所有元素 —— 角色、场景、道具、分镜节点、光源 —— 都在这个坐标系里有唯一的空间坐标。不管视口怎么移动、画布怎么扩展,元素的世界坐标不会变。
模型通过 3D 旋转位置编码(RoPE)将空间坐标嵌入注意力层,让生成过程感知到全局空间关系。这意味着模型在生成任意一个区域时,都知道这个区域在全局空间的哪个位置,周围有什么元素,透视关系应该是什么样的。
第二层:画布分块坐标系 —— 分片渲染的对齐基准
超大尺寸画布不可能一次性生成,需要切分成多个子分片窗口迭代推演。每个分块有自己的局部坐标,但所有分块都与全局世界坐标系对齐。
全局坐标锚点体系保证分块之间不会错位:全画布四个角设一级全局锚点,每个拼接缝设二级对齐锚点,关键物体位置设三级语义锚点。三级锚点协同约束,把多窗口拼接的累积误差控制在可接受范围内。
第三层:视口相机坐标系 —— 分镜的本质是相机
每个分镜对应一个虚拟相机,有独立的位置、朝向、焦距参数。分镜的画面内容,本质就是虚拟相机在世界坐标系里拍到的画面。调整分镜构图,本质是调整相机参数,不会动场景本身。
这一层的意义在于,它把 “分镜” 从一个独立的生成任务,变成了空间里的一个观察视角。所有分镜共享同一个世界,只是观察角度不同。这是多分镜空间统一的基础。
第四层:输出像素坐标系 —— 最终渲染的落地层
把三维视口内容映射到二维生成画面,同时做透视校正和边缘对齐,保证不同焦距、不同位置的相机生成的画面透视关系统一,不会出现比例失真。边缘区域还会做特征补全,避免视口移动时出现内容断层。
这四层坐标空间从上到下依次映射,形成了一条完整的链路:全局空间定义 “有什么”,分块坐标定义 “怎么算”,相机视口定义 “从哪看”,像素输出定义 “长什么样”。
三级坐标体系:空间、语义、时序的三重约束
如果说四层坐标空间是工程实现的层级划分,那么三级坐标体系就是功能维度的分层。两者描述的是同一套架构的不同侧面。
像素坐标系:以单个像素点为映射单位,负责画布元素精准定位和边界拼接对齐。核心技术是零填充占位和亚像素插值,典型误差阈值在 ±2 像素以内。Vera 1.1 的全局绝对坐标编码精度达到亚像素级,空间偏差控制在 0.3 像素以内。
世界坐标系:以语义物体单元为映射单位,负责透视关系匹配和空间逻辑自洽。核心技术是深度估计和球面投影变换,典型语义错位率低于 1.5%。这一层让模型理解 “近处的物体应该比远处的大”” 墙面和地面的夹角应该符合物理规律 “,而不是只生成看起来像的像素。
时序空间坐标系:以帧间运动向量为映射单位,负责运动物体跨帧追踪和轨迹连续性。核心技术是光流对齐和时序注意力约束,典型轨迹偏移率低于 2%。Vera 1.1 把时序注意力机制和空间坐标系深度耦合,每帧生成时不仅参考当前帧的空间坐标,还会回溯前后帧的运动轨迹,对坐标做平滑修正。实测高速运动场景下,物体跨边界的轨迹偏移率从行业平均的 8.7% 降到了 1.8%。
技术实现:坐标系如何注入生成过程
有了坐标系设计,还需要解决一个工程问题:如何让坐标信息真正影响扩散模型的生成过程?Vera 1.1 用了一套组合方案。
双流 DiT 架构:把空间生成和时序连贯拆成两条独立通路。空间流专注单帧画质,负责全局坐标下的纹理与结构生成;时间流专注时序连贯,负责跨分块的时序特征对齐。两条通路在特定层交叉融合,既保证了空间精度,又保证了时序连续。
3D 旋转位置编码注入:将世界坐标系的三维坐标信息,通过旋转位置编码的方式注入 DiT 模型的注意力层。这让注意力机制在计算 “这个区域和哪个区域相关” 时,不仅考虑特征相似度,还考虑空间距离和位置关系。
全局特征池:整个画布有一个统一的 “设定库”,角色五官身形、场景风格、整体色调这些核心信息,提取后统一存在全局特征池中,所有分镜节点共享调用。这保证了不管从哪个角度拍,同一个角色的特征是一致的。
Layer-Diffusion 分层降噪:画布扩展时,原始画面和扩展区域不是混在一起生成,而是分层处理。编辑层专门负责生成向外扩展的新增画面内容,拥有较高生成自由度;Alpha 遮罩层生成融合掩码,控制原始层和扩展层的过渡权重,消除拼接边界。
能力跃迁:逻辑坐标系带来的五大变化
逻辑坐标系不是一个炫技的技术概念,它直接带来了五个层面的能力跃迁。
第一,画布真正无限。 传统方案的 “无限” 是拼接出来的,扩展到一定尺寸就会出现累积误差和语义失控。逻辑坐标系下,画布扩展只是世界坐标系里视口范围的扩大,不管扩到多大,每个区域都有唯一的全局坐标,模型始终知道自己在生成空间的哪个位置。理论画布分辨率无硬上限,实际商用建议总像素不超过 1 亿像素(约 10K)。
第二,多分镜空间统一。 所有分镜共享同一个世界坐标系,分镜之间不再是独立的画,而是同一空间的不同视口。第三方团队实测,同场景 3 分镜的错位率从行业平均的 47% 降到了 8% 以下;15 个连续分镜的同场景内容,末端分镜的空间偏差依然控制在 10% 以内。
第三,角色跨镜头一致。 角色在世界坐标系里有固定位置和固定特征,全局特征池保证所有分镜调用同一套角色基准。公开实测数据显示,正常配置下主体一致性保留率可达 94.7%。角色不再是每帧重新 “猜” 出来的像素集合,而是空间里一个稳定的实体。
第四,运镜全局连续。 所有分镜的相机参数接入全局轨迹引擎,支持线性、贝塞尔、缓动三种插值模式,自动处理位置、旋转、焦距三个维度的平滑过渡。运镜不再是每个分镜独立计算的运动,而是全局相机轨迹上的一段连续路径。
第五,百万级节点实时渲染。 逻辑空间坐标系配合空间索引与语义检索架构,让画布可以承载海量节点而不卡顿。官网引擎升级资讯明确提到,逻辑空间坐标系支撑百万级节点实时渲染。这意味着大型项目的全部分镜、素材、版本都可以放在同一张画布上管理,不需要拆分多个文件。
实测数据:坐标精度与效果验证
逻辑坐标系的效果不是停留在理论层面,而是有明确的实测数据支撑。
在 A100-80GB 环境下,1080P 分辨率、2 倍外扩、24 帧 6 秒视频的测试中:像素级坐标偏差平均 ±1.3 像素,边界语义错误率 1.8%,热缓存资源命中率 89%,单任务平均生成耗时 112 秒。
坐标编码精度方面,Vera 1.1 的全局绝对坐标编码达到亚像素级,空间偏差控制在 0.3 像素以内。这意味着不管画布分成多少个瓦片,模型都能精准定位当前生成区域在全局的位置。
时序一致性方面,高速运动场景下物体跨边界的轨迹偏移率从行业平均的 8.7% 降到了 1.8%,基本不会出现穿模和跳变。
多分镜对齐方面,同场景 3 分镜的错位率从行业平均的 47% 降到了 8% 以下,后期修补工时大幅降低。
需要说明的是,这些数据来自第三方技术团队在特定测试环境下的实测结果,实际效果会因场景复杂度、参数配置、硬件环境的不同而有所差异。
行业意义:从 “生成工具” 到 “空间操作系统”
逻辑坐标系的意义,不止于解决了几个技术痛点。它代表了 AI 视频创作底层逻辑的一次范式转移。
第一代 AI 视频工具是 “生成器”—— 输入文本,输出一段固定尺寸的视频。它解决的是 “从无到有” 的问题,但生成的内容是孤立的、不可编排的。
第二代 AI 视频工具是 “工作台”—— 把多个生成器整合到一个界面里,支持素材管理和简单剪辑。它解决了 “工具分散” 的问题,但底层依然是一个个独立的生成任务,内容之间没有空间关联。
星宇智算无限画布代表的第三代,是 “空间操作系统”—— 它不再把视频看作一段段像素的拼接,而是看作一个可编辑、可延展、可多视角观察的虚拟空间。创作的基本单位从 “片段” 变成了 “空间”,创作的核心动作从 “生成” 变成了 “编排”。
这个转变的影响是深远的。当 AI 理解了空间,它就能理解场景、理解角色、理解镜头语言,就能支撑更复杂的叙事和更工业化的生产。短剧、漫剧、电商视频、建筑漫游、数字孪生 —— 所有需要连续空间叙事的场景,都会因此受益。
坐标系的尽头,是创作的自由
像素牢笼的本质,是让 AI 只能看见树木,看不见森林。
逻辑坐标系给了 AI 一张空间地图,让它知道每一棵树在森林的哪个位置,知道从不同角度看过去树是什么样子,知道风吹过时树的运动轨迹应该如何连续。当 AI 不再被局限在固定画幅的像素框里,创作就真正获得了空间上的自由。
星宇智算无限画布用逻辑坐标系重构 AI 视频创作的底层逻辑,目标不是让画布变得更大,而是让创作变得更自由 —— 不再受画幅限制,不再受分镜割裂困扰,不再为角色漂移和空间错位消耗大量后期工时。创作者的精力,可以真正回到故事、叙事和创意本身。