私有化部署包完成昇腾全链路适配,国产算力交付再下一城
日前,星宇智算宣布私有化部署包完成新一轮重大迭代:华为昇腾 AI 算力底座全链路适配与兼容性调优正式通过内部验收。这意味着客户可在昇腾 910 系列服务器上,一键部署星宇智算的完整 AI 能力 —— 包括智能创作平台与无限画布工作区,全流程数据不出内网。
对于政务、金融、央国企、先进制造等对数据主权有硬性要求的客户,这一版部署包解决的是最实际的问题:能力一个不缺地搬进国产机房。
为什么国产算力适配,是私有化交付最难的一道坎
私有化客户的需求通常有两条硬约束:数据不出域、算力走信创目录。第一条靠部署形态解决,第二条才是真正的工程深水区。
很多团队对国产适配的理解停留在 “换张显卡”。实际上,从英伟达 GPU 迁移到昇腾 NPU,替换的是一整套软件生态:底层从 CUDA 变成 CANN,框架要接入 torch_npu 适配层,推理引擎要换成昇腾版本,注意力算子、显存管理、多卡通信全部要重新对接。模型在一台机器上 “能跑起来” 和在客户机房里 “稳定可交付”,中间隔着整整一条链路的验证工作。
星宇智算这一版部署包的目标,正是把这条链路从头到尾跑通、固化、产品化。
“全链路” 覆盖了哪六层
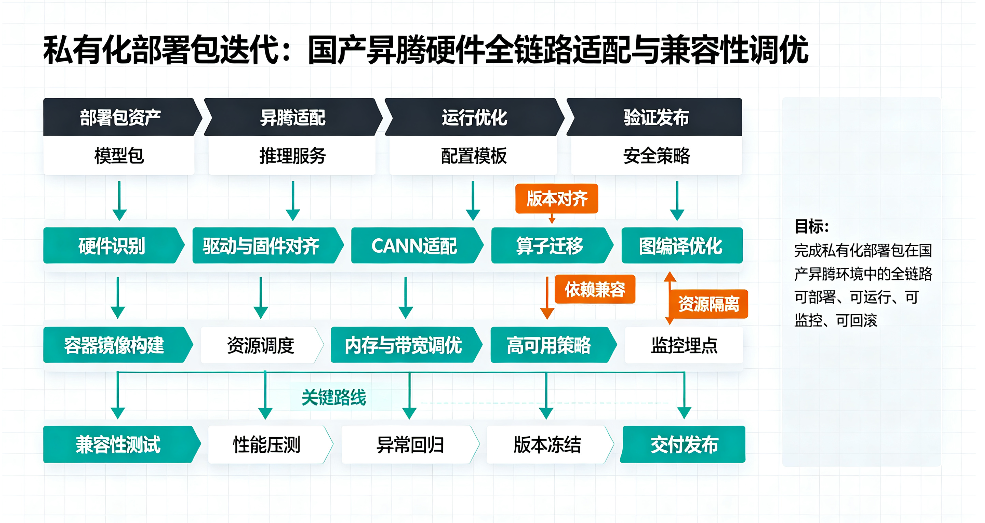
本次适配不是单点兼容,而是从硬件到应用的六层全栈打通:
| 层级 | 适配内容 |
|---|---|
| 硬件固件层 | 昇腾 910 系列 NPU、Atlas 800T A2 训练 / 推理服务器,HDK 固件与驱动版本基线锁定 |
| 系统软件层 | CANN 异构计算架构全套依赖,运行环境变量、加速库(NNAL/ATB)随包内置 |
| 框架适配层 | torch_npu 接入,标准 PyTorch 代码设备无关化,算子自动映射与差异化分流 |
| 推理引擎层 | 对接昇腾版推理引擎,完成 Attention 后端热替换、KV Cache 结构适配与连续批处理 |
| 模型层 | 权重格式转换、BF16 与 INT8 混合精度量化、量化校准与双端精度比对 |
| 服务运维层 | 全容器化离线镜像、OpenAI 兼容接口保持不变、NPU 资源监控接入运维面板 |
关键点在于:上层业务代码零改动。客户原有调用方式、接口协议、工作流配置全部保留,切换的只是底层算力。
兼容性调优,啃的是这几块硬骨头
全链路里最耗时的不是开发,而是调优和排雷。本次迭代重点解决了四类典型问题。
其一,算子兼容。 昇腾生态的算子覆盖仍在持续完善中,部分非标准算子和特定融合算子存在缺失或行为差异。团队对缺失算子做了映射替换与自定义补齐,并对注意力计算路径做了专项适配 —— 这是视频生成、长上下文推理等场景的性能命门。
其二,版本锁定。 昇腾软件栈对版本匹配极为敏感:驱动、CANN、torch_npu、推理引擎、加速库之间存在严格的版本依赖,任何一个组件错位都可能导致底层符号加载失败。部署包内置了经过完整回归测试的版本矩阵,全部依赖随镜像冻结,从根上杜绝现场 “装到一半报错”。
其三,精度对齐。 迁移到 NPU 后,模型输出必须与原 GPU 环境逐项比对。团队搭建了双端对比流水线,用固定校准集校验量化前后的输出差异,混合精度方案按模型分层配置,确保生成质量不因换硬件而打折。
其四,显存与多卡。 昇腾不同卡型的 HBM 规格差异直接影响可承载的模型规模与并发数。部署包加入了机型自动识别能力,按显存规格动态配置 KV Cache 上限与并行策略;8 卡机型的卡间通信参数也做了针对性调优。
(注:各机型吞吐、并发与精度指标以客户现场 POC 实测为准,官方将在兼容性清单中公布分机型测试数据。)
交付形态:无外网环境下的 “开箱即用”
私有化客户的机房往往是纯内网环境,无法在线拉取镜像、安装依赖。这一版部署包按 “断网可交付” 标准构建:
- 全量离线介质:镜像、模型权重、驱动依赖、量化工具一次打包,不依赖任何公网资源;
- 环境自检前置:安装前自动扫描硬件型号、驱动固件版本、显存与网络拓扑,不满足基线直接给出明确处置项;
- 一键部署与验收清单:部署完成自动跑通冒烟测试与精度抽验,交付结果可逐项核对;
- 统一升级通道:后续模型更新与安全补丁以离线增量包形式交付,避免私有化系统 “装上即冻结”。
无限画布,完整搬进客户机房
本次国产适配不是只有推理后端,星宇智算的核心产品体验 ——无限画布—— 在私有化环境中完整保留。
客户的创作团队可以在同一张无限画布上完成素材组织、角色资产管理、分镜编排、批量生成与结果校验,所有数据在内网闭环。同时,运维人员无需切换工具,即可在工作区内直接查看 NPU 利用率、显存占用与任务队列,让算力状态和创作流程处于同一个界面。
对有保密要求的影视、广告与企业宣传团队而言,这意味着既能用上完整的 AI 创作流水线,又不触碰任何数据外发风险。
说清楚边界,比喊口号更重要
需要客观指出的是,国产算力适配不是 “完成即终点”。
第一,昇腾生态在长尾算子覆盖和最新开源模型的首发适配上,与成熟 GPU 生态仍有时间差,新模型上架需要固定的适配周期,部署包按季度节奏滚动更新。
第二,客户现场硬件碎片化现实存在 —— 不同采购批次的卡型、显存规格、固件版本各不相同,适配能力以官方发布的兼容机型清单为准,清单之外的机型需要专项验证。
第三,版本锁定是双刃剑:它保证了稳定性,也意味着客户不能自行随意升级 CANN 或驱动,需要跟随厂商验证后的版本节奏,这要求双方在交付前就明确长期维护责任。
国产化替代的真正门槛,从来不在发布通稿里,而在客户机房的第一轮压测中。
把每一层跑稳,才算真正落地
从一块芯片到一套可交付的产品,中间隔着固件、算子、引擎、量化、服务、运维六道关。星宇智算私有化部署包这一版迭代,做的就是把六道关全部变成标准化、可复制的交付动作。
国产算力的价值,不在口号里,在每一个稳定运行的私有化现场。