短剧、漫剧正站在「AI 工业化」的拐点上:市场突破千亿、产能竞赛开打,角色一致性却成为多数团队跨不过去的坎。两年来的工程复盘给出一个越来越清晰的结论——LoRA 是当下性价比最高的解法,但真正拉开差距的,不是「会不会训 LoRA」,而是「能不能把调参变成可复现的工程」。本文从数据、参数、评估、部署四个层面,拆解 LoRA 训练在短剧漫剧场景下的工程化路径,并给出可直接落地的参数经验。
一、拐点已至:短剧漫剧进入「AI 工业化」时代
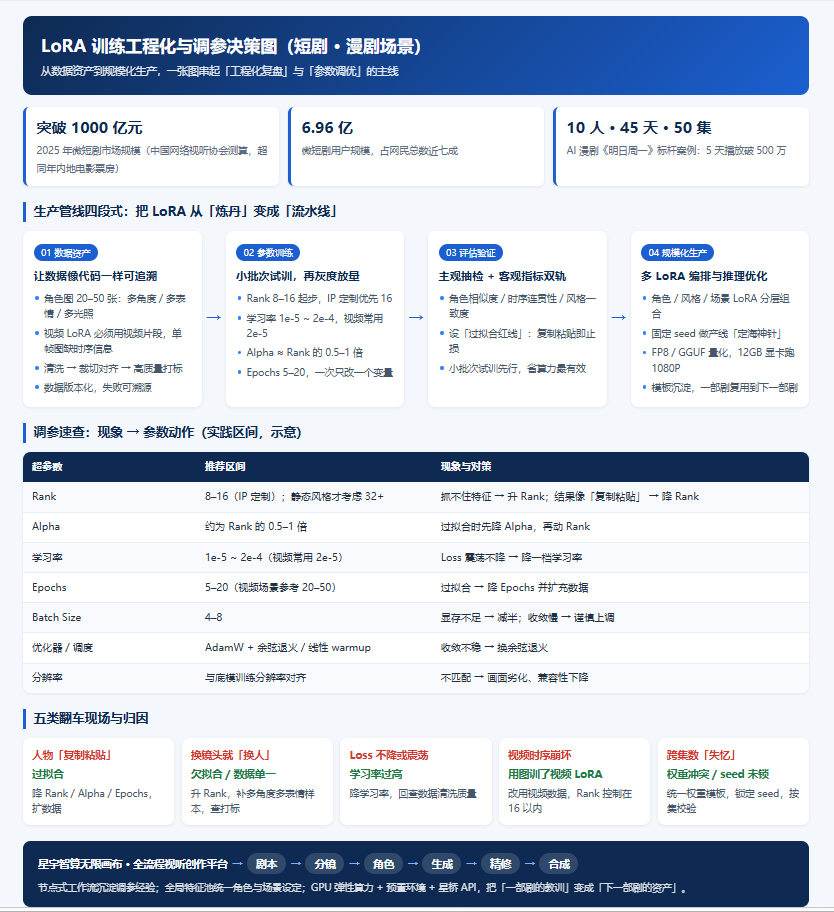
数字会说话。据中国网络视听协会测算,2025 年微短剧市场规模突破 1000 亿元,超过同年内地电影票房(518.32 亿元),用户规模达 6.96 亿——微短剧已成为网络视听行业第三大支柱。市场变大,产能压力同步变大:2024 年各平台累计上线微短剧超 3 万部,内容供给进入「量大管饱」之后的淘汰赛。
AI 正在改写这场竞赛的规则。国产 AI 视频工具快速成熟,一批标杆案例浮出水面:国内首部 AI 生成 50 集漫剧《明日周一》,10 人团队 45 天完成制作,上线 5 天播放量破 500 万;杭州铭兴映画用 AI 重塑生产线,《被堂哥坑后,我开鲜肉店暴富》24 小时全网播放量突破 2 亿;央视网报道的多部 AI 真人短剧累计播放量破 2 亿次。
产能上去了,新问题随之暴露:真人演员会记住自己的人设,AI 不会。同一角色在不同分镜、不同集数里「换脸」「串脸」,是 AI 短剧漫剧最大的技术痛点,也是决定一部剧能不能成片的核心变量。
二、为什么是 LoRA:全量微调太贵,提示词不够稳
解决「角色记忆」有三条路,工程实践把答案指向了 LoRA。
**全量微调(Full Fine-tuning)**效果最好,但成本惊人:动辄数十 GB 显存、大规模数据、昂贵算力,且每换一个角色就要重训一次底模,迭代周期以周计,短剧「日更」的节奏等不起。
纯提示词 + ControlNet + 参考图路线够快,但只能「约束」角色,无法「记住」角色。IP-Adapter、Reference 能稳住单镜头相似度,跨镜头、跨集数、跨场景时仍会漂移。
**LoRA(Low-Rank Adaptation,低秩适配)**站在中间:把「角色记忆」压缩进几十到几百 MB 的小权重包,可插拔、可组合、可版本管理;训练显存门槛低至消费级显卡,8–12GB 即可起步;角色、风格、场景拆成多个 LoRA,随用随挂。对短剧漫剧「多角色、多风格、长序列、快迭代」的生产特征,LoRA 几乎是量身定做。
但低门槛不等于低风险。把 LoRA 从「能用」做到「稳定」,靠的不是玄学,而是数据、参数、评估、部署四件事的工程化。
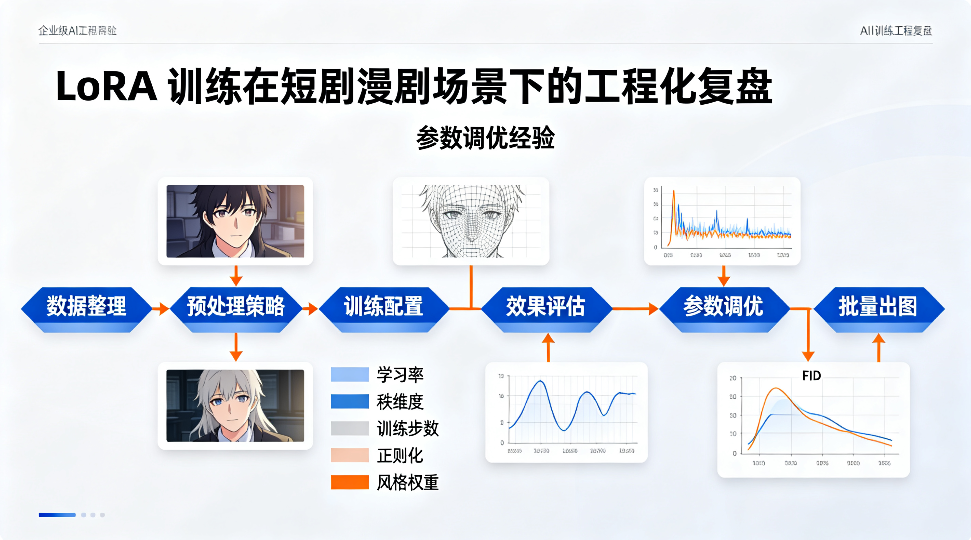
三、工程化复盘:从「炼丹」到「生产线」的四道坎
复盘一线项目,最容易翻车的往往不是训练本身,而是训练之前和之后。
第一道坎:数据资产化。 角色 LoRA 的数据下限是 20–50 张高质量图,必须覆盖多角度、多表情、多光照;视频 LoRA 则必须用含运动信息的视频片段,单帧图片缺少时序信息,训出的权重在成片上会「一眼假」。数据进入训练前要做三件事:清洗(剔除模糊帧、重复帧、遮挡帧)、裁切对齐(人脸/主体统一构图)、高质量打标(caption 质量直接决定 LoRA 上限)。最后,数据要像代码一样做版本管理——一次失败的训练,首先要能追溯用的是哪版数据。
第二道坎:训练流程化。 先小批次试训、再放量,是省算力最有效的手段;所有参数、seed、日志进配置文件而非「手调」,训练才具备可复现性。
第三道坎:评估指标化。 主观抽检之外,建立客观指标:角色相似度、时序连贯性、风格一致度;同时设「过拟合红线」——当生成结果开始「复制粘贴」训练图,立即止损。
第四道坎:部署规模化。 多 LoRA 组合、权重融合、FP8/GGUF 量化降低显存占用(12GB 显卡也能跑 1080P 短视频)、固定 seed 兜底一致性——这些决定了 LoRA 是「一次性作品」还是「可复用资产」。
四、参数调优:一张表看懂关键超参数
| 超参数 | 推荐区间(实践口径) | 作用与影响 | 常见问题与对策 |
| Rank | 8–16(IP 定制推荐 16);静态风格才考虑 32+ | 决定 LoRA「容量」:越大特征越强,过拟合与时序下降风险越大 | 抓不住特征→升 Rank;像复制粘贴→降 Rank |
| Alpha | 约为 Rank 的 0.5–1 倍 | 控制注入强度,与 Rank 联动 | 过拟合时先降 Alpha |
| 学习率 | 1e-5–2e-4;视频模型常用 2e-5 | 决定收敛速度与稳定性 | Loss 震荡不降→降学习率 |
| Epochs | 5–20(图像);视频场景参考 20–50 | 数据遍历轮数,太少学不会、太多学过头 | 过拟合→降 Epochs 并增加数据 |
| Batch Size | 4–8 | 影响收敛与显存占用 | 显存不足→减半 |
| 优化器/调度 | AdamW + 余弦退火或线性 warmup | 收敛路径的主要决定者 | 收敛不稳→换余弦退火 |
| 分辨率 | 与底模训练分辨率对齐 | 影响细节与兼容性 | 不匹配→画面劣化 |
一句话经验:先 Rank、再学习率、最后动 Epochs;每次只改一个变量,其余全部锁死。
五、分阶段训练与多 LoRA 编排:让角色、风格、场景各司其职
短剧漫剧很少只训一个 LoRA,标准做法是拆:
- 角色 LoRA:锁身份(脸、身形、服装特征),一个角色一个包;
- 风格 LoRA:锁画风(日漫、国风、写实、Q 版),多剧复用;
- 场景/道具 LoRA:锁特定场景或标志性物件。
训练顺序上,先通用后专用,避免灾难性遗忘;推理时按权重融合(实践参考区间:角色 0.7–0.9、风格 0.5–0.7),并与 ControlNet(姿态)、IP-Adapter/参考图(兜底)组合使用——LoRA 负责「记住」,ControlNet 负责「摆姿」,参考图负责「保底」。固定 seed 是整条产线的「定海神针」,排查一致性问题时先查它。
六、失败复盘:五类翻车现场与归因
- 人物「复制粘贴」:过拟合典型症状。对策:降 Rank/Alpha/Epochs,扩数据。
- 角色「换个镜头就换人」:欠拟合或数据单一。对策:升 Rank,补多角度、多表情样本,检查打标质量。
- Loss 曲线不降或剧烈震荡:学习率过高或数据噪声大。对策:降学习率,回查数据清洗。
- 视频时序崩坏:用图像数据训了视频 LoRA,或 Rank 过大。对策:改用视频数据,Rank 控制在 16 以内。
- 换集数就「失忆」:多 LoRA 权重冲突或未固定 seed。对策:统一权重模板,锁定 seed,按集校验。
七、从「调参」到「生产线」:无限画布把经验装进流水线
调参经验只有沉淀成工具,才叫工程。星宇智算无限画布正是沿着这个思路,把 LoRA 训练与角色一致性从「单点能力」升级为「生产流水线」。
作为集 AI 剧本创作、多模态画布、3D 导演工作台与专业多轨视频剪辑于一体的全流程视听创作平台,无限画布把短剧漫剧生产拆成剧本、分镜、角色、生成、精修、合成等节点,创作者在可视化节点工作流中自由组合素材与 AI 功能——角色 LoRA、风格 LoRA 作为「角色节点」统一管理,全局特征池对角色与场景设定做集中锁定,从源头上压缩跨分镜漂移。剧本拆镜头、3D 构图预演、多模态生成在同一画布内闭环,无需跨软件搬运素材。
底层资源同样对齐生产需求:星宇智算提供 RTX 4090/5090 等 GPU 弹性算力与预置 AI 环境,训练任务可随时启停,避免硬件空转;星桥 API 兼容主流调用方式,模型与算力按需接入。换言之,一部剧踩过的坑、调好的参数、沉淀的节点模板,可以原样复制到下一部剧——这才是「经验资产化」的完整形态。
八、高频问题速答
Q:LoRA 训练需要多少数据? A:角色 LoRA 20–50 张高质量、多角度、多表情图片;视频 LoRA 必须用含运动信息的视频片段。
Q:Rank 到底选多大? A:从 8–16 起步;IP 定制场景优先 16;只有静态风格类需求才考虑 32 以上。
Q:学习率多少合适? A:图像 1e-4 起步,视频模型从 2e-5 起调;Loss 震荡就降一档。
Q:为什么总是过拟合? A:四查:数据量不足、Rank 过大、Alpha 过高、Epochs 太多——逐一排除。
Q:一个项目多个角色怎么训? A:每个角色独立角色 LoRA,共用一套风格 LoRA,推理时按权重融合。
参数会过期,管线不会
LoRA 的推荐参数会随底模换代而漂移,但「数据资产化—训练流程化—评估指标化—部署规模化」这条工程主线不会。把每一次训练都当作一次可复现的实验,把每一个踩过的坑都沉淀为节点模板,短剧漫剧的 AI 生产线才能从「作坊」走向「工厂」。星宇智算无限画布想做的,正是把这条主线变成人人都能上手的默认路径。