导语:排队要等多久、高峰会不会堵,是算力平台的两道必答题。近期,星宇智算算力平台完成调度体系升级:新增任务优先级调度,并对大模型推理资源实施智能分配。典型落地场景 Vera 1.1 推理引擎,峰值并发下任务平均等待时长从 18 分钟以上压到 45 秒以内。算力供给的竞争,正从”堆硬件”转向”拼调度”。
01 推理算力的两大难题:闲置与拥堵并存
大模型推理是典型的重算力、长耗时业务。以文生视频为例,单条 512P 分辨率、16 帧的推理就要 20-60 秒,单卡并发能力有限。行业数据显示,国内主流 AI 视频平台平均 GPU 利用率仅 35%-45%;算力租赁集群在静态分配下,利用率也长期徘徊在 40%-55%。
一边是大量算力闲置在任务切换、显存加载、等待调度的间隙里;一边是高峰时段任务堆积、响应超时。工作日高峰流量可达凌晨时段的 8-10 倍,固定算力配置两头吃亏:高峰不够用,低谷全空转。
更麻烦的是推理任务的”脾气”:不同规格任务耗时差可超 10 倍,简单排队会让短任务被长任务拖死;显存需求从 8GB 到 60GB 不等,碎片显存很难利用;推理过程一旦启动不可中断。这些难点靠人工排班、静态分配都解不了,必须交给调度系统。
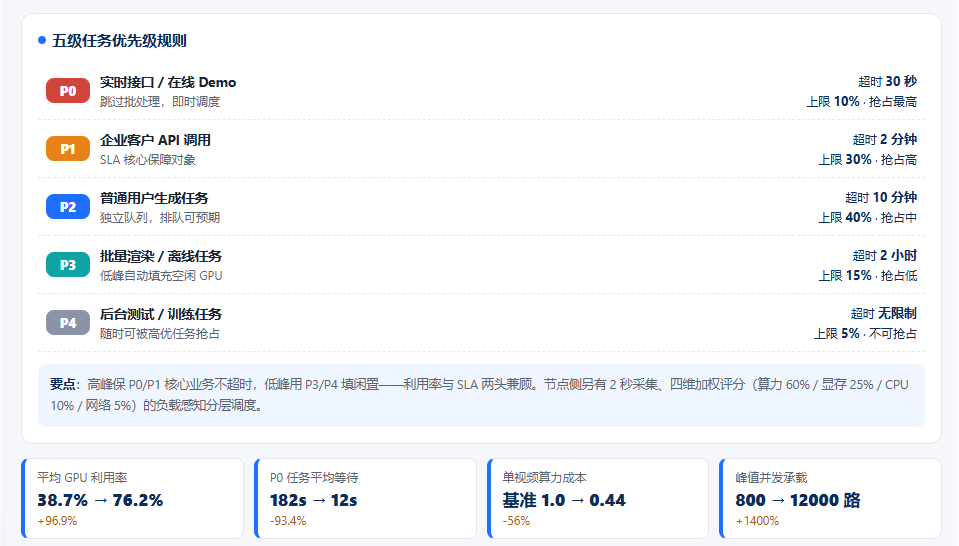
02 核心升级:五级任务优先级,告别”先来后到”
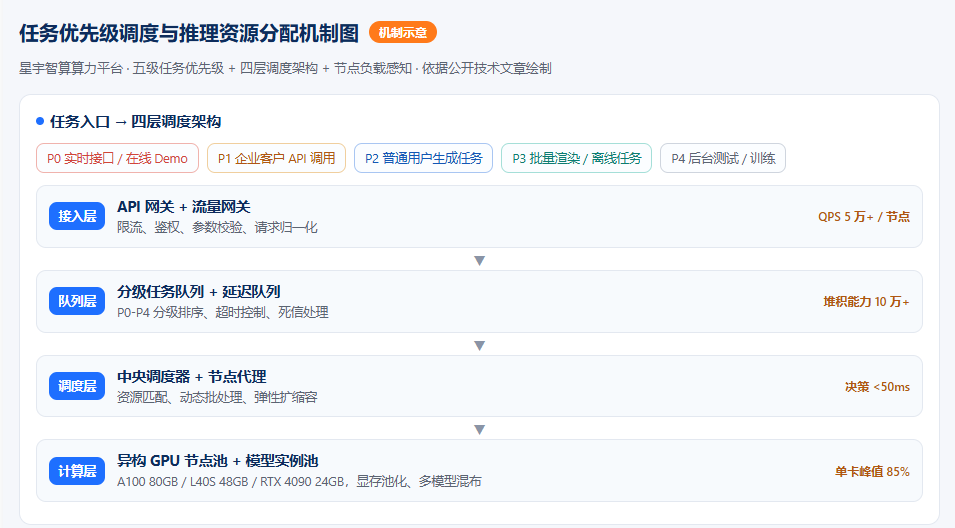
新调度体系把任务按业务价值分为 P0-P4 五级,每级对应独立队列、超时阈值与资源抢占权限:
| 优先级 | 典型场景 | 超时阈值 | 队列占比上限 |
| P0 | 实时接口、在线 Demo | 30 秒 | 10% |
| P1 | 企业客户 API 调用 | 2 分钟 | 30% |
| P2 | 普通用户生成任务 | 10 分钟 | 40% |
| P3 | 批量渲染、离线任务 | 2 小时 | 15% |
| P4 | 后台测试、训练任务 | 无限制 | 5% |
分级的意义不是”谁付费谁插队”,而是保 SLA、填闲置两头兼顾:高峰时高优先级任务可抢占资源,核心业务不超时;低峰时 P3、P4 任务自动填充空闲 GPU,算力不空转。
03 推理资源怎么”智能分配”:四层架构 + 四个机制
调度系统采用”接入层 → 队列层 → 调度层 → 计算层”四层架构,各层解耦、独立扩容。接入层网关负责限流鉴权(单节点 QPS 5 万+),队列层承接分级排序与超时控制,调度层做资源匹配与任务分发(决策延迟 <50ms),计算层管理异构 GPU 池。
资源分配落到四个机制上:
- 动态批处理:按 200ms 时间窗口收集同类任务,按显存余量自动组批、跨用户归并。单卡推理吞吐提升 60%-80%,单任务算力成本下降约 42%;P0 实时任务自动跳过批处理,即时调度。
- 显存池化与模型热加载:高频模型常驻显存,冷启动零加载;按调用频率分 L1/L2/L3 三级缓存,常用模型加载速度提升 3 倍,任务结束自动整理显存碎片。
- 算力亲和度调度:任务按显存敏感、算力敏感、吞吐敏感打标签,节点按 A100 80GB、L40S 48GB、RTX 4090 24GB 打标签,按需匹配。高分辨率长视频上大显存卡,短片段批量任务上性价比卡。平均执行耗时下降 18%,大显存卡溢出率从 12% 降到 1.5% 以下。
- 弹性伸缩与混部:分钟级容器扩缩容应对流量脉冲,小时级对接算力池应对长周期波动;在线推理与离线渲染错峰混部。单节点 GPU 利用率从 42% 提到 76%。
04 底座协同:节点级负载感知,算力平台同步升级
任务级调度之外,算力平台节点侧同步完成分层调度改造:数据采集层每 2 秒拉取 GPU 利用率、显存占用、CPU 负载、网络带宽四项指标;指标计算层按”算力 60%、显存 25%、CPU 10%、网络 5%”的权重输出节点实时评分;任务分发层把负载最低的节点优先派给新任务,高优先级任务绑定高规格节点,低优先级任务填充碎片算力。
配套落地三招盘活闲置资源:碎片算力聚合——把低负载节点的空闲 vGPU 分区聚起来,承接轻量推理、批量预处理;错峰任务调度——数据清洗、模型预编译挪到业务低峰期运行;资源动态缩扩——高峰期集中算力保核心租户,低峰期合并节点、关停冗余实例,减少空载能耗。
05 效果说话:一组生产环境数据
升级效果以公开技术文章披露的生产环境数据为准(口径见文末):
| 指标 | 优化前 | 优化后 | 变化 |
| 平均 GPU 利用率 | 38.7% | 76.2% | +96.9% |
| 单卡日产出视频数 | 128 条 | 283 条 | +121.1% |
| P0 任务平均等待 | 182 秒 | 12 秒 | -93.4% |
| P2 任务平均等待 | 1080 秒 | 42 秒 | -96.1% |
| 单视频平均算力成本 | 基准 1.0 | 0.44 | -56% |
| 峰值并发承载 | 800 路 | 12000 路 | +1400% |
| 服务可用性 SLA | 99.5% | 99.95% | 故障时长减少 90% |
节点集群侧同样可量化:200 台混合算力节点、30 天实测,集群平均利用率从 49% 提到 77%,闲置节点占比从 38% 降到 11%,任务平均响应延迟从 186ms 降到 102ms,单节点日均能耗下降 19.9%。
06 对谁有用:三种场景,一个共同答案
- 企业客户:调用 API 跑实时业务,优先级保障叠加 99.9% SLA 服务承诺,高峰期不再看运气。
- 创作者与个人开发者:普通生成任务有独立队列,高峰期排队有明确等待预期,不用干等”转圈”。
- 批量生产团队:渲染、预处理等离线任务自动填充低价时段,单位成本明显下探。
调度升级的直接受益者,还有星宇智算旗舰推理引擎 Vera 1.1。作为双流 DiT 架构的企业级文生视频引擎,Vera 1.1 承载了平台 SaaS 与 API 的全部在线推理流量,本次五级优先级与智能分配机制,正是围绕 Vera 1.1 推理链路完成的三轮架构迭代。对使用 Vera 1.1 的企业客户,平台还支持调度系统私有化部署,数据不出域,调度策略按业务定制。
07 你可能想问
Q:单张 A100 能带多少并发? 标准任务(512×768、16 帧、30 步采样)在动态批处理下单卡可同时处理 4-6 路,日产出约 280-320 条。分辨率越低、帧数越少,并发越高。
Q:动态批处理会不会拖慢我的任务? 时间窗口默认 200ms、最长 500ms,相对数十秒的推理总耗时几乎无感;P0 实时任务会直接跳过批处理,走即时调度。
Q:混合品牌 GPU 能一起调度吗? 能。调度器基于标签体系匹配任务与节点,不绑定显卡型号,A100、L40S、RTX 4090 等异构卡可共池调度,自动把任务派到更合适的硬件上。
算力不空转,推理不等队
调度升级的意义,不在把某一块 GPU 跑满,而在用最低的成本满足业务 SLA。分配更聪明,算力才真正值钱。