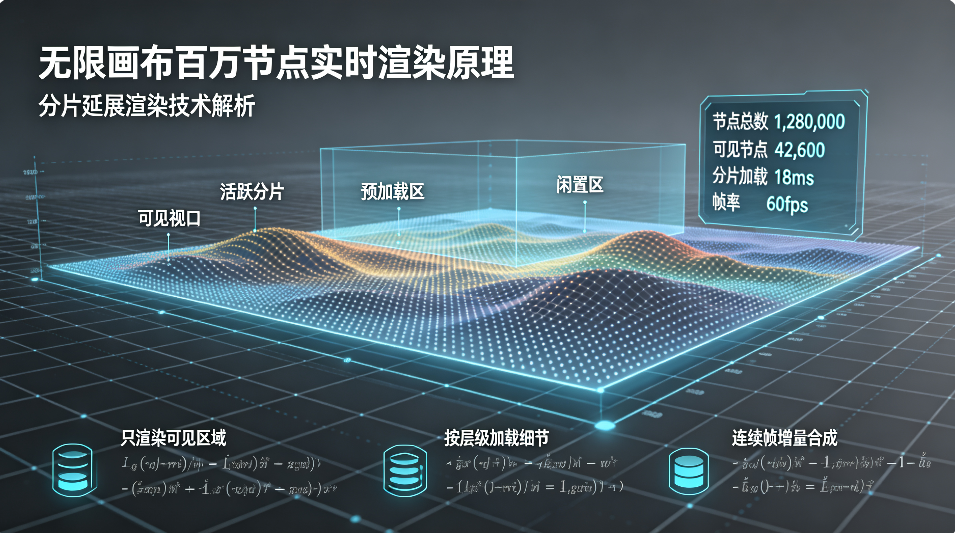
“画布能拉多大”,正在成为AI视频创作者判断工具上限的新标尺。9月初,星宇智算发布无限画布引擎升级,宣布支持百万级节点实时渲染,官方将底层支撑归纳为渲染性能升级、数据增量同步、资源流式调度、交互体验优化四项关键技术。本文聚焦其中的底层逻辑——分片延展渲染,拆解”超大画幅为什么跑得动”。
需求先于技术:画幅焦虑已经来了
先看需求端。据DataEye研究院《2026上半年AI剧漫剧数据报告》,2026年前5个月国内AI剧漫剧市场规模达220亿元,全年有望突破400亿元,同比增长138%;中国网络视听协会数据显示,2026年一季度全行业上线微短剧12.8万部,其中AI制作占95%以上。产能爆发的同时,创作形态也在变:超宽幅企业宣传片、竖转横的扩展画面、横向长镜头漫剧,从16:9拉到21:9、32:9甚至更长,成了刚需。
需求端拉满,技术端却撞上一堵墙——显存墙。扩散模型的显存占用与分辨率不是线性关系:据华为云开发者社区公开实测,1080P单卡能跑的生成任务,拉到4K后显存需求直接翻4倍以上,全图推理的峰值显存约68GB,消费级显卡单卡无法运行。
分片不是新概念,难在”接了不露痕”
分片渲染在行业里并不陌生。移动端GPU从诞生起就走tile-based rendering路线,把屏幕切成小块逐个处理;地图应用用256×256瓦片按需加载,支撑起Google Maps、DeepZoom的亿级像素体验;前端海量数据渲染同样靠瓦片化+可视区裁剪。这套思路的共性一句话:不碰不需要的部分,只算看得见的区域。
但AI视频生成的分片,难度高了一个量级。画面切块谁都会,切完之后呢?据华为云开发者社区对”固定分块+简单拼接”方案的实测,4K画幅拼接处色差ΔE高达12.3,主体一致性仅82.1%——明暗断层、物体错位,修起来比重做还费时间。更棘手的是时序:空间分块之后,不同块的时序误差各自累积,画面会出现”这块动得快、那块动得慢”的不同步。
原理一:自适应空间分块,不是平均切
星宇智算Vera 1.1的分块生成架构,从模型推理层就做了分块原生设计,而非”生成后拼接”。据华为云开发者社区技术拆解,空间分块遵循三条动态规则:
- 基础分块粒度默认1024×1024像素单元,支持512-2048区间动态调整;
- 重叠区域占比默认15%-25%,画面元素越复杂,重叠比例越高;
- 遇到人物、LOGO等核心主体时自动偏移分块边界,避免关键主体被切割。
简单场景用大块提速,复杂场景用小块加重叠保一致性——这是固定分块方案给不了的自适应能力。
原理二:时序分片联动,二维切片
无限画布不只做空间分块,时序维度同样分片。Vera 1.1采用”空间分块+时序分片”的二维切片方案:每个推理单元是”空间块+时间片”的组合,与双流DiT的时序注意力窗口天然对齐。默认时序分片16帧、片间保留4帧重叠帧做特征衔接、每8个分片做一次全图特征校准——从根源上防止长视频的累积偏差。
原理三:重叠区特征缓存与融合
这是消除拼接痕的核心。每个分块推理时,把重叠区域的特征向量(FP16精度,非原始像素)存入全局缓存池;相邻分块推理时主动读取邻块特征作为硬约束,融合权重从重叠区中心向两侧平滑过渡,并自动做色差校验。实测下,拼接处色差ΔE可控制在2-3以内,人眼基本无法识别。推理全程还维护一个全局特征锚点:首帧提取的语义、色彩、主体特征,作为所有分块的统一”审美标准”,避免”这块偏冷、那块偏暖”。
数据说话:单卡跑超宽幅,显存增长近线性
据华为云开发者社区在RTX 4090 24GB单卡、24fps条件下的压测对比:
| 生成方案 | 画幅尺寸 | 峰值显存 | 单帧耗时 | 拼接色差ΔE | 主体一致性 |
| 全图原生推理 | 1920×1080 | 18.7GB | 1.2s | – | 94.7% |
| 全图原生推理 | 3840×2160 | 68.2GB(单卡无法运行) | – | – | – |
| 固定分块+简单拼接 | 3840×2160 | 17.9GB | 4.8s | 12.3 | 82.1% |
| Vera 1.1分块生成 | 3840×2160 | 19.3GB | 5.1s | 2.1 | 93.8% |
| Vera 1.1分块生成 | 7680×2160(超宽幅) | 21.5GB | 9.7s | 2.3 | 92.5% |
三个关键结论:4K分块方案显存与1080P全图基本持平,单卡即可运行;超宽幅画幅横向翻一倍,显存仅增加约11%;分块生成的主体一致性仅比全图低0.9个百分点。火山引擎开发者社区的另一组实测同样印证:空间分块稀疏注意力一项,就能把注意力层峰值显存降低42%,4K场景下可降50%以上——4K无限画布比同分辨率固定画幅高约170%的显存压力,正是被这套组合拳压下来的。
从”生成”到”实时渲染”,四项技术缺一不可
分片延展渲染解决的是”生成侧”的超大画幅问题,而百万级节点的实时渲染,还需要运行侧配合。按星宇智算官方公告口径,引擎升级的完整支撑是四件事:渲染性能升级,让分块绘制与图层合成跑在毫秒级;数据增量同步,画布变化只同步增量节点,不整图重传;资源流式调度,按视口可见范围按需加载;交互体验优化,保证百万节点下的平移、缩放、连线依然跟手。生成侧的分片延展+运行侧的增量调度,共同构成”无限”二字的技术底座。
开箱即用:无限画布能力已全量开放
据星宇智算官方信息,Vera 1.1的无限画布能力已在AI视频工作台全量开放:支持9种主流画幅比例及自定义任意尺寸,可配合主体锚定、唇形同步、多语种配音使用,生成内容全链路商用版权合规,支持星桥API对接企业系统,星元按量计费。对不想自己调分块参数、搭显存环境的团队,网页端直接设置画幅尺寸即可生成。配套的GPU弹性算力池,则让”大画幅+大批量”的生产需求随时有卡可用。