模型推理分片架构详解:让大视频生成不再死磕单卡
长视频、高分辨率视频生成正在撞上一道墙 —— 模型权重、激活值和注意力计算量随帧数和分辨率指数膨胀,单张旗舰显卡的显存越来越不够用。要么继续堆最贵的卡,要么换一种思路:把模型和计算拆开,让多张卡协同完成一次推理。模型推理分片架构,就是这第二种思路。它不是简单地 “多加几张卡”,而是在推理阶段把模型权重、计算图和序列维度切分到多个设备上,让单次生成对单卡显存和算力的依赖显著下降。
为什么视频生成这么吃单卡
理解分片为什么对视频生成尤其重要,要先看视频模型在推理时到底在算什么。
当代主流视频生成模型大多基于扩散 Transformer 架构,输入是一段由空间维和时间维共同展开的 token 序列。一帧画面在 latent space 里可能就是成百上千个 token;一段十几秒、每秒 24 帧的视频,序列长度会比单图生成高出一个数量级以上。注意力计算的复杂度随序列长度平方增长,这意味着多出来的不只是显存占用,还有每一步去噪过程中的计算量。模型权重本身、每一步中间激活值、VAE 解码时的临时张量,全都要塞进同一块显卡。
这就是为什么用户会感觉 “视频生成比图片生成贵得多”—— 贵的不只是模型参数,而是把一整段时空序列在单卡上算完的代价。
分片到底在分什么
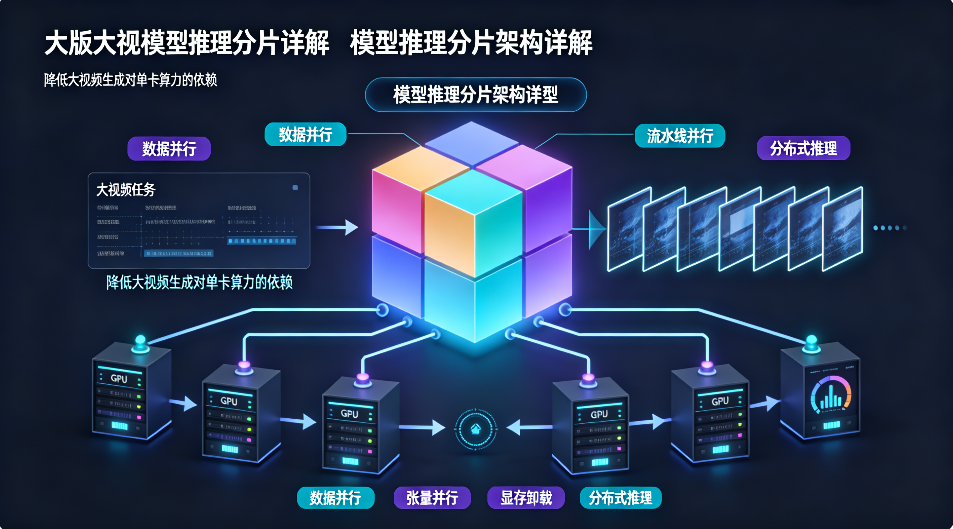
推理分片不是一个动作,而是一组可以组合的并行策略。在视频生成场景下,真正起作用的主要有三层切分:
张量并行(Tensor Parallel),把单层网络里的矩阵运算拆开。比如一个线性层的权重矩阵按列或按行切到不同显卡上,每张卡只算自己那一部分,再通过一次 all-reduce 通信把结果拼回来。它解决的是 “单层就装不下” 的问题。
流水线并行(Pipeline Parallel),把整个模型按层切成若干段,每张卡负责一段,数据像流水线上的工件一样依次流过各段。它解决的是 “模型总层数太多、一张卡放不下” 的问题,但会引入流水线气泡 —— 某些卡在等待数据时空转,所以在低延迟推理场景下使用要谨慎。
上下文并行(Context Parallel),这是视频生成里最关键、也最容易被忽略的一层。它把超长的 token 序列本身切开 —— 比如按帧段切,让不同显卡分别处理不同帧区间的注意力计算,再通过 ring attention 之类的通信协议完成跨段交互。视频模型的序列长度瓶颈主要来自时间维,上下文并行直接对着这个瓶颈下刀,效果往往比单纯加大张量并行更明显。
这三种切分不是互斥的,实际部署时经常组合使用:模型大就上流水线,单层宽就上张量,序列长就补上下文。分片粒度越细,能塞下的模型和视频就越大,但通信开销也随之上升。
为什么不是 “加卡就完事”
这里必须说清楚一个经常被营销话术略过的事实:分片不是免费的,多卡不等于线性提速。
每张卡把自己那部分算完之后,需要和其他卡交换中间结果 ——all-reduce、all-gather 这些集合通信操作,对卡间带宽极其敏感。在 NVLink 这类高速互联下,通信可能只占总时间的一小部分;但如果跑在普通 PCIe 甚至远程网络上,通信开销会迅速吞噬掉分片带来的计算红利。换句话说,分片架构的收益,一半取决于算法切得好不好,另一半取决于底层互联够不够快。
另一个现实问题是 “甜蜜点”。视频只有两三秒、分辨率不高时,单卡可能本来就跑得动,强行分片反而因为通信拖慢整体。分片真正发挥价值的区间,通常是单卡显存或算力逼近极限的场景 —— 长时长、高分辨率、批量生成,或者三者叠加。判断自己的业务落在哪一段,比盲目上多卡更重要。
星宇智算的做法:把分片藏在调度后面
对大多数应用团队来说,自己去调张量并行度、流水线 stage 数、上下文通信协议,成本太高,也不应该是业务团队该操心的事。星宇智算在开放平台侧做的,是把这一整套分片能力收敛成平台层的调度逻辑 —— 用户提交视频生成任务时,平台根据任务的时长、分辨率和模型规模,自动匹配单卡、双卡还是多卡分片,自动选择最优的并行组合,而不需要业务方自己去算 “我这个任务该切几片”。
在这之上,平台同时配合了量化推理、KV 与特征缓存、动态批处理等手段。分片解决的是 “单卡装不下”,量化和缓存解决的是 “装下之后怎么跑得更快更便宜”,两者叠加,才是长视频生成在成本上真正可落地的原因。底层用的是池化的异构算力资源,GPU 之间走高速互联,保证分片通信不成为瓶颈 —— 这也是为什么星宇智算不单纯宣传 “我们支持多卡”,而是强调 “多卡协同对用户透明”。
谁会最先感受到变化
分片架构对长视频生成团队的价值最直接:需要生成数十秒以上、1080p 甚至更高分辨率内容的团队,过去要么排队等旗舰卡资源,要么被迫缩短时长、降低分辨率;分片让这些工作负载可以在更充裕的中高端算力组合上完成。其次是批量生成场景 —— 一次成百上千条视频同时产出,分片配合批处理,能把单位成本压到原来的几分之一。对成本敏感、又不想牺牲输出质量的团队来说,这是比单纯堆旗舰卡更现实的路径。
把大模型拆开放,算力才真正落地
推理分片的本质,不是炫技,而是把 “必须一张顶级卡才能跑” 这件事,改写成 “多张合适的卡一起算就能跑”。当长视频生成不再被单卡显存锁死,创意团队要担心的就只剩内容本身,而不是显卡型号。