AI 视频正在从”单输入”走向”多路信号”。 字节的 Seedance 2.0 支持文字、图片、音频、视频四种模态混合输入;阿里的万相 3.0 单次可组合 10 张图、5 段视频、5 段音频,共 20 个素材参考;快手的 Kling 3.0 把多模态输入输出高度统一。模型开始”吃”越来越多的信号,一个问题随之而来:信号多了,画面、人物、环境三个特征域怎么统一表达、互不打架? 多路信号融合,指把文本、图像、视频、音频等多模态参考,在同一个生成管线内对齐、统一、互不污染的技术策略。它决定了一部 AI 视频能不能从头到尾”一个世界”:同一张脸、同一个场景、同一个调子。
01 一个正在发生的转向:模型开始”吃”多路信号
这不是某一家厂商的玩法,而是行业共识。
- Seedance 2.0(2026 年 2 月发布,豆包、即梦接入):支持文字、图片、音频、视频四模态混合输入,一次生成最多可参考 9 张图、3 段视频、3 段音频;
- 万相 3.0(2026 年 8 月全量上线):在图像、文本、音频、视频之外,首次支持文档与网页输入,单次最高组合 20 个素材参考,原生 30 秒、1080P、30fps;
- Kling 3.0(2026 年 2 月发布):多模态输入输出高度统一,支持视频、多图素材作为参考,4K、60fps 原生输出。
学术侧同步在推进。论文 MMControl(arXiv 2026 年 4 月)提出联合音视频生成的多模态控制方案:参考图、参考音频、深度图、姿态序列等视觉与声学信号,通过双流条件注入,进入同一个音视频 Diffusion Transformer。
多路信号,已经是新一代视频模型的标配能力。
02 信号多了,”打架”也多了:融合难在哪
输入变多,冲突同步变多。多路信号融合要过三道坎:
- 模态异构:图片是静态的、视频是动态的、音频是时序的,特征空间各不相同,怎么塞进同一条生成管线;
- 时空对齐:参考图定的是”长什么样”,参考视频定的是”怎么动”,两者既要同时生效,又不能互相覆盖;
- 特征污染:多路信号抢权重,权重失衡,人物漂移、场景跳变、色调闪变就一起冒出来。
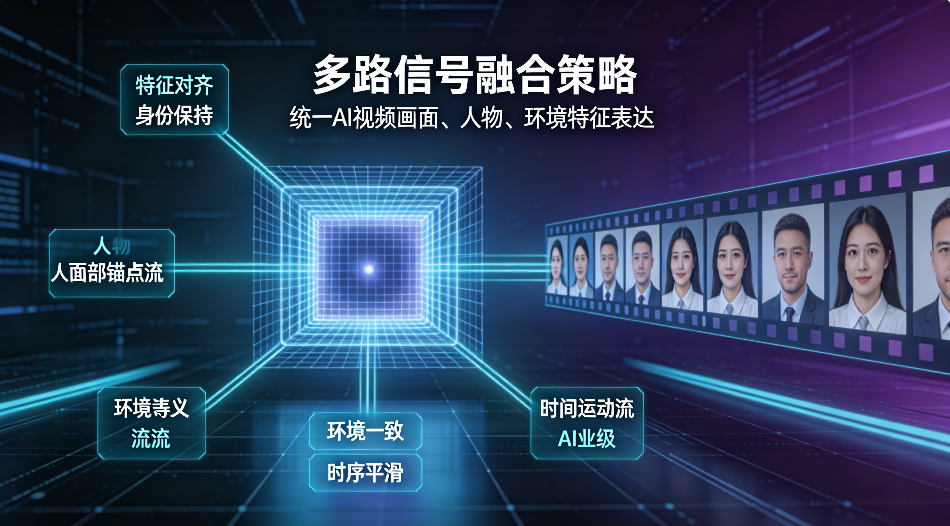
落到成片上,就是三个特征域的失控:画面不统一(构图、光影、色调跳变),人物不稳定(五官、服饰漂移),环境不连贯(场景风格断裂)。 融合策略的目标,就是把这三件事分别锁住,再统一表达。
03 统一画面特征:分层注入,别让单层”顾此失彼”
画面特征,指构图、光影、色调、纹理这些空间维度的东西。 统一它的关键是分层注入。如果所有参考信息都塞进同一层网络,浅层的构图光线和深层的语义内容会互相干扰。Vera1.1 的做法是三级图像注入架构:浅层注入负责继承构图、光线等视觉基底,中层负责场景结构,深层负责语义内容,各司其职。 多参考图层面同理。万相 3.0 的官方表述是”像素级一致性保持”,精准还原参考细节,面向生产力场景提升交付确定性——参考图越多,越需要分层承接,而不是一股脑叠加。 最后还有兜底:画布上做特征碰撞检测,相邻节点的光照、色调、风格冲突一旦超阈值,自动重算对应区域。
04 锁定人物特征:ID 靠缓存与锚定,不靠提示词
人物特征,指五官、身形、服饰、表情。这是 AI 视频翻车率高的区域。 单张参考图信息有限,角色一转身、一遮挡、表情一变,模型就只能”猜”,一猜就漂。提示词里写一百遍”保持同一张脸”,也不如让模型”记住”这张脸。 两条务实路径:
- 帧特征缓存层:把人物、商品的实体特征缓存下来,跨分片、跨节点复用,保证角色在不同镜头间不换脸;
- 滑动时序窗口:控制帧与帧之间的特征继承范围,抑制时序漂移——继承太远会跑偏,太近会僵硬,窗口长度是关键参数。
公开实测数据(星宇智算 Vera1.1 节点化方案):1 分钟视频的主体一致性保留率,从传统分段生成的 72%–81% 提到 94.7%,涵盖人物五官、服饰、身形三个维度。 ID 稳定不是玄学,是”特征被记住 + 帧间继承有界”。
05 稳定环境特征:全局特征池,让场景”一个调子”
环境特征,指场景风格、光照、色调、空间关系。它比人物更难察觉,崩了却更致命——观众不一定说得出哪里不对,但会明显感觉”跳戏”。 统一环境的思路是全局特征池:把角色五官身形、场景风格、整体色调统一存进一个池子,所有分镜共享。生成时,画面、人物、环境各自从池子里取特征,谁都不会跑偏。 空间层面再做锚定:无限画布用四层坐标体系(全局世界→分块→视口→像素)给每个分镜分配确定位置,多分镜在统一空间里做时序对齐——坐标系、特征锚定、轨迹插值三层配合,衔接处自动补光影和运镜过渡。 公开实测数据:跨分镜语义匹配度从 63% 提到 91.2%,综合场景、风格、光影三项评分。
06 从模型到生产:无限画布把”多路信号”变成”一条产线”
模型解决”会融合”,生产还要解决”管得住”。融合策略要落地,需要把多路信号变成可编排、可回溯、可协作的产线。
星宇智算无限画布的方案,是节点式工作流:
- 多路信号进:脚本、参考图、运镜、时长等作为输入,自动拆成分镜节点;
- 全局设定先定:每个节点共享同一个全局特征池,角色五官身形、场景风格、整体色调统一;
- 节点独立编排:每个节点可单独设置文案、参考图、运镜、时长,互不干扰;图生视频、文生视频、数字人、配音字幕、批量导出等节点自由拖拽组合;
- 全流程可回溯:每次生成的提示词、参数、参考图、坐标信息完整保存,版本一键回滚;
- 团队并行协作:编剧拆节点、原画传参考图进特征池、后期各自负责镜头,互不阻塞;
- 交付有保障:输出商用确权元数据,满足短剧、电商、短视频的合规交付要求。
落地数据(公开内测):3 分钟短剧单集制作周期从 7 天压到 3 天,团队人效提升 120%,后期拼接工时占比从 32% 降到 8%。配套的批量渲染调度模块与算力监控面板已于 9 月上线,把闲时算力填满——第三方机构统计,企业 GPU 平均利用率仅约 5%,调度空间巨大。
使用门槛方面,无限画布提供 SaaS 云端、API 调用、私有化部署三种形态,网页端即可使用,无需本地部署。
边界也要说清楚:自动拆镜负责结构,不负责审美,关键节点仍需人工锚定;超过 3 段连续拼接,建议主动清一次特征缓存,防止脏特征累积。
07 快问快答:高频疑问一次说清
Q:多路信号同时给,真的不会互相打架吗? A:会,所以才有分层注入、全局特征池、碰撞检测这套组合拳。信号各归其位,冲突交给机制兜底。
Q:参考图是不是越多越好? A:不是。万相 3.0 给了 20 个素材的上限,但更推荐按”角色、场景、风格”分域锁定,关键节点手动锚定参考图,避免权重打架。
Q:普通用户能用上这套能力吗? A:能。星宇智算 AI 视频工作台内置完整无限画布能力,网页端免部署,生成时自定义画幅即可。
Q:比单参考图强多少? A:公开实测口径:主体一致性保留率 72%–81% → 94.7%,跨分镜语义匹配度 63% → 91.2%。
多路信号,一个世界
输入在变多,标准也在变高。能生成一段视频只是起点,把画面、人物、环境统一成一个世界,才是 AI 视频真正进入生产的那道门槛。 多路信号融合给了方法,节点式画布给了落地。两者接上,创作才算真正跑起来。