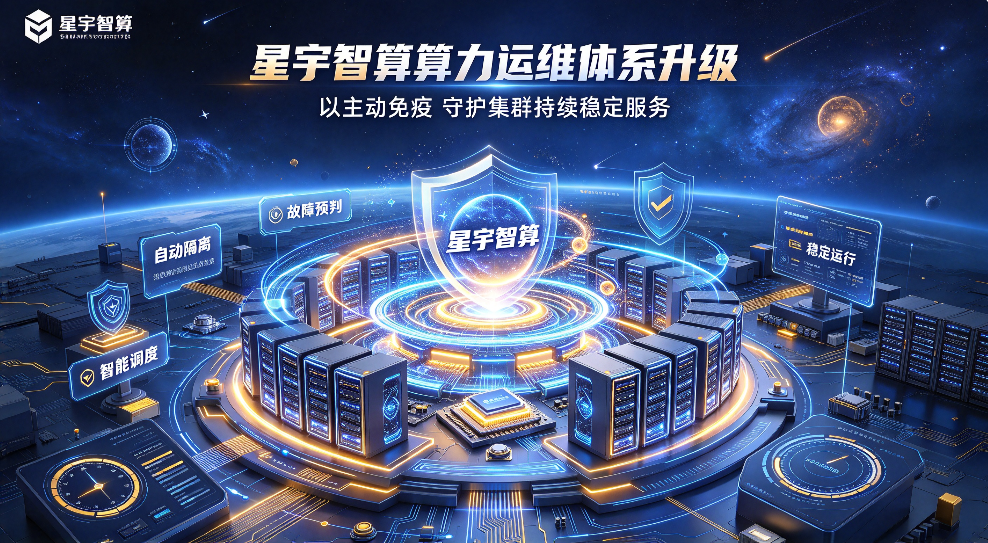
大模型训练、AI 应用规模化落地,让算力成为时代级基础设施;而集群规模越大,”稳定” 二字的分量越重。近日,星宇智算(StarverseAI)宣布完成算力运维体系升级,将运维逻辑从 “被动救火” 升级为 “主动免疫”,全面提升算力集群持续稳定服务能力。
算力狂奔,稳定成为新命题
算力基础设施正加速扩张。工业和信息化部数据显示,截至 2026 年 6 月底,我国智能算力规模已达 2185 EFLOPS;IDC 与浪潮信息联合发布的《2026 年中国人工智能计算力发展评估报告》预计,2026 年中国智能算力规模将达 2576.5 EFLOPS、同比增长 87.9%,市场规模有望达 515 亿美元;《信息通信行业发展 “十五五” 规划》更明确提出有序部署万卡、十万卡及以上智算集群。
规模越大,单点故障的影响半径越大。行业实践中,智算集群运维已从 “整机巡检” 细化到 “算力卡级监控”,高负载训练作业单位时间产生的运行日志与监控数据远超传统通算集群。算力竞争的胜负手,正从 “算力供给” 延伸至 “稳定服务”—— 谁能持续稳定地输出算力,谁才能赢得客户长期信任。
升级核心:把运维重心前移到故障发生之前
作为专注于为人工智能产业提供高性能算力基础设施与解决方案的 AI 智算及应用生态平台服务商,星宇智算聚合 NVIDIA RTX 4090 等主流高性能显卡资源,面向高校科研机构、AI 开发者、初创企业及大型科技公司提供云端 GPU 算力租赁服务。
此次运维体系升级,核心逻辑是把运维重心整体前移。星宇智算相关负责人表示:”我们的目标只有一个 —— 让算力集群持续稳定运行,让用户把精力留给算法创新,而不是与宕机赛跑。”
四个关键词,读懂这次升级
- 全栈可观测:集群、节点、GPU 算力卡、网络四层指标统一纳管,构建 “数字显微镜”,问题秒级定位。
- 预测性维护:基于长期运行数据建模,识别硬件退化与性能隐患,把宕机风险拦截在发生之前。
- 自动化处置闭环:告警触发后自动诊断、自动处置、自动验证,大幅减少人工介入,缩短恢复时间。
- 弹性调度与安全加固:负载均衡与自动扩缩容,故障节点算力自动迁移;同步强化数据隔离与权限管控,守牢安全底线。
升级价值:训练不中断,推理不降速
对用户而言,稳定是算力服务最基本也最刚性的诉求。大模型训练动辄数天乃至数周,一次意外中断意味着进度回退与成本损失;推理类业务则对连续在线高度敏感。运维升级的成效,最终落在可感知的服务体验上:据星宇智算介绍,通过平台化调度与优化,算力利用率可提升至 92% 以上,模型训练周期可缩短约 40%。
这份稳定性,与星宇智算 “让高性能计算资源像水电一样触手可及、普惠易用” 的追求一脉相承。从 GPU 弹性算力、xyTerm 新一代 AI 智能终端,到星桥 API 海量模型极速接入,星宇智算正以 “PaaS 平台 + 自营精品 SaaS + 开放生态” 三级火箭模式,持续降低 AI 开发与落地门槛。
让算力持续在线
算力是 AI 时代的基础设施,稳定是基础设施的底色。随着万卡、十万卡集群渐成常态,运维的确定性将成为算力服务商的核心竞争力。此次升级,是星宇智算服务能力的又一次进阶,也是其向 “AI 时代的算力水电站” 愿景迈出的坚实一步。
面向未来,星宇智算将持续加大智能化运维投入,与生态伙伴一道,让每一张算力卡稳定在线,为 AI 产业高质量发展筑牢算力底座。