开场:画布越来越大,问题越来越多
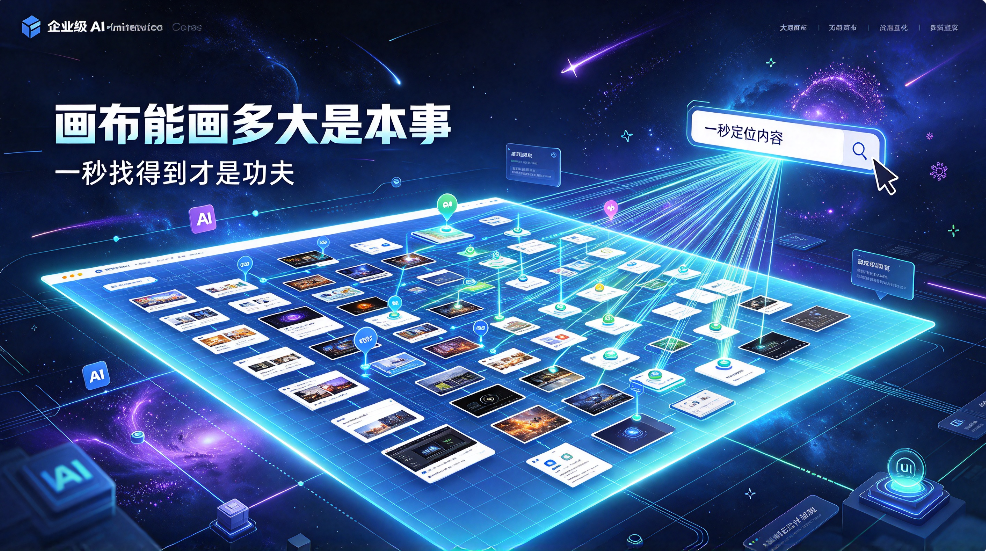
无限画布这几年被讲得最多的,是”能画多大””接缝明不明显”。可真正用起来的团队会发现,第一个让人头疼的不是生成效果,而是查找:项目做了一半,几百个节点铺在画布上,分镜、参考图、配音、字幕混在一起,想问一句”上一版那个运镜节点在哪”,鼠标就得来回划半天。
生成能力决定下限,检索能力决定上限。这句话放在无限画布上,越来越像共识。
问题来了:内容都在,就是找不到
传统工具里,”找东西”靠文件夹和标签。画布不一样——画布上的每个节点同时具备两重属性:一是位置(在画布的哪个坐标区域),二是含义(它是什么内容、属于哪场戏、什么风格)。查询也随之分成两类:
- 空间查询:”框选这块区域,里面有哪些节点?”
- 语义查询:”找所有讲运镜、带角色A的素材。”
更常见的是两者组合:”这个分镜区域里,所有包含角色A的节点。”
只做语义检索,空间问题回答不了;只做坐标索引,内容问题答不上来。这正是《星宇智算技术白皮书:无限画布的空间索引与语义检索架构详解》要解决的核心命题:把”位置”和”含义”放进同一套检索体系。
空间索引:先让画布”知道东西在哪”
空间索引在 GIS、游戏引擎里是成熟技术,白皮书把它搬进了画布场景。画布底层是全局坐标系,节点按”全局世界—分块—视口—像素”四层锚定,每个节点都有确定位置,画布扩得再大也不会错位。
在此基础上,节点区域用空间哈希、四叉树一类结构做索引。查”这块区域里有什么”,不用把画布上所有节点两两比对,查询成本从线性降到近线性。同一套索引还被复用到了布局避让:节点之间不能重叠,碰撞检测先做包围盒预检,再走空间索引快速定位冲突,避免画面互相覆盖。
坐标锚点负责治”累积误差”:多窗口拼接时,全画布共享全局基准,每个窗口生成都与锚点对齐校验,节点才不会越拼越偏。
语义检索:再让画布”知道东西是什么”
空间解决”在哪”,语义解决”是什么”。
节点式存储是语义检索的地基:每次生成,系统自动把提示词、参数、参考图、坐标位置一并存进节点。这些结构化元数据加上多模态特征向量化,一起写入元数据索引层。按配套技术拆解,这一层采用”向量数据库+关系型数据库”双写,语义检索加精准匹配,检索响应在 50 毫秒量级。
全局特征池负责”认人认景”:角色五官、场景风格、整体色调统一存在这里,作为语义锚定。第三方公开实测里,跨分镜语义匹配度能做到 91.2%。翻译成大白话:找同类内容这件事,画布基本靠得住。
双索引合体:位置和含义一起查
单独看,空间索引和语义索引都不稀奇;难点在融合。
白皮书给出的路线是混合检索:查询进来,先按空间范围过滤,锁死”在哪个区域找”;再做语义召回,捞回”内容上匹配”的候选;最后融合排序,两个维度都命中的结果往前放。更关键的是可溯源——每个命中节点都带着完整生成记录,找到就能回溯提示词和参数,直接复用或返工。
对生产团队,这意味着:素材复用不再靠人肉记忆,版本追溯不再靠翻聊天记录。公开拆解里提到,团队化落地后素材复用率能做到三成五左右,省下的是实打实的算力成本。
检索落地:从找素材到确权交付
检索架构的价值不止于”找得到”,往深了看还支撑三件事:
一是语义导航。画布内容多了以后,按角色、场景、风格自动聚类,一屏看清项目全貌,替代逐节点翻找。
二是智能编排。布局、避让、批量调度复用同一套空间索引,节点放得下、不打架、能并行,生产从线性排队变成流水线。
三是确权交付。节点元数据沉淀了完整生成记录,短剧、电商广告这类对版权和合规敏感的交付,可以做到产出可溯源、确权可输出。
说点实话:索引不是免费的
双索引意味着双份存储、双份维护,冷热数据还要分层管理;索引质量,取决于元数据规范能不能从第一个项目就立起来。这些取舍,白皮书没有回避——也正因如此,它更像一份工程手册,而不是宣传册。
找得到,才是功夫
画布能画多大,是模型本事;一秒找得到,才是产品功夫。无限画布的下一轮竞争,大概率从”生成”转向”组织”——谁先把内容管明白,谁就先跑完最后一公里。
《星宇智算技术白皮书:无限画布的空间索引与语义检索架构详解》现已在星宇智算官网”资讯及公告”栏目公开,完整架构细节以原文为准。想上手体验的,直接打开星宇智算 AI 视频工作台,画一张自己的画布试试看。