主体漂移:AI 视频生成的”老大难”
做过 AI 视频的人几乎都遇到过同一个问题:同一个角色,上一个镜头还是圆脸短发,下一个镜头就变成长脸卷发;同一件道具,前半段是红色,后半段莫名其妙变成了蓝色。行业里把这个现象叫做”主体漂移”。
主体漂移不是小瑕疵。对于短剧、漫剧、品牌广告这类需要角色和物体在多个镜头中持续出现的内容来说,漂移意味着观众出戏、返工率飙升、生产成本失控。传统的解决办法是反复调参、大量试错,靠概率”碰”出一组一致的结果——效率低,且不可控。
问题的根源在于:大多数 AI 视频模型本质上是纯文本驱动的。创作者用一段文字描述想要的画面,模型根据文字生成视频。但文字天然是模糊的——”一个穿红衣服的女孩”这句话,无法精确传达女孩的五官比例、发型细节、衣服的材质和色调,更无法告诉模型这个角色在空间中的具体位置和与其他物体的关系。当一段内容需要几十个分镜时,每个分镜都在重新”猜测”主体长什么样,漂移几乎是必然的。
星宇智算 Vera 1.1 提出的三路信号融合机制,正是从底层架构上回应这个问题。它不再让模型只靠文本”猜”,而是同时引入三路不同维度的信号,共同约束生成过程,实现多节点主体的高一致性输出。
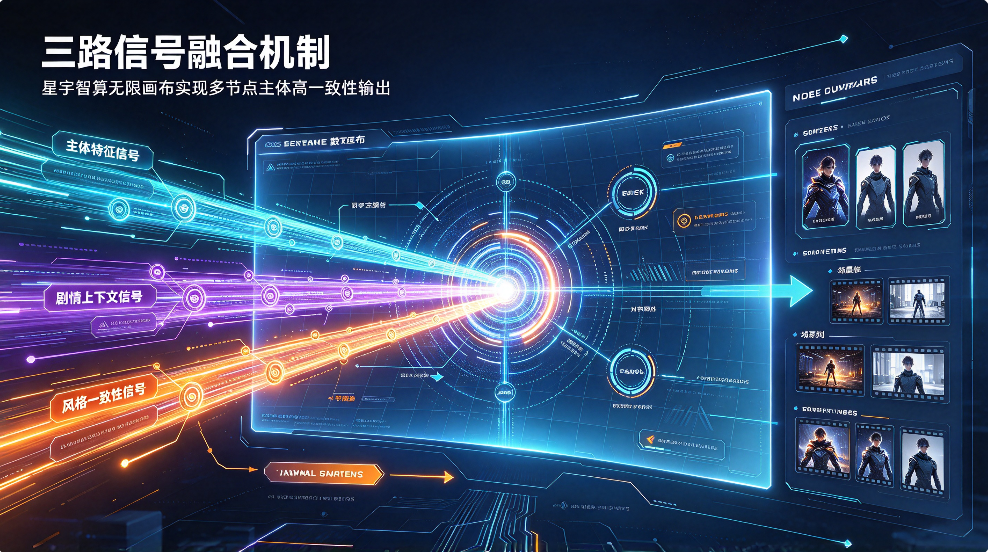
三路信号:文本、参考图、画布坐标
三路信号融合,顾名思义,是将三种不同性质的输入信号同时注入生成模型,各自承担不同的约束职能。
第一路:文本信号——语义描述
文本信号是最传统的输入,也就是创作者写的提示词。它的优势在于表达语义和意图——”一个女孩在雨中奔跑,镜头跟随平移,氛围忧郁”——这类关于动作、情绪、镜头语言、整体氛围的描述,是文本信号的主场。
但文本信号的劣势同样明显:它不擅长精确描述视觉细节。你可以写”棕色长发”,但棕色有无数种,长发有无数种造型,模型每次生成的结果都会有差异。文本提供的是”方向”,不是”精确坐标”。
第二路:参考图信号——身份与外观锚定
参考图信号解决的是文本信号做不到的事:精确的视觉身份。创作者上传一张或多张角色/物体的参考图后,模型从中提取高维身份特征——五官比例、脸型轮廓、发型、服饰材质、物体形状等——建立特征锚点。
这些特征锚点在生成过程中持续注入,强制生成结果向参考身份靠拢。与简单的”首帧复制”不同,Vera 1.1 采用的是跨帧参考特征锚定——参考特征不只是作用于第一帧,而是在整个生成过程中通过特征缓存持续约束,确保主体身份在视频全程保持稳定。
参考图信号还支持多角色锁定。一部漫剧可能有五六个固定角色,每个角色上传参考图后,系统为每个角色生成唯一的角色 ID,存入全局人物特征锚定库。后续所有分镜节点只需要调用对应的角色 ID,就能复用这套稳定的身份特征基准,不需要每次重新上传图片、重新调参。
第三路:画布坐标信号——空间位置与全局关系
画布坐标信号是三路中最具画布特色的一路,也是无限画布区别于传统单条生成工具的关键。
在传统的单条生成模式下,每一段视频都是独立的,模型不知道这段内容在”整个作品”中处于什么位置、与前后镜头有什么空间关系。而在无限画布中,所有分镜节点都排布在一个统一的二维坐标系里,每个节点有明确的空间位置。
画布坐标信号就是把这个空间位置信息注入生成模型。模型在生成分镜 A 时,知道它左边是分镜 B、右边是分镜 C,知道三个分镜在全局空间中的相对位置和衔接关系。这使得相邻分镜之间的场景延续、物体位置传递、运动方向连贯有了底层依据——不是靠创作者手动对齐,而是模型在生成时就”知道”自己在全局中的位置。
配合 Vera 1.1 的”像素—世界—时序”三级坐标联动,画布坐标信号还能支撑多窗口拼接的自动校准。创作者在画布上随便划区域生成,系统自动用全局坐标锚点做校准,拼接出来的画面不会出现错位和透视断裂。
双阶段门控融合:三路信号怎么协同工作
三路信号各有分工,但简单地把它们叠加在一起并不够——文本信号太强会压制参考图的细节,参考图信号太强会限制运动自由度,画布坐标信号太强可能导致画面僵硬。如何让三路信号在不同阶段、不同层面各司其职又相互配合,是融合机制的核心难点。
Vera 1.1 采用的是双阶段门控融合架构。
第一阶段是空间条件融合。 在生成的初始阶段,模型主要关注”画什么”和”放在哪”。这一阶段,文本信号提供语义方向,参考图信号锁定主体身份,画布坐标信号确定空间位置。三路信号通过门控机制动态调节各自的权重——主体区域提高参考图权重确保身份准确,背景区域提高文本权重允许氛围自由发挥,边缘区域提高坐标权重确保与相邻分镜衔接。
第二阶段是时序演化融合。 在视频的动态生成阶段,模型主要关注”怎么动”和”如何连贯”。这一阶段,参考图信号的空间约束自动降低,释放运动空间——角色的肢体可以正常动作,物体可以正常位移,不会因为被”锁死”在参考图姿态而导致动作僵硬。但身份特征依然通过帧特征缓存持续留存,每 2 至 3 帧执行一次特征锚定,确保运动过程中身份不丢失。
这种”先锁后放、放而不丢”的双阶段策略,兼顾了身份一致性和运动自由度。初始化阶段强约束保证首帧与参考对齐,演化阶段适度松绑保证动作自然,收尾阶段再次收紧保证结尾状态可控。
多节点一致性:从单镜头到全作品
三路信号融合解决的是单个节点内的主体一致性问题。但在无限画布的实际使用中,一部作品往往包含几十个甚至上百个分镜节点,如何保证主体在所有节点之间都保持一致?
这里的关键是全局特征锚定库与节点间的信号传递。
当创作者在第一个节点上传角色参考图并设定好参数后,系统提取角色的高维身份特征向量,生成角色 ID 存入全局特征锚定库。后续所有引用该角色的节点,不需要重新上传参考图,只需要调用角色 ID,系统自动从锚定库中提取同一套身份特征注入生成过程。这意味着无论有多少个分镜节点,所有节点共享的是同一套身份基准,从源头上避免了”每个节点各自猜一个样子”的问题。
同时,画布坐标信号在节点之间建立了空间关联。相邻节点的生成结果会互为参考——节点 A 的结束帧特征会传递给节点 B 作为起始约束,节点 B 的生成又会考虑与节点 C 的衔接。这种节点间的特征传递,使得多分镜之间的主体状态不是孤立的,而是连续演化的。
配合节点式存储机制,每个节点的生成参数、参考图引用、角色 ID 都完整留存。如果某个节点的主体出现偏差,只需要调整该节点的参数或重新选择角色特征包,不需要改动其他节点。修改的影响范围被精确控制在单个节点内,不会波及全局。
实测效果:数据怎么说
三路信号融合机制的效果,在实际测试中得到了量化验证。
根据火山引擎开发者社区的实测数据,采用 Vera 1.1 节点化方案后,1 分钟视频的主体一致性保留率达到 94.7%,而传统分段生成方案仅为 72% 至 81%。主体一致性涵盖人物五官、服饰、身形三个维度的综合评估。
跨分镜语义匹配度方面,Vera 1.1 方案达到 91.2%,传统方案为 63%。语义匹配度综合评估场景延续、风格统一、光影连贯三个方面。
单节点最大支持时长从传统方案的 10 秒提升至 30 秒,节点可无限拼接,理论上没有总时长上限。这意味着一部几十分钟的长内容,可以在同一块画布上通过节点拼接完成,全程保持主体一致。
这些数据的意义不在于数字本身,而在于它们标志着 AI 视频生成从”能用”走向”可控”。当主体一致性保留率超过 94%,创作者不再需要把大量时间花在”碰运气”式的调参上,可以把精力真正投入到创意和叙事中。
从”反复调参”到”一次设定,全局生效”
三路信号融合机制带来的,不只是技术指标的提升,更是创作方式的改变。
在传统模式下,创作者为了保持主体一致,需要在每个分镜的提示词中反复描述角色细节,不断调整参考图权重,大量试错,然后在后期修补穿帮镜头。这个过程耗时、耗力、耗算力,且结果不可控。
在三路信号融合的模式下,创作者只需要做一次设定:上传角色参考图,系统自动提取身份特征并存入全局锚定库;在画布上排好分镜节点,系统自动传递坐标信号和衔接特征。之后,所有节点的生成都在三路信号的共同约束下自动保持一致。创作者不需要在每个节点重复描述角色,不需要反复调参,不需要大量试错——一次设定,全局生效。
这对于需要规模化生产内容的团队来说,意味着生产效率的质变和生产成本的结构性下降。当主体一致性不再是瓶颈,AI 视频的工业化生产才真正成为可能。
一致性是底线,创造力是上限
需要说明的是,三路信号融合解决的是”主体稳不稳”的问题,它保证的是创作的底线——角色不变脸、道具不变色、场景不跳变。但它不直接决定作品好不好看、故事动不动人。
好的内容最终依靠的仍然是创意、叙事和审美。三路信号融合所做的,是把创作者从繁琐的技术调参中解放出来,让他们有更多时间和精力去打磨剧本、塑造角色、设计镜头语言。
当技术的底线足够高,创作者才能在更高的起点上发挥创造力。工具守住一致性,创作者定义可能性。