做AI视频的人大概都有这种经历:画面刚跑顺,一配口型对不上;配乐情绪到位了,结果脚步声、开门声全被糊在一条音轨里。想改一句旁白,整条音频得推倒重来,来回倒素材的时间比生成还长。
这不是某一家工具的毛病。把语音、音效、音乐混在一整段音频里一次性生成,是过去不少视频生成模型的共同做法。公开学术圈其实已经在拆这个问题:2025年底智源、北大、北邮联合提出的多流控制视频生成框架,就明确把输入音频拆成语音、音效、音乐三条轨,分别控制口型、事件时序和画面情绪;另一篇arXiv工作也指出,整轨生成最大的痛点是”错一点就得整段重跑”,模块化、分步生成才是能真正进协作流程的方向。
星宇智算这次把这层”拆轨”思路,直接做进了无限画布。
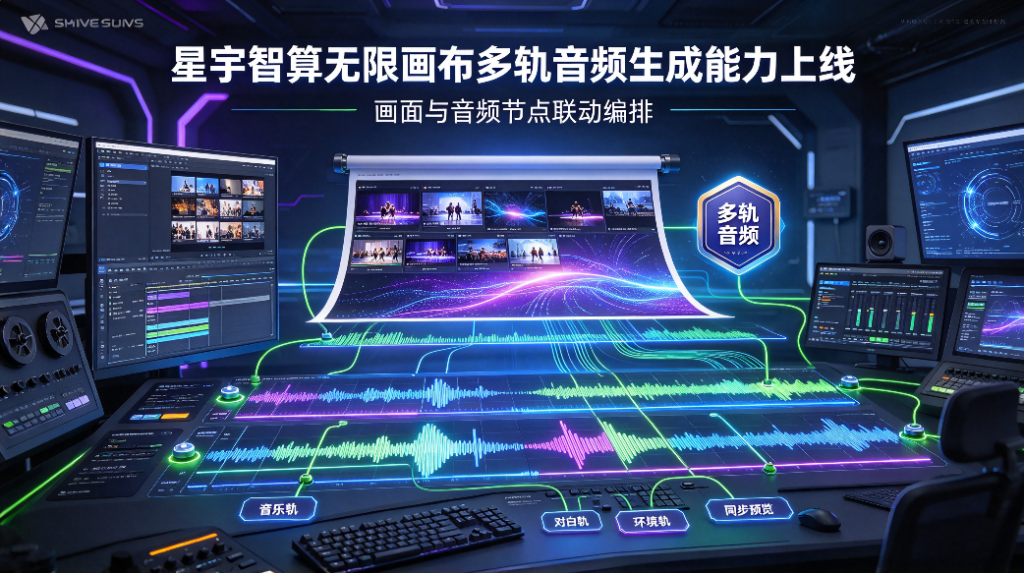
画面和声音,在同一张画布上对齐
无限画布原来解决的是画面侧的问题:分镜、关键帧、多镜头在一张可无限延伸的画布上铺开,角色一致性和时序注意力负责防崩。这次新增的多轨音频生成,让音频不再是导出后才接上的”外挂”,而是和画面节点并排摆在画布上的一等节点。
具体说,创作者可以在画布里分别拖出语音轨、环境音效轨、配乐轨,每一条轨道都能绑定到对应的画面节点上。哪个镜头该出脚步声,哪段台词对口型,哪一格情绪该推弦乐,都在节点连线上一眼看清。改某一个镜头的旁白,只重算这一个音频节点,不必把整条时间轴的声音重新烧一遍。
为什么这事在画布上做才顺
传统剪辑软件的时间轴是线性的,一段素材出错,前后都得跟着挪。无限画布是节点式的:画面节点之间可以并联、分叉、回溯,音频节点挂在画面节点下面,跟着镜头一起走。换一个分镜方向,配音和音效的绑定关系保留,不用重新对位置。
这背后是星宇智算双模型架构在调度:视觉侧负责画面生成和角色一致性,音频侧独立跑语音、音效、配乐,再由多模型智能调度把两条线在时间戳上对齐。角色声音可以提前锁定,反复出现的人物音色统一,后期不用再花时间挨个对口型。
谁会最先用起来
短剧公司最直接:一集戏几十个镜头,旁白、角色台词、环境音、转场音效分层调,改某句台词不再牵动全片。跨境电商和品牌商家适合批量出带货视频,一条主视觉挂多轨音效和口播,换产品就换节点,不换整条时间轴。MCN机构可以把常用的配音音色、BGM情绪存成节点模板,团队协作时直接复用。高校科研用户则能在一张画布上同时做视觉实验和音频对照,省去在多个工具之间反复导文件。
商用与企业侧
个人用户现在注册即可领取6000星元,按星元按量计费,动漫类视频2100星元起/次,用多少扣多少,不捆绑包月。生成内容默认带商用版权合规授权,影视级渲染和角色不崩是底线要求。
有私有化需求的短剧公司和品牌方,可以走星桥API对接,配合企业私有化部署;后台自带API调用监控大盘,权限分级和IP白名单由管理员统一管控,素材和密钥不会散落到外部账号。
几个常被问到的问题
多轨音频是不是得自己会混音? 不是。每条轨先生成、再独立微调,最后由画布统一对齐和导出,不需要专业调音台基础。
换了画布,之前的工程怎么办? 节点式编排的好处就是画面、音频、分镜存在同一个工程里,改一处全图联动,不用在剪辑软件和生成工具之间来回倒。
音色能锁定吗? 角色声音可以在项目里提前锁定并复用,跨镜头保持一致,避免同一人物前后声音跳变。
声音不该是视频生成的最后一块补丁。把它放回画布,和画面节点牵在一起,这事才算真正走完。