AI 生成正在进入”多节点、多轮迭代”的时代:一个创意在画布上分裂成无数分支,每个分支又要反复修改、反复试错。可很少有人意识到,真正的大头,就藏在”重复计算”里。
同一段上下文,每次改动都要重算一遍——这就是热缓存命中率要解决的问题。而星宇智算无限画布,正把它变成一套看得见的效率。
01 先算一笔账:迭代生成的钱,花在了哪里
一个真实项目长什么样?多个节点、多条分支、每轮修改都要重新出图。节点之间共享的,是提示词、参考图、风格参数,还有已经生成的中间结果。
传统的做法是”从头跑”:每次改动,整条链路重新走一遍。画布滑一屏、改一个角色、调一次参数,前面算过的内容全部作废重来。
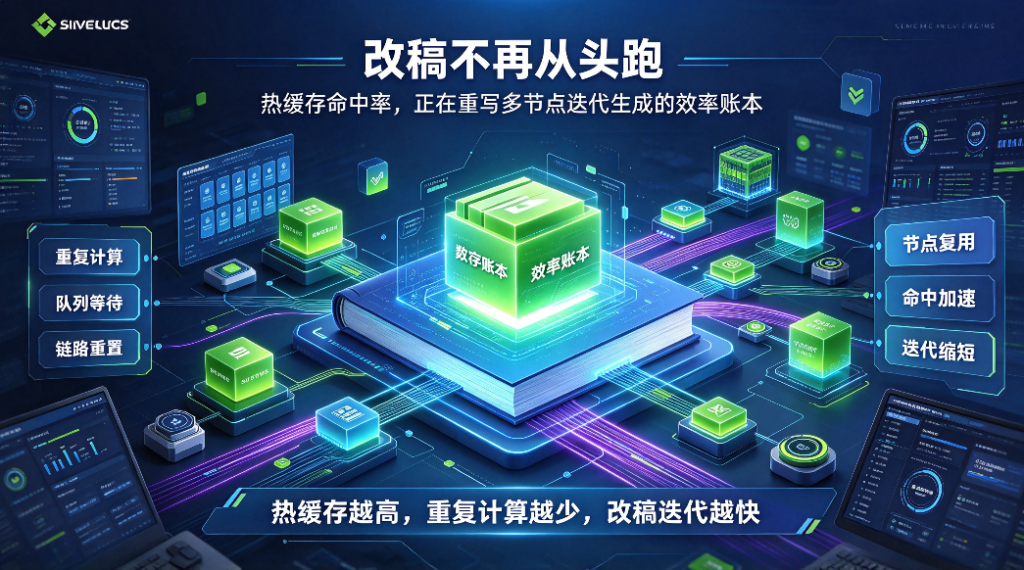
Vera1.1 公开实测口径给出过一个数字:画布连续滑动 3 次,没有缓存时,重复计算占比高达 58%。也就是说,一半以上的算力,花在了”算过又算”上。多节点迭代生成做得越深,这笔浪费就越大。
02 热缓存命中率是什么:把”算过的”变成”记得的”
在推理链路里,缓存不是新概念。KV Cache、前缀缓存、结果缓存,各家推理引擎都在做。所谓”热缓存”,指高频命中、常驻显存的那部分缓存;命中率,就是请求中有多大比例直接复用缓存、无需重新计算。
这不是一家厂商的小技巧,而是行业共识。Anthropic 公开口径显示,Prompt Caching 命中后,输入成本最高可降约 90%、延迟最多可压缩约 85%;OpenAI 对缓存输入 token 的定价约为常规输入的一半;Google 的上下文缓存同样提供大幅折扣。开源侧,vLLM 的自动前缀缓存直接复用已算好的 KV Cache 块——官方文档的评价是”几乎无额外开销,且不会改变模型输出”。
一句话:命中缓存,等于用一折的成本、接近一个数量级的延迟,拿到同样的结果。谁把命中率做高,谁就把效率主动权握在手里。
03 多节点迭代生成,为什么特别吃”命中率”
单请求缓存只是第一步,真正的战场在多节点工作流。
星宇智算无限画布是节点式架构:每一次生成,提示词、参考图、参数自动留存,支持快照回滚、分支迭代。同一节点链路可以存成模板,系列短视频、电商物料只需替换素材即可批量产出;模板市场已内置漫剧、电商、故事板等行业模板,打开即用。
这套结构,天然是缓存的”富矿”:
- 节点与节点之间,共享大量上下文,命中空间大;
- 分支与分支之间,多数内容同源,只有差异需要新算;
- 迭代与迭代之间,改的是局部,继承的是全局。
没有缓存,N 个节点 × M 轮修改,就是 N×M 次重复 prefill;有缓存,每次只算”变化的部分”。对生成式设计、批量出图、长流程创作这类负载,命中率每提高 10 个百分点,省下的都是实打实的算力、时间和钱。
04 无限画布怎么把命中率做上去:三级热缓存 + 增量复用
瓦片注意力解决”算得更少”,热缓存解决”存得更巧”。Vera1.1 的缓存设计分两层:时序 KV 缓存保存各帧 K/V,保证帧间运动一致;空间中间特征缓存保存 DiT 中间层特征,外扩时原始区域直接复用,不用重跑前向传播。
再按热度做三级调度:
- 热区:活动帧特征常驻显存,保速度;
- 温区:过渡帧特征低精度缓存,随时可换出;
- 冷区:非活动帧特征换出到内存,窗口滑近时提前加载。
这套设计,正常场景速度损失控制在 10% 以内,却能省出 25%–30% 显存。真正的收益在增量复用:相邻视口通常有 70% 以上区域重叠,接入三级缓存后,连续滑动场景生成耗时降至基准的 38%,接缝瑕疵率从 42% 降到 3%,显存仅多占 8%。
产品层面更直观。社区实测星宇智算工作台的热缓存资源命中率达 89%——重复使用同一角色素材时,生成速度显著提升,单任务平均耗时约 112 秒(云端 SaaS 口径)。对创作者来说,这一切是透明的:不用改任何习惯,只管继续改、继续调,速度和成本已经悄悄优化。平台提供 SaaS 云端、星桥 API、私有化部署三种形态,星元按量计费,用多少算多少。
05 数字不说谎:收益可验证,口径可追溯
判断一套系统是不是”真优化”,要看能不能给出可验证的数字:
| 维度 | 无限画布(Vera1.1 公开/社区实测口径) |
| 热缓存资源命中率 | 89%(社区实测,云端 SaaS) |
| 连续滑动生成耗时 | 降至基准的 38% |
| 接缝瑕疵率 | 42% → 3% |
| 显存增量 | 仅多占约 8% |
| 单任务平均耗时 | 约 112 秒(社区实测口径) |
| 单集制作周期(3 分钟短剧) | 7 天 → 3 天(内测口径) |
| 后期拼接工时占比 | 32% → 8%(内测口径) |
数据之外,行业也在给这条路径背书:头部推理栈普遍内置缓存能力,开源引擎默认开启前缀缓存,第三方媒体实测同样认可”节点式工作流 + 自动留存”带来的少试错、少返工、可复用。缓存,已经从优化项变成了基础设施。
06 命中率不是越高越好:三个边界要看清
把话说透,收益都是设计出来的,不是白送的。三个边界,行业通用:
- 一致性有成本。 缓存过期、失效、版本管理都要工程投入;画布尺寸一变,旧缓存要重对齐再淘汰,关掉对齐就会出现主体偏移、边界黑边。
- 极端场景有代价。 多轮迭代外扩误差逐轮累积,商用建议总外扩幅度控制在 1 倍以内;高等级缓存吃显存,硬件不足时收益会被 OOM 风险抵消。
- 指标要组合看。 命中率之外,还要看首 Token 延迟、单轮成本、吞吐与废片率。单点拉满,往往意味着别处塌方。
看懂这些边界,才不会被”数字游戏”带偏。
少跑一次,就赚一次
算力很贵。重复计算更贵。 热缓存命中率每上一个台阶,多节点迭代生成就快一分、省一分。 星宇智算无限画布做的,就是把”少跑一次”这件小事,变成创作流程里默认发生的事。 下一步,打开画布试一轮。体感会告诉你答案。