2026 年,AI 视频冲进了量产时代。中国网络视听协会数据显示,一季度上线微短剧 12.8 万部,AI 微短剧占比超 95%;DataEye 统计,1—5 月国内 AI 剧漫剧市场规模已突破 220 亿元。产量上去了,最头疼的毛病也暴露了:复杂场景一做就 “撕裂”—— 想换个背景,前景人物跟着变脸;想扩展画面,保留区被新内容 “污染”,边缘接缝、元素串色、光影对不上。问题出在底层范式:传统扩散模型把整帧当成一个整体,从纯噪声里一次性去噪出 RGB 三通道,它根本不知道 “哪块像素属于谁”。
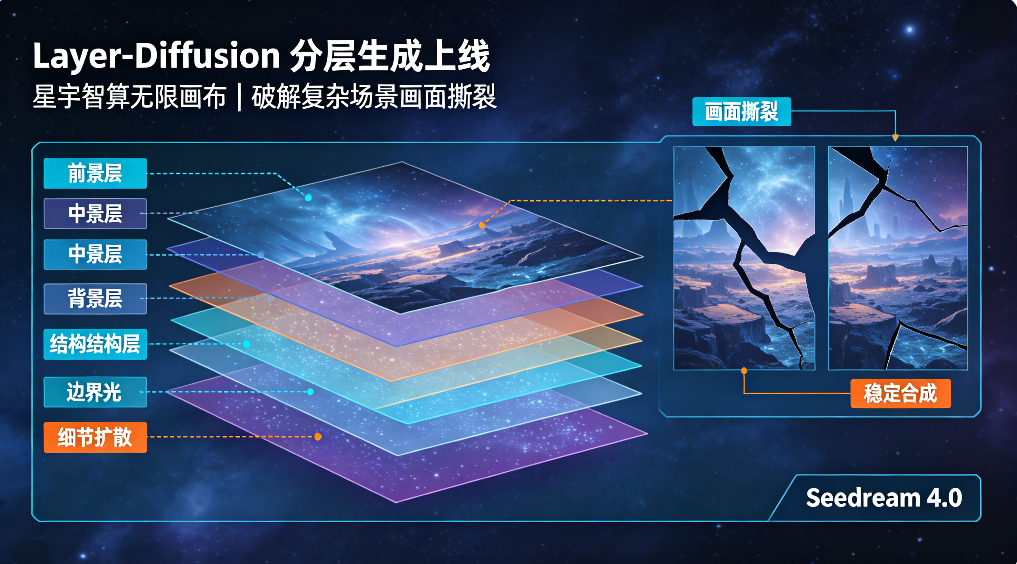
“为什么我只是想改背景,人物也被重画了一遍?” 这是创作者问得最多的问题。答案藏在生成方式里:保留区和生成区被混在同一次去噪中,保留内容也被新噪声改写。星宇智算无限画布上线的 Layer-Diffusion 分层生成,把二者在隐空间里就拆开 ——RGB 内容流负责颜色、纹理与光影,Alpha 透明度流负责前景、背景与边缘羽化;两条流共享文本条件,却各自维护独立隐空间与去噪轨迹,靠层间注意力互相感知。这条路不是营销词,而是一条跑了三年的学术主线:从 2024 年 LayerDiffusion 提出 “latent transparency”(UC Berkeley),到 2026 年 Animated-ART 等 CVPR 工作落地多层透明视频,星宇智算 Vera1.1 的公开技术报告(arXiv:2606.23610)正是同源路线。
落到工程上,星宇智算的做法是 “按网络深度分层”:浅层锁像素质感与纹理,防风格漂移;中层锁结构轮廓与五官,防形变、防串脸;深层控语义与运镜,对齐文本叙事。配合三阶段噪声调度,把 “画什么” 和 “怎么画” 在扩散时间轴上分开。实测效果(1080P/24fps 商用场景):跨镜头风格延续,40 个镜头跑完色调不漂;角色一致性显著提升,人脸漂移率比纯端到端低一个量级;局部重绘框选即改、周围不受影响,图层可单独开关。官方此前公布的数据同样印证:1 分钟视频主体一致性保留率 94.7%,跨分镜语义匹配度 91.2%。
当然要算成本账:双流推理比普通 DiT 贵约 30%—40%,因为 Alpha 流额外占用显存与算力。星宇智算的做法是按场景分流 —— 只有局部重绘、画布扩展走分层生成,普通镜头走常规管线,把预算压回来;计费上星元按量,新用户注册赠送 6000 星元,商用版权合规,能上平台、能投放。同样得说实话:复杂遮挡切换、玻璃烟雾等半透明物体、物理光影联动仍是前沿难题;分层生成 “让你少返工,而不是不返工”—— 它能救回约 80% 的改稿,剩下 20% 仍要整条重跑。工具决定下限,审美与判断决定上限。
“分层” 治的不是画面,是返工。
当生成能力趋同,谁先解决 “保留与生成” 的矛盾,谁就握住工业化生产的钥匙。星宇智算把 Layer-Diffusion 放进无限画布,价值不在炫技,而在让每一帧可局部修改、可逐层控制、可批量稳定 —— 这才是复杂场景真正敢量产的前提。