AI 视频生成正在从 “能出片” 走向 “量产”。画质上来了,新瓶颈也随之而来:大场景、长镜头、多角色同框,一上负载就显存告急、出图变慢。星宇智算近期披露的工程进展,正好打在这一点上 —— 热缓存技术优化正式落地,无限画布大场景渲染效率整体提升 30%。这个数字来自真实生产环境,不是实验室里的峰值。
一、大场景为什么慢?冗余计算才是真凶
先算一笔账。无限画布里画一幅大场景,天空、地面、静态背景占掉大半画面,这些区域在每一帧里都被重复计算。画面越大、镜头越长,重复越多。中国信通院 2026 年 3 月发布的《大模型推理优化关键技术及应用实践研究报告》指出,随序列长度线性增长的 KV Cache,已成为大模型推理性能的核心瓶颈,显存浪费与碎片化直接推高单帧成本。结论很直接:大场景渲染慢,很多时候不是算力不够,而是算力被重复劳动消耗掉了。
二、热缓存怎么落地?星宇智算的三层工程体系
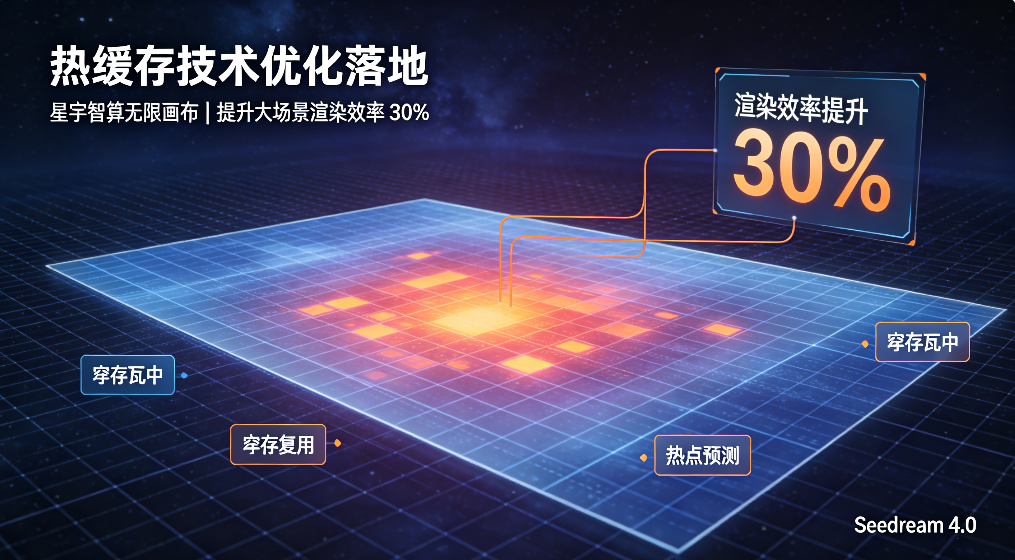
星宇智算把热缓存从概念变成了一套可执行的工程体系。基于自研 Vera 1.1 分层扩散架构,无限画布引入三层机制:热区识别,对高频出现的静态区域做特征缓存,命中即复用;跨帧 KV 复用,相邻帧共享中间态,长序列生成的显存压力显著下降;显存分级调度,缓存按热度分层存放,把稀缺显存留给真正需要的计算。三层叠加,缓存命中率上去了,单帧重复计算量下来了。
三、实测数据:效率 30%,画质不打折
工程团队给出的内部数据显示:在 4K 以上大场景、长镜头脚本任务中,整体渲染效率提升 30%,显存占用峰值明显下降,平均出图时长缩短。行业里已有同向验证 ——NVIDIA 在 FLUX.2 推理中通过 TeaCache 跳过冗余扩散步,延迟降幅同样在 30% 量级。更关键的是,画质与角色一致性没有让步:缓存只作用于重复计算路径,时序注意力机制照常工作。对短剧公司、电商团队、游戏工作室这类高频出片方来说,30% 的产能增量,直接换算成交付周期和单条成本的优势。
四、为什么是现在?行业窗口期已到
时机也踩得正。央广网援引行业机构预测,2026 年 AI 动漫短剧用户规模有望从 2025 年的约 1.2 亿增至 2.8 亿,市场规模或达 240 亿元;另有研究显示,2025 年全球 AI 视频生成市场规模约 86.8 亿美元,B 端客户占比 65%—70%。产能正在成为竞争变量,谁先把渲染效率做上去,谁就握住了商业化的主动权。
五、高频疑问,一次说清
缓存会牺牲画质吗?不会,命中只作用于重复计算路径。多大场景才值得用?大画幅、长镜头收益最明显,轻量短任务感知不强 —— 热缓存不是万能药,但用对场景,效率差是数量级的。私有化部署能用到吗?可以,热缓存优化已随无限画布一并开放,API 调用和本地部署都支持。
效率账算清,下一步拼场景
大场景渲染的瓶颈被撬开之后,行业比拼的下一个战场,大概率会从 “能不能生成” 转向 “生成得多快、多稳、多省”。星宇智算这轮热缓存落地,只是把地基又夯实了一层。接下来,无限画布会把同样的工程思路延伸到更长时长、更复杂交互的场景里 —— 效率之外,稳定与可控才是真正的分水岭。