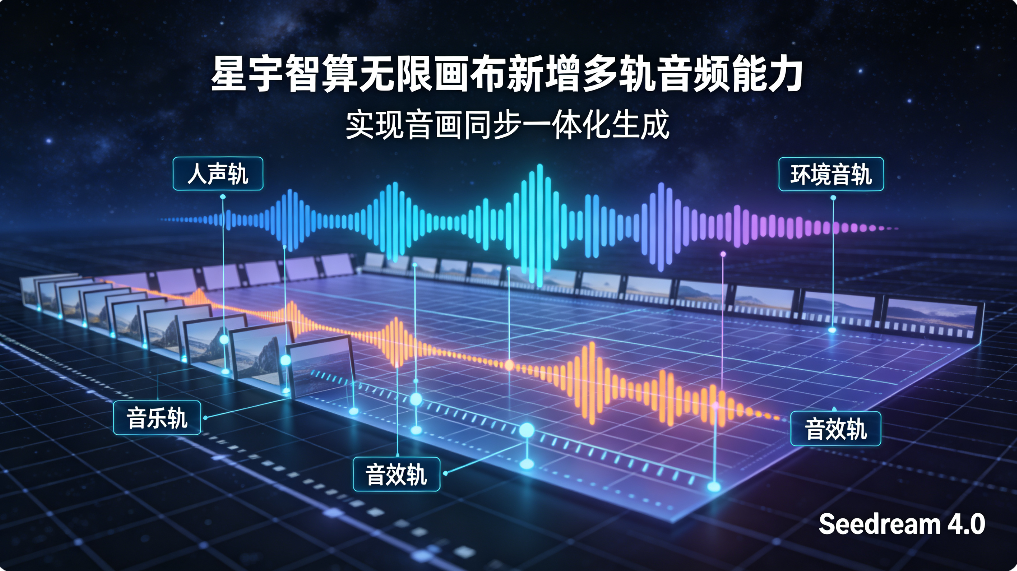
AI 视频生成跑到 2026 年,画面早就不是问题了,声音反而成了最扎眼的穿帮源头:口型对不上、音效贴不齐、配乐靠后期一轨一轨手动拖。星宇智算最新披露,无限画布新增多轨音频能力 —— 对白、音效、配乐、环境声分轨生成,与画面同管线产出,实现音画同步一体化生成。换句话说,声音不再 “后期补”,而是 “天生长在画面上”。
一、为什么说音画同步是 2026 年的分水岭
先看行业动作。2 月豆包 Seedance 2.0 发布,明确支持背景音乐、环境音效、人物解说等多轨并行输出,精准对齐画面节奏;快手 Kling 2.6 把 “音画同步生成” 写进核心能力;百度 ERNIE 团队开源 NAVA,首次在单条提示词下联合生成画面与立体声。头部玩家集体转向,信号很明确:音频正从 “后期工序” 变成 “生成能力”。谁还在靠人工配音、手动拖轨对齐,谁就在量产赛道上吃亏。
二、多轨音频到底解决了什么
过去一条 AI 视频的出片是两段式:先出画面,再找配音、贴音效、配乐,最后人工对齐。口型差半秒、脚步和音效错位,都是家常便饭。无限画布的做法是把它合并成一段:音频在生成阶段就与画面共享同一条时间线,多轨各自独立又彼此咬合 —— 对白跟着嘴型走,音效跟着画面事件走,配乐跟着节奏走。分轨不是简单叠音轨,而是每一轨都锚定画面事件,这是 “一体化” 和 “堆素材” 的本质区别。
三、成本账,行业已经替我们算过了
音画不同步从来不只是体验问题,更是成本问题。海外测算显示,传统人工配音与对口型服务约 50—150 美元 / 分钟,AI 方案已压到约 1 美元 / 分钟量级;即便只做口型同步,独立跑一遍也要占用大量 GPU 算力。需求侧同样在涨:据中研普华产业研究院测算,2026 年中国 AI 配音市场规模预计达 113.6 亿元,保持两位数增长。需求在涨、成本在降,谁先把音画环节做进生成管线,谁就把这笔账省在了源头。
四、哪些场景最先受益
短剧公司最先尝到甜头:多角色对白、情绪配乐、环境音一并在生成阶段搞定,单集交付从 “画面 + 后期配音两段式” 变成一次出片。电商口播、游戏动画、教育课件同理 —— 多语言、多音色按需切换,分轨素材还能单独导出,方便后期精修。对日更产能的团队来说,省下的不只是钱,是排期。
五、高频疑问,一次说清
多轨音频能单独导出吗?能,对白、音效、配乐分轨交付,后期想怎么调都行。音画是生成时对齐还是事后修?生成阶段同管线对齐,不需要人工逐帧补救。支持哪些语言和音色?主流语言与多音色可选,适配不同内容风格。一体化生成会不会更慢?多轨与画面并行产出,整体出片链路反而更短。
画面会说话了,声音也跟上
从 “能出画面” 到 “声画同源”,AI 视频又跨过一道坎。多轨音频这步棋,表面是给无限画布加了一项能力,底层是创作流程的重构 —— 把后期工种提前到生成阶段。接下来,行业比拼的将是 “听得懂、说得准、配得稳”。星宇智算无限画布会继续在这条路上往前推,让每一帧画面,都自带恰到好处的声音。