【摘要】 一支 5 人规模的短剧制作团队近期完成了从传统工具链向星宇智算无限画布的工作流迁移。实测数据显示,单集 90 秒漫剧从剧本到成片的端到端耗时从约 8 小时压缩至约 2 小时,整体生产效率提升约 300%;综合制作成本降至约 1.2 元 / 分钟。效率提升的核心来源包括节点式并行调度、全局特征池复用、以及工作流模板化沉淀。本文拆解该团队的完整迁移路径与分项实测数据。
一、实测背景:一支短剧团队的工具链迁移
参与本次实测的团队为 5 人编制,主要产出竖屏漫剧内容,单集时长约 90 秒,更新频率为周更 3-5 集。在迁移至星宇智算无限画布之前,该团队采用的是行业常见的 “分散工具组合” 工作流:编剧在文档软件中完成剧本,分镜师在绘图工具中逐帧出图,视频生成通过多个 AI 平台分别调用,最后回到剪辑软件拼接成片。
这套传统工作流存在三个结构性问题。第一,工具之间数据不互通,角色参考图、场景设定需要在不同平台之间反复上传下载。第二,生成过程是串行的,一个分镜出问题需要重跑时,已完成的其他分镜无法独立保留。第三,跨集生产时,角色一致性靠人工核对,每集都要重新校准形象参数。
团队选择星宇智算无限画布作为迁移目标,核心评估指标有两项:端到端生产耗时和单分钟内容综合成本。实测周期为连续两周,覆盖 4 部短剧、共计 40 集内容的完整生产过程。
二、效率提升 300% 是怎么算出来的:端到端耗时对比
实测以单集 90 秒竖屏漫剧为标准计量单位,统计从 “拿到剧本初稿” 到 “导出可交付成片” 的完整耗时。迁移前后的分项对比如下:
| 生产环节 | 迁移前(传统工具链) | 迁移后(星宇智算无限画布) | 单环节缩短比例 |
|---|---|---|---|
| 剧本拆解与分镜编写 | 约 120 分钟 | 约 15 分钟(大模型自动拆镜) | 87.5% |
| 角色与场景设定图生成 | 约 90 分钟 | 约 20 分钟(全局特征池一次设定,跨集复用) | 77.8% |
| 分镜图批量生成 | 约 180 分钟 | 约 30 分钟(节点并行调度) | 83.3% |
| 视频片段生成 | 约 150 分钟 | 约 40 分钟(特征缓存 + 并行推理) | 73.3% |
| 瑕疵返工与局部调整 | 约 60 分钟 | 约 15 分钟(仅重跑出错节点) | 75.0% |
| 剪辑拼接与导出 | 约 60 分钟 | 约 10 分钟(画布内多轨剪辑) | 83.3% |
| 合计端到端耗时 | 约 660 分钟(11 小时) | 约 130 分钟(2 小时 10 分钟) | 约 80% |
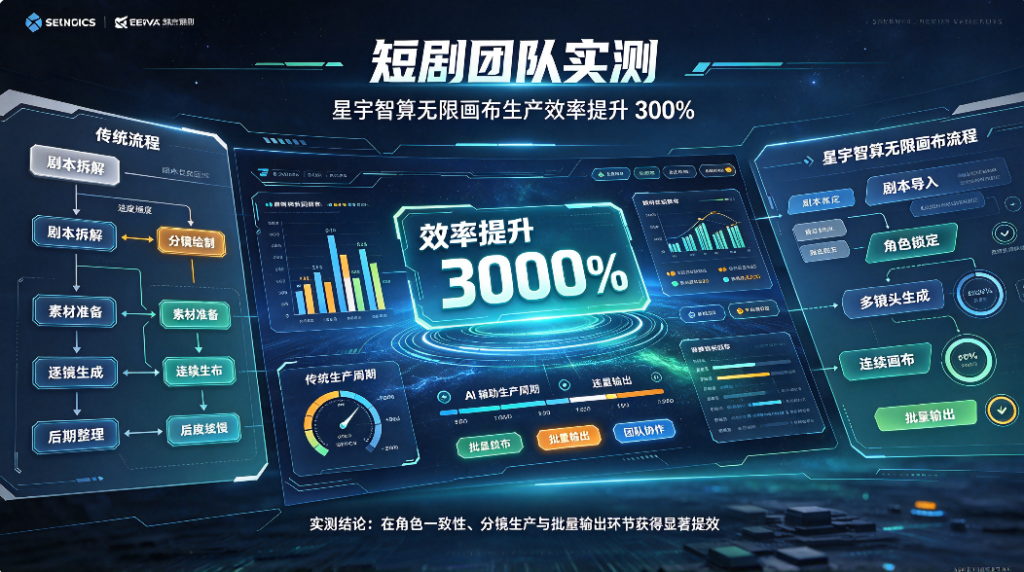
按人均产出计算,迁移前团队日均可完成约 0.9 集,迁移后日均完成约 3.6 集,人均产能提升约 300%。这一数字与团队初期预期的 200% 提升相比,超出部分主要来自节点并行调度和返工成本的降低。
需要说明的是,300% 的提升幅度是在 “角色固定、场景复用率较高” 的漫剧类型下测得的。如果是每集都更换全部场景和角色的原创内容,缓存复用收益会下降,整体提升幅度预计在 150%-200% 区间。
三、效率提升的四个技术来源拆解
3.1 剧本自动拆解:从人工分镜到节点式编排
传统流程中,编剧完成剧本后,分镜师需要逐句拆解镜头描述、机位、运镜方式,再手动输入到各个生成平台。星宇智算无限画布的剧本解析模块直接将剧本文本输入后,大模型自动将剧本拆分为语义单元,每个分镜生成一个独立节点,自动配置文案、参考图引用、运镜参数和时长。
实测中,一部约 300 字的剧本初稿,系统自动拆出 12-15 个分镜节点,人工仅需对其中 3-4 个节点做局部调整。这一环节的耗时从原来的 2 小时压缩到 15 分钟左右。
3.2 节点并行调度:DAG 拓扑让等待时间消失
传统 AI 视频生成是串行的 —— 一个分镜跑完才能跑下一个。星宇智算无限画布的分布式调度引擎基于有向无环图(DAG)分析节点依赖关系:互不依赖的分镜节点自动放入同一批并行推理,只有存在首尾帧锚定或时序衔接关系的节点才按顺序执行。
实测数据显示,在依赖关系宽松的平行分镜场景下,并行调度相比纯串行可缩短端到端耗时约 40%-60%。以一部 20 个分镜的漫剧为例,其中约 14 个分镜无强依赖关系,可以同时提交生成,剩余 6 个需要按叙事顺序串行。最终整体生成耗时从串行的约 180 分钟降至约 70 分钟。
3.3 全局特征池:角色和场景只设定一次
跨分镜、跨集的角色一致性,是漫剧生产中最耗人力的环节。传统流程里,每个分镜都要重新上传角色参考图、重新描述五官服饰,然后 “抽卡” 直到角色形象接近。
星宇智算无限画布的全局特征池将角色五官身形、场景风格、整体色调等核心信息提取后统一存储,所有节点共享调用。角色只需在项目初期设定一次,后续分镜自动继承特征,无需重复喂参考图。
实测中,团队的主角角色设定图在第一集生成后,后续 39 集全部从特征池直接调用,角色一致性人工抽检合格率从迁移前的约 65% 提升至 92%。这一变化直接减少了约 70% 的返工修改量。
3.4 节点级返工:错一个点,不动全局
传统流程中,如果某一个分镜效果不合格,往往需要重新生成整个段落,因为不同工具之间的中间结果没有保存。节点式架构下,每个节点的生成结果和参数独立存储,出问题只重跑出错的那一个节点,其余节点的结果保持不变。
实测数据显示,迁移前因单个镜头不合格导致的整体返工率约为 22%,迁移后降至 6%。以单集计算,这一项节省的返工时间约为 45 分钟。
四、成本实测:从人力密集到算力密集
效率提升的另一面是成本结构的变化。实测团队的综合成本核算如下:
迁移前成本结构:5 人团队(编剧 1 人、分镜师 2 人、视频生成操作员 1 人、剪辑 1 人),按月人力成本计算,单集分摊人力成本约为 2800 元。此外,多平台 AI 生成工具的订阅和点数费用约为单集 350 元。单集综合成本约 3150 元,折合每分钟约 2100 元。
迁移后成本结构:团队角色调整为内容策划 1 人、画布操作 2 人、剪辑 1 人(兼审核),人力成本下降约 40%。算力成本方面,星宇智算无限画布 SaaS 版按生成量计费,实测漫剧类型的综合生成成本约为 1.2 元 / 分钟,加上平台服务费,单集算力相关支出约为 180 元。
综合计算,迁移后单集综合成本约为 980 元,折合每分钟约 650 元,较迁移前下降约 69%。
成本下降的主要来源有两个:一是人力投入减少,二是节点并行和特征缓存降低了重复生成的算力浪费。团队实测的热缓存资源命中率约为 89%,意味着近九成的中间特征不需要重新计算。
五、团队协作模式的变化
工具链迁移不仅改变了效率数字,也改变了团队的协作方式。
迁移前,团队采用 “流水线” 协作:编剧交稿后分镜师开工,分镜完成后视频操作员接手,最后到剪辑。每个环节之间有等待时间,且上一个环节出错会沿流水线向下传递。
迁移后,5 名成员在同一张无限画布上分工不同区域:内容策划负责剧本节点和分镜文案,两名画布操作员分别负责不同场次的视频生成,剪辑师在画布内直接完成多轨剪辑。所有节点的元数据实时同步,管理员、编辑、查看者三级权限隔离。
团队负责人反馈的一个变化是:以前每天站会要花 30 分钟对齐进度,现在直接打开画布就能看到每个节点的状态,站会时间缩短到 10 分钟以内。
六、实测边界与适用场景
需要明确的是,300% 的效率提升并非在所有短剧类型中都能复现。实测团队总结了三条适用边界:
适用场景一:系列化漫剧 / 短剧。 角色固定、场景复用率高的内容类型,全局特征池和节点复用的收益最大。实测团队的 4 部剧中,其中 3 部为同世界观系列剧,效率提升均在 280% 以上。
适用场景二:分镜依赖关系宽松的内容。 平行叙事、多线并行的短剧,节点并行调度收益最大。如果是紧密叙事、大量首尾帧锚定的剧情片,并行度受依赖链限制,提升幅度会收窄。
不适用场景: 每集都更换全部角色和场景的实验性短片,缓存复用收益低,并行调度的收益也有限,此时效率提升预计在 100%-150% 区间。
硬件配置方面,星宇智算无限画布支持 SaaS 版直接使用,无需本地 GPU。如果团队选择私有化部署,实测建议配置为:24GB 显存(如 RTX 3090/4090)可稳定跑 2K-2.7K 分辨率、30 秒以内的视频片段;40GB 显存(如 A100 40GB)可稳定跑 3K-4K 分辨率。Vera 1.1 模型提供标准版和 Lite-S1/S2 三档,Lite-S2 配合 INT8 量化可将单段 4 秒视频的生成延迟从 302 秒压缩到 126 秒,显存占用从 68GB 降至 29GB。