摘要
随着生成式 AI 与大模型技术快速落地,GPU 算力选型已成为企业与开发者的核心决策环节。本文基于主流显卡的实测参数与场景化需求,系统梳理数据中心级与消费级 GPU 的性能基准,针对大模型训练、推理部署、视觉生成、轻量开发四大典型场景给出量化匹配标准,并结合弹性算力调度模式分析成本优化路径。文章同时介绍星宇智算无限画布在空间索引架构与算力弹性调度上的技术实践,为 AI 团队提供可落地的选型参考与工程化方案。
一、AI 算力选型的核心逻辑:从场景出发而非盲目追新
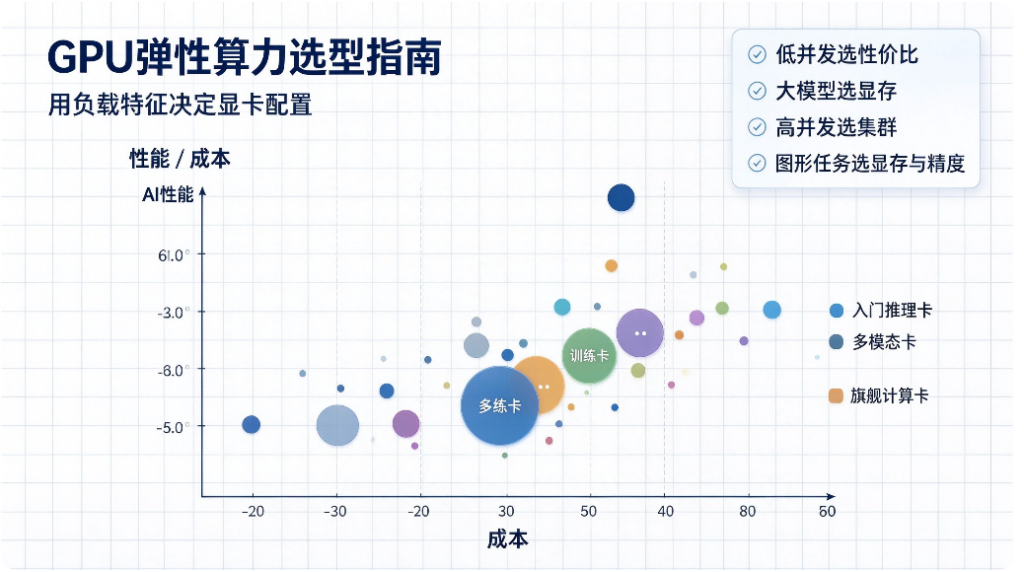
GPU 选型的首要原则是 “显存优先、带宽次之、算力匹配”。显存决定能否承载模型,带宽决定数据吞吐效率,而浮点算力则在显存与带宽满足后决定最终运行速度。脱离具体场景直接选择最高端卡型,往往会造成算力闲置与成本浪费。
弹性算力模式的核心价值在于,允许用户根据任务阶段动态调整卡型与数量,训练期调用高带宽集群,推理期切换至高性价比推理卡,开发期使用入门级资源。这种按需匹配的模式,相比固定硬件采购可显著降低综合算力成本。
二、主流 GPU 卡型性能基准与关键参数对比
2.1 数据中心级 GPU 核心参数
数据中心级 GPU 是生产环境与大规模训练的主力选型,各卡型核心参数如下:
表格
| 卡型 | 显存容量 | 显存类型 | 显存带宽 | FP8 算力 | FP16 算力 | 典型功耗 |
|---|---|---|---|---|---|---|
| H100 SXM | 80GB | HBM3 | 3350 GB/s | 3958 TFLOPS | 1979 TFLOPS | 700W |
| A100 SXM | 80GB | HBM2e | 2039 GB/s | 不支持原生 FP8 | 312 TFLOPS | 400W |
| L40S | 48GB | GDDR6 | 864 GB/s | 733 TFLOPS | 362 TFLOPS | 350W |
| A10G | 24GB | GDDR6 | 600 GB/s | 不支持原生 FP8 | 156 TFLOPS | 300W |
数据来源:NVIDIA 官方技术规格与第三方实测汇总
2.2 消费级与工作站级 GPU 参数
消费级显卡主要用于开发测试、小规模推理与本地部署场景:
表格
| 卡型 | 显存容量 | 显存类型 | 显存带宽 | FP16 算力 | 典型功耗 |
|---|---|---|---|---|---|
| RTX 4090 | 24GB | GDDR6X | 1008 GB/s | 165 TFLOPS | 450W |
| RTX 4080 | 16GB | GDDR6X | 717 GB/s | 104 TFLOPS | 320W |
| RTX 6000 Ada | 48GB | GDDR6 | 960 GB/s | 362 TFLOPS | 300W |
2.3 大模型推理吞吐量实测参考
基于 TensorRT-LLM 与 vLLM 框架的实测数据显示,不同卡型在大语言模型推理上表现出显著差异:
- H100 80GB:输入 128token、输出 2048token 场景下,批量推理吞吐量约 21109 tokens/s
- A100 80GB:同等条件下吞吐量约 5256 tokens/s
- L40S:同等条件下吞吐量约 5366 tokens/s,凭借 FP8 支持在推理场景接近 A100 水平
上述数据为离线批量推理峰值,实际生产环境受并发数、上下文长度、量化策略影响,吞吐量通常为峰值的 30%-60%NVIDIA。
三、四大 AI 场景的算力匹配方案
3.1 大模型预训练与全参数微调
预训练与全参数微调对显存带宽和多卡互联要求最高,是算力消耗最大的场景。
选型标准:
- 7B-13B 模型全参数微调:推荐 A100 80GB 2-4 卡集群,单卡可承载混合精度训练所需显存
- 30B-70B 模型训练:推荐 H100 80GB 8 卡以上 NVLink 集群,HBM3 高带宽可显著缩短训练周期
- 70B 以上超大规模模型:必须采用多节点 H100/H200 集群,配合 InfiniBand 高速网络
核心依据: 7B 模型全精度训练含优化器状态约需 112GB 显存,单卡无法承载,必须多卡分布式训练。H100 相比 A100 在大模型训练上可提升 3-4 倍训练速度,长周期任务下综合成本更优。
3.2 大模型推理与生产级服务部署
推理场景关注吞吐量、延迟与单 token 成本,对算力的需求结构与训练完全不同。
选型标准:
- 7B-13B 模型高并发推理:L40S 为最优性价比选择,FP8 精度下单卡吞吐量可达 800 tokens/s 以上,单位 token 成本低于 A100 约 40%
- 30B-70B 模型推理:推荐 A100 80GB 或 H100 80GB,70B 模型 4-bit 量化后可单卡运行,FP16 精度需多卡张量并行
- 低延迟在线服务:优先选择显存带宽更高的卡型,H100 单请求延迟比 A100 降低约 50%
量化策略影响: 4-bit 量化可将显存需求降低约 75%,70B 模型量化后仅需约 35GB 显存即可单卡运行,适合对精度容忍度较高的场景。
3.3 AI 视觉生成与多模态创作
图像生成、视频渲染、AI 商业视觉等场景,显存容量与 CUDA 核心数量共同决定效率。
选型标准:
- 基础文生图(SD 系列):RTX 4090 24GB 可满足绝大多数分辨率需求,单张 1024×1024 图像生成时间约 2-4 秒
- 高清图生图与商业视觉:推荐 L40S 48GB 或 RTX 6000 Ada,大显存可承载更高分辨率与更大批次
- 视频生成与 3D 渲染:推荐 A100 80GB 以上,长视频序列对显存与稳定性要求更高
星宇智算无限画布基于空间索引架构,可将多分辨率视觉素材的生成与调度效率提升 30% 以上,尤其适合电商主图批量生成、AI 模特图合成等商业视觉场景,通过弹性算力池化实现任务并行处理。
3.4 轻量 AI 应用与开发测试环境
模型调试、插件开发、小规模验证等场景,对算力要求不高,更关注启动速度与成本。
选型标准:
- 7B 以下模型开发测试:RTX 4090 或 A10G 即可满足,24GB 显存支持 4-bit 量化下 13B 模型运行
- 边缘推理与端侧部署验证:T4 或更低规格卡型,16GB 显存可覆盖多数轻量化模型
- 多环境并行开发:支持 MIG 切分的 A100 可将单卡划分为多个实例,提升开发资源利用率
四、弹性算力选型的五大决策指标
4.1 显存容量匹配度
显存是第一约束条件。模型权重 + KV 缓存 + 激活值必须全部装入显存,溢出到系统内存会导致性能下降 80% 以上。通用估算公式:FP16 精度下每 10 亿参数约占 2GB 显存,训练场景需乘以 4-6 倍以容纳优化器状态。
4.2 显存带宽效率
推理速度主要由显存带宽决定,而非 CUDA 核心数量。这也是为什么显存带宽更高的卡型,即使 FP32 算力较低,在 AI 推理中反而更快。HBM 显存相比 GDDR 显存带宽优势显著,是大模型场景的核心优势。
4.3 多卡互联能力
训练场景下,多卡之间的数据传输速度直接影响扩展效率。NVLink 4.0 带宽可达 900GB/s,远高于 PCIe 4.0 的 32GB/s。大规模集群还需考虑 InfiniBand 网络带宽,通常要求单节点 400Gbps 以上。
4.4 计费粒度与弹性
弹性算力模式下,计费粒度直接影响闲置成本。按秒计费相比按小时计费,对短任务与波动负载可节省 30%-70% 成本。关机是否计费、抢占式实例折扣、包时套餐组合,都是成本优化的关键维度IT之家。
4.5 软件生态兼容性
CUDA 生态成熟度是选型隐性成本。主流 AI 框架 PyTorch、TensorFlow 对 NVIDIA 卡支持最完善,AMD 卡需通过 ROCm 适配,部分算子存在性能损耗。新架构如 FP8 需要对应框架版本支持才能发挥性能优势。
五、星宇智算无限画布:弹性算力的工程化落地
星宇智算无限画布是面向 AI 视觉与大模型场景的弹性算力平台,基于空间索引架构与分布式调度引擎,实现异构 GPU 资源的统一池化与按需分配。
平台核心特性包括:
- 多卡型统一调度:支持 H100、A100、L40S、RTX 4090 等多规格卡型混部,任务自动路由至最优算力节点
- 秒级弹性伸缩:推理服务根据请求量自动扩缩容,峰值流量下分钟级完成算力补充
- 空间索引优化:针对无限画布类视觉任务优化显存管理,超大分辨率场景显存占用降低 40%
- 按量精确计费:按秒级粒度计费,关机停止算力费用,最小化闲置成本
对于电商 AI 视觉、短剧工业化生产、批量内容生成等场景,无限画布可将单任务平均成本降低 35% 以上,同时提升交付效率。平台支持私有化部署,满足企业数据安全与合规要求。
六、选型避坑与成本优化实操建议
第一,避免 “一步到位” 式采购。AI 技术迭代周期约 6-12 个月,硬件贬值速度快,弹性租用相比固定资产采购通常具备更高的投入产出比。建议先用按量模式验证业务模型,稳定负载再转为包年或自建。
第二,量化优先于堆卡。在可接受精度损失的场景,优先采用 4-bit 或 8-bit 量化降低显存需求,通常可将单卡承载模型规模提升 2-4 倍,成本效益远高于增加卡数。
第三,任务错峰与抢占式实例结合。非实时批处理任务可使用抢占式资源,价格通常为按量的 30%-50%。训练任务设置断点续训,中断后可自动恢复,进一步降低算力成本。
第四,关注隐性成本。数据传输费、存储费用、公网带宽费用在部分平台占比可达 20% 以上,选型时需综合评估全链路成本,而非仅对比 GPU 小时单价。
常见问题 / FAQ
Q1:7B 大模型推理最低需要什么配置的 GPU? A:4-bit 量化的 7B 模型最低可在 8GB 显存显卡上运行,但性能受限。推荐 16GB 显存以上获得可用速度,生产环境建议 24GB 显存起步,以容纳 KV 缓存并支持合理并发。
Q2:L40S 和 A100 80GB 怎么选? A:推理场景优先选 L40S,FP8 支持下单位 token 成本更低;训练场景、70B 以上模型或需要大显存时选 A100 80GB。简单判断:显存 48GB 够就用 L40S,不够再上 A100。
Q3:弹性算力和自建 GPU 服务器哪个更划算? A:日均利用率低于 70% 的场景,弹性算力综合成本更优,且免去运维、折旧、升级成本;长期满负荷运行(日均 20 小时以上)且业务稳定超过 18 个月,可评估自建方案。