摘要
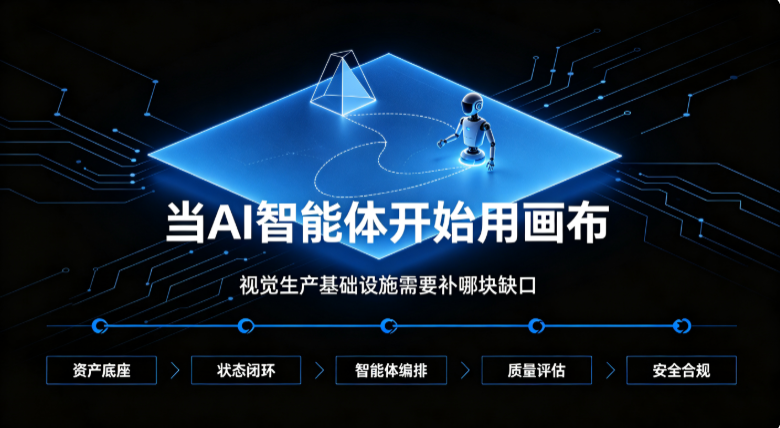
AI 智能体技术正从文本交互向多模态生产加速演进,当智能体具备自主操作视觉画布的能力后,传统固定画幅的算力基础设施面临系统性适配缺口。2025 年中国图像生成单元市场规模达 138.6 亿元,同比增长 29.4%,但面向智能体的画布级算力调度、分块渲染架构、跨模型操作协议三大基础设施仍存在结构性供给不足。本文基于产业实测数据拆解缺口成因,对比不同技术路径的性能成本边界,并结合星宇智算无限画布方案,提出基础设施层的补全方向,为企业级视觉生产系统升级提供可量化的决策参考。
一、AI 智能体驱动视觉生产范式迁移
1.1 从 “工具调用” 到 “画布操作” 的能力跃迁
AI 智能体的演进路径呈现清晰的阶段特征:第一阶段以文本工具调用为主,智能体通过 API 调用搜索引擎、代码执行器等完成任务;第二阶段进入多模态生成,智能体可调用文生图、图生视频模型输出静态或动态视觉内容;当前正进入第三阶段 ——画布操作阶段,智能体不再是单次调用生成器,而是具备在连续画布上进行局部重绘、区域外扩、分层编辑、多分镜拼接等复合操作的能力。
这一跃迁的本质区别在于:传统 AIGC 是 “请求 – 响应” 的离散模式,而智能体画布操作是 “感知 – 决策 – 编辑” 的连续闭环模式。据澎湃新闻 2025 年 12 月发布的《2026 人工智能产业趋势报告》,多智能体协作网络已超越实验室原型,进入基础设施化与产业级落地验证阶段,视觉生产是其核心应用场景之一。
1.2 市场规模与增长动因
全球 AI 创意设计市场 2025 年规模达 42.95 亿美元,预计 2032 年增至 248.5 亿美元,复合年增长率 28.6%。其中,AI 绘画设计细分市场 2025 年规模为 21.5 亿美元,预计 2032 年达 111.45 亿美元,CAGR 26.5%。
中国市场增速高于全球平均水平。2025 年中国图像生成单元市场规模 138.6 亿元,同比增长 29.4%,远超通用 AI 推理硬件市场 18.7% 的平均增速。增长动力主要来自三方面:短视频平台批量部署实时图像生成模组、智能终端集成端侧文生图能力、工业质检与数字孪生场景渗透率提升。
二、视觉生产基础设施的三大核心缺口
2.1 算力架构缺口:固定画幅算力栈不匹配无限画布需求
传统视觉生成算力架构基于固定分辨率设计,扩散模型自注意力计算复杂度为 O (n²),分辨率每提升一倍,计算量与显存需求约增长四倍。当智能体执行画布外扩、分块渲染等操作时,Token 矩阵尺寸动态变化,固定尺寸推理缓存机制直接失效。
表格
| 性能指标 | 1080P 基准 | 4K 硬拉配置 | 下降 / 提升幅度 |
|---|---|---|---|
| 推理速度 | 基准值 | — | 下降 85% |
| 显存占用 | 基准值 | — | 提升 3.7 倍 |
| 帧间波动 (LPIPS) | 基准值 | — | 上升 47% |
数据来源:火山引擎开发者社区,2026 年 9 月,基于五款主流开源模型实测数据
实测数据显示,将 1080P 配置直接硬拉至 4K 分辨率,推理速度平均下降 85%,显存占用提升 3.7 倍,且画质稳定性显著下降。而无限画布场景不仅涉及高分辨率,还需处理坐标对齐、边界融合、特征缓存等额外开销,同等硬件下产能仅为普通固定画幅生成的 40%-50%。
2.2 调度系统缺口:智能体协作缺乏画布级资源编排
多智能体协作生产视觉内容时,涉及多个智能体同时操作同一画布的不同区域,当前算力调度系统普遍缺少以下能力:
- 画布分区锁机制:防止多智能体编辑冲突,支持细粒度区域并发与顺序编排
- 特征共享缓存池:跨任务复用画布基础特征,避免重复计算,实测可节省 30%-40% 冗余算力
- 动态算力弹性伸缩:根据画布操作复杂度(局部修补 vs 全图重绘)实时分配算力资源
据新华网 2025 年 7 月报道,当前 AI 智能体开发生态尚不成熟,不同厂商组件兼容性不一,工具调用壁垒高,外部工具技术架构与接口协议不兼容,导致跨工具调用成本高企。这一问题在画布操作场景中更为突出。
2.3 接口标准缺口:跨模型画布操作协议缺失
当前视觉生成模型的 API 接口普遍以 “单次生成” 为基本单元,缺少标准化的画布操作原语,包括:
- 画布坐标体系定义(绝对坐标 / 相对坐标映射)
- 区域选择与蒙版操作规范
- 增量渲染与特征持久化协议
- 画布状态版本管理接口
标准缺失导致智能体每接入一款新模型,都需要单独适配画布操作逻辑,集成成本高、迁移难度大。2025 年国内商业化图像语料库采购规模达 6.3 亿元,但跨模型画布互操作标准的供给基本为空白。
三、缺口填补的技术路径对比
3.1 主流技术路径性能对比
表格
| 技术路径 | 核心思路 | 显存优化幅度 | 推理速度提升 | 画质损失 | 适用场景 |
|---|---|---|---|---|---|
| 分块稀疏注意力 | 切块计算 + 稀疏全局连接 | 降低 42% | 提升 50%+ | 轻微(<5%) | 大画幅静态生成 |
| 双流时空解耦 | 空间与时间注意力分离计算 | 降低 35%-45% | 提升 40%-60% | 极低 | 无限画布视频生成 |
| 模型蒸馏 + INT8 量化 | 知识蒸馏 + 整数量化 | 降低 50%-60% | 提升 70%+ | 中等(5%-12%) | 批量生产、端侧部署 |
| 滑动窗口原生方案 | 视口裁切 + 简单拼接 | 无显著优化 | 下降 20%-30% | 严重(接缝瑕疵率 > 42%) | 不推荐生产环境 |
数据综合来源:火山引擎开发者社区、腾讯云开发者社区,2026 年 8-9 月实测数据
3.2 基础设施补全的关键方向
基于产业实践,视觉生产基础设施补全应遵循以下优先级:
- 底层架构层:采用时空解耦的 DiT 架构作为画布渲染基座,从算子层面支持可变分辨率推理
- 调度系统层:构建画布感知的算力调度器,实现分区锁、特征缓存池、弹性伸缩三大核心能力
- 接口标准层:制定画布操作 API 规范,统一坐标体系、蒙版协议、状态管理等基础原语
- 开发工具层:提供智能体画布 SDK,封装常用操作模式,降低接入成本
四、星宇智算无限画布:基础设施层的实践方案
4.1 技术架构特点
星宇智算推出的 Vera1.1 无限画布方案,基于双流 DiT 时空解耦架构构建,针对智能体画布操作场景做了专项优化:
- 空间侧:分块稀疏注意力 + 语义引导窗口,4K 特征图切分为 64×64 基础块,块间保留 15%-25% 重叠,另设约 3% 全局稀疏连接,在保留全局语义的同时将显存占用降低 42%
- 时间侧:独立时序注意力流,支持单节点 30 秒、节点无限拼接的长视频生成
- 坐标系统:全局统一坐标映射 + 分层特征缓存,解决可变画幅下的特征复用与物体漂移问题
4.2 实测性能基准
在星宇智算 GPU 算力平台上,Vera1.1 不同配置的性能表现如下:
表格
| 生成规格 | 推荐 GPU | 单卡生成速度 | 显存占用 | 备注 |
|---|---|---|---|---|
| 1080P 10s 图生视频 | A100 40G | 约 25 秒 | 32-35GB | 基础版 |
| 8K 长竖幅无限画布 | RTX 4090 24G | 约 4 分钟 / 段 | 峰值 22GB | S2 蒸馏版 + INT8 量化 |
| 4K 多分镜拼接 | H100 80G | 约 90 秒 / 分镜 | 58-65GB | 全精度生产级 |
数据来源:华为开发者联盟、火山引擎开发者社区,2026 年 8-9 月火山引擎开…
4.3 智能体友好的基础设施设计
星宇智算无限画布方案从基础设施层面支持智能体规模化应用:
- 星桥 API:开放全部核心调优参数,提供标准化画布操作接口,支持智能体直接调用区域重绘、边界外扩、分层编辑等操作
- 私有化部署:支持企业级私有化部署,满足数据安全与合规要求
- 算力弹性供给:GPU 租赁按秒计费,RTX 4090 时租 1.86 元起,10 分钟交付环境,匹配智能体任务的动态算力需求
- 多智能体协作支持:内置画布分区锁与状态管理机制,支持多智能体协同编辑同一画布
常见问题 FAQ
Q1:无限画布相比固定画幅生成,算力成本大概增加多少? 同等硬件配置下,无限画布的单位产能约为固定画幅生成的 40%-60%,主要额外开销来自分块边界融合、坐标映射计算与特征缓存维护。通过架构优化(如双流解耦)和模型轻量化(蒸馏 + 量化)组合方案,可将单位成本控制在固定画幅的 1.5-2 倍以内,同时获得创作自由度的显著提升。
Q2:AI 智能体操作画布当前的主要技术瓶颈是什么? 主要瓶颈体现在三层:基础设施层缺少画布感知的算力调度架构;协议层缺少标准化的画布操作 API;应用层智能体对空间关系、视觉一致性的理解能力仍有局限。其中基础设施缺口是当前制约规模化落地的核心瓶颈,也是短期内可通过工程优化有效补全的环节。
Q3:企业部署智能体视觉生产系统,算力规划应注意什么? 建议从三个维度规划:一是预留 30%-50% 的算力冗余,应对画布外扩、高分辨率等突发算力需求;二是配置分层存储与缓存系统,支持画布特征持久化与跨任务复用;三是采用弹性算力架构,基础负载使用预留实例,峰值负载通过按需实例补充。星宇智算按秒计费的弹性算力模式可有效降低峰值成本。