一、企业文档检索的普遍痛点:找资料比做方案还费时间
在多数企业内部,知识资产正以非结构化文档的形式高速积累 —— 产品手册、合同文件、技术规范、会议纪要、培训材料分散在不同系统与部门中。传统关键词检索模式存在三个难以突破的瓶颈:
词汇失配导致召回率低。员工用口语化表述查询时,与文档中的专业术语无法字面匹配,”售后退款规则” 和 “订单退货政策” 在字符层面完全不同,系统无法识别二者语义一致。据行业统计,知识工作者平均每天花费约 2.5 小时查找资料,其中大量时间消耗在 “猜关键词” 上。
无法穿透内容本身。扫描件、截图、命名不规范的附件无法被传统检索识别,大量有价值信息沉淀为 “文档坟场”,看得见却搜不到。
知识孤岛效应明显。不同部门的文档系统相互独立,跨系统检索需要多次切换账号,信息整合成本极高,关键政策更新后全量同步周期可达 72 小时以上。
二、向量语义检索:从 “匹配字符” 到 “理解意思”
向量语义检索的核心逻辑是将文本内容映射到高维语义空间,用向量之间的距离衡量语义相似度。相比传统关键词检索,它具备三大核心优势:
- 理解同义表达:能够识别 “账号找回” 与 “重置密码”、”性能优化” 与 “加速推理” 等不同表述的同一概念,大幅提升信息召回率
- 支持自然语言提问:员工可以直接用日常口语提问,无需刻意拆解关键词,系统自动识别查询意图
- 跨文档语义关联:自动挖掘不同文档之间的内容关联,返回语义最相关的片段而非整份文档,定位信息更精准
在企业文档检索场景中,向量检索与关键词检索结合的混合检索模式,已成为当前的主流落地方案,兼顾语义泛化能力与精确匹配需求。
三、实操步骤:基于星桥 API 向量接口搭建检索平台
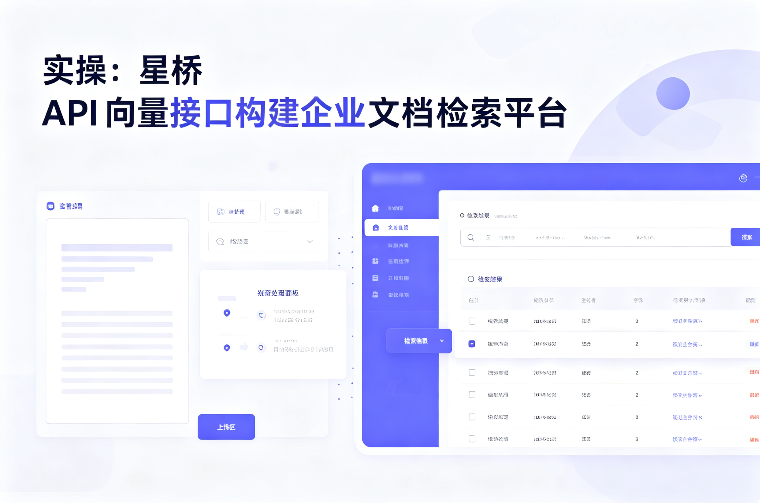
依托星宇智算星桥 API 的向量接口能力,企业无需自行训练与部署 Embedding 模型,通过标准化接口即可快速构建完整的文档检索系统,整体实施可分为四个核心阶段。
1. 文档预处理与分片
首先对企业存量文档进行结构化处理,支持 PDF、Word、Markdown、TXT 等多种常见格式。
- 提取文档纯文本内容,去除格式冗余信息
- 按照语义完整性进行文本分片,单片段控制在 512-2048 字符区间
- 保留文档来源、页码、所属分类等元数据信息,便于后续结果溯源
2. 调用星桥 API 生成文本向量
星桥 API 已接入十余款主流向量模型,包括通义 text-embedding-v4、智谱 glm-embedding-3 等,全面兼容 OpenAI Embedding 接口协议,企业可根据业务场景选择适配模型。
核心调用流程:
- 注册星宇智算账号并获取 API 密钥
- 通过统一接入地址
https://api.starverse-ai.com/v1发起请求 - 传入待向量化的文本片段,指定模型名称
- 接口返回 float32 类型向量数组,同时附带 token 用量统计
from openai import OpenAI

client = OpenAI(
    base_url="https://api.starverse-ai.com/v1",
    api_key="sk-your-api-key"
)

response = client.embeddings.create(
    model="aliyun-text-embedding-v4",
    input=["企业文档检索系统建设方案"]
)

vector = response.data[0].embedding
该模式下企业无需维护 GPU 推理环境,按量计费,支持弹性扩缩容,峰值场景自动调度资源,大幅降低技术门槛与运维成本。
3. 向量存储与索引构建
将生成的文本向量存入向量数据库并建立索引,是实现高效检索的关键环节。企业可根据数据规模选择对应方案:
- 中小规模知识库(十万级片段以内):可选用轻量型向量数据库,部署简单运维成本低
- 中大型企业(百万级以上):推荐采用分布式向量数据库,支持高并发检索与亿级向量规模
索引算法普遍采用 HNSW 方案,在召回率与查询延迟之间取得最佳平衡,P95 延迟可控制在 50 毫秒以内,满足实时检索体验要求。
4. 检索服务封装与前端交互
完成向量库构建后,将检索能力封装为标准服务接口,对接企业内部系统:
- 用户输入查询内容时,先调用星桥 API 生成查询向量
- 在向量数据库中执行相似度检索,返回 Top-K 相关文档片段
- 结合元数据进行结果排序与过滤,按相关性展示给用户
- 可进一步对接大模型实现检索增强生成(RAG),直接输出结构化答案
四、星桥 API 向量服务的核心企业级优势
1. 多模型一站接入,灵活切换
星桥 API 平台已覆盖通用、法律、医疗、代码等多个领域的向量模型,企业通过单一密钥即可调用全部能力,切换模型仅需修改参数,无需重复对接多家厂商,大幅降低集成成本。
2. 标准化协议,迁移零成本
全面兼容 OpenAI 接口规范,现有基于 OpenAI 生态开发的业务代码可零修改迁移,保护企业已有技术投入。支持 Python、Java、Node.js 等多种主流开发语言,适配不同技术栈团队。
3. 稳定可靠,全维度监控
平台服务可用性达 99% 以上,提供调用量、时延、成功率等全维度指标监控,支持用量统计与账单明细查询,便于企业进行成本核算与资源管控。
4. 数据安全合规
全链路数据加密传输,企业文档数据不出本地环境,仅文本片段参与向量化计算,满足金融、政务等强合规行业的数据安全要求。
五、落地价值:从文档管理到知识激活
基于星桥 API 构建的企业文档检索平台,能够为企业带来多维度的效率提升:
员工效率提升:信息检索时间缩短 60% 以上,员工无需在多个系统间反复切换,将更多精力投入核心业务工作。
知识资产沉淀:企业隐性知识得到结构化留存,新员工入职培训周期显著缩短,人员流动带来的知识流失风险大幅降低。
业务响应加速:客服、技术支持等一线岗位可以秒级定位对应政策与方案,客户问题响应速度提升数倍,服务质量与满意度同步改善。
RAG 应用底座:向量检索能力是检索增强生成系统的核心组件,在此基础上可快速扩展智能问答、政策解读、代码辅助等更多 AI 应用,一步构建企业知识中枢。
星宇智算星桥 API 持续为企业提供低成本、高可用的 AI 模型接入服务,除向量接口外,同时覆盖文本生成、图像创作、视频生成等全品类模型能力,助力企业以最小投入完成智能化升级。如需体验向量检索能力,可前往星桥 API 平台注册开通,获取免费试用额度。