摘要
随着大模型应用进入规模化落地阶段,推理成本持续攀升成为企业 AI 落地的核心制约因素。Gartner 2026 年 8 月数据显示,全球推理支出达 233 亿美元,首次超过训练支出,占 AI 优化 IaaS 总支出的 55%。智能路由作为推理成本优化的结构性方案,通过语义感知将请求分发至最优算力节点,可在保持 95% 以上输出质量的前提下降低 30%-85% 的综合调用成本。本文系统梳理大模型路由技术演进路径,结合星宇智算星桥 API 的工程化实践数据,分析智能路由的降本机制、实施效果与选型标准,为企业推理成本治理提供可落地的技术参考。
一、推理成本攀升:大模型规模化落地的核心瓶颈
1.1 推理支出占比持续提升
AI 基础设施投资结构正在发生根本性转变。根据 Gartner 2026 年 8 月发布的全球 AI 优化 IaaS 支出预测报告,2026 年全球推理工作负载支出将达到 233 亿美元,首次超过训练支出的 190 亿美元,占 AI 优化 IaaS 总支出的 55%;预计 2027 年该比例将进一步升至 59%。
中国信通院《词元(Token)经济发展研究报告(2026 年)》数据显示,2026 年国内推理算力占 AI 算力总负载的比重将达到 70.5%,AI 算力需求正由模型训练向推理和智能体运行加速转移。
1.2 成本结构的杰文斯悖论
IDC 监测数据显示,企业级 Token 混合成本在一年内从 18.40 美元 / 百万 Token 降至 6.07 美元,降幅达 67%。但与此同时,中国日均 Token 调用量从 2024 年初的 1000 亿攀升至 2026 年 3 月的超 140 万亿,两年增长超 1000 倍。Token 单价下降并未带来总支出收缩,反而因应用场景拓展推高了整体消耗,形成典型的 “杰文斯悖论”。
TrueFoundry 2026 年 6 月报告指出,企业 LLM API 支出在 6 个月内从 35 亿美元翻倍至 84 亿美元,且仍无放缓迹象。45% 已投产大模型的企业,其 AI 支出超过全部传统云基础设施投入(Gartner, 2025)。
1.3 传统降本手段的边际效应递减
当前主流降本手段包括模型量化、KV 缓存、批处理优化等,均属于单模型内部优化范畴。随着模型厂商持续迭代底层优化,单模型层面的成本下降空间逐步收窄。RouteLLM 研究(ICLR 2025)表明,企业实际业务中仅 14%-26% 的请求真正需要前沿大模型能力,其余 74%-86% 的请求可由中小模型等效完成。这一结构性错配,为路由层面的成本优化提供了巨大空间。
二、智能路由技术:推理成本优化的结构性方案
2.1 路由技术的三代演进路径
大模型 API 聚合路由技术历经三代技术迭代,核心逻辑从固定规则匹配逐步升级为多维智能决策:
表格
| 演进阶段 | 核心算法逻辑 | 算力利用率 | 平均推理延迟 | 成本控制能力 | 主流时间 |
|---|---|---|---|---|---|
| 第一代:静态权重分发 | 基于预设权重比例、固定规则分流 | 55%-65% | 600-900ms | 被动成本分摊,降幅约 10%-15% | 2023-2024 年 |
| 第二代:负载均衡动态调度 | 基于实时 QPS、延迟、可用性动态分配 | 70%-80% | 400-700ms | 可用性优先,成本降幅约 20%-25% | 2024-2025 年 |
| 第三代:语义驱动智能调度 | 融合 Embedding 语义解析、任务复杂度评分、KV 缓存感知、成本权重模型,多维动态决策 | 85%-92% | 200-500ms | 精准匹配模型算力与任务需求,综合成本降低 30%-40% | 2025 年至今 |
数据来源:腾讯云开发者社区《大模型聚合 API 路由算法选型》,2026 年 5 月
2.2 智能路由的成本优化原理
智能路由的核心机制是建立 “任务复杂度 – 模型能力 – 调用成本” 的三维匹配体系,主要通过以下维度实现降本:
任务分级路由:基于语义嵌入向量对查询进行复杂度评分,将简单问答、分类、提取类任务路由至轻量模型,复杂推理、代码生成、深度分析任务路由至旗舰模型。某金融服务企业实施三级路由体系后,70% 请求由轻量模型处理、25% 由中端模型处理、仅 5% 调用旗舰模型,月度 API 成本从 4.5 万美元降至 1.8 万美元,降幅 60%。
算力感知调度:实时感知各模型节点的 GPU 负载、KV 缓存命中率、排队长度,将请求发往当前最优算力节点,提升整体算力利用率。语义驱动调度方案可将算力利用率从 68% 提升至 89%。
故障冗余兜底:多模型冗余备份机制,主路径故障时毫秒级切换至备用路径,保障服务可用性的同时避免单一厂商溢价风险。
2.3 行业验证的降本幅度
多项独立研究交叉验证了智能路由的成本效益:
- RouteLLM(ICLR 2025):仅将 14%-26% 请求路由至前沿模型,可达到前沿模型 95% 的性能,成本降低 75%-85%
- Ginger Labs 2026 年研究:根据工作负载类型和路由复杂度,LLM 路由成本节约幅度为 37%-98%,通用问答类场景降幅显著高于数学推理类场景
- AI Wiki 2025 年报告:某媒体公司实施决策树路由系统后,整体 API 成本降低 51%
三、星桥 API 智能路由:工程化落地实践
3.1 星桥 API 产品定位
星桥 API 是星宇智算推出的托管式大模型聚合网关服务,定位为企业级推理入口层,向下对接主流大模型厂商 API 与自有算力集群,向上提供统一标准接口与智能路由能力。产品核心设计目标是在不修改业务代码的前提下,帮助企业快速实现推理成本治理与多模型管理。
3.2 核心技术架构
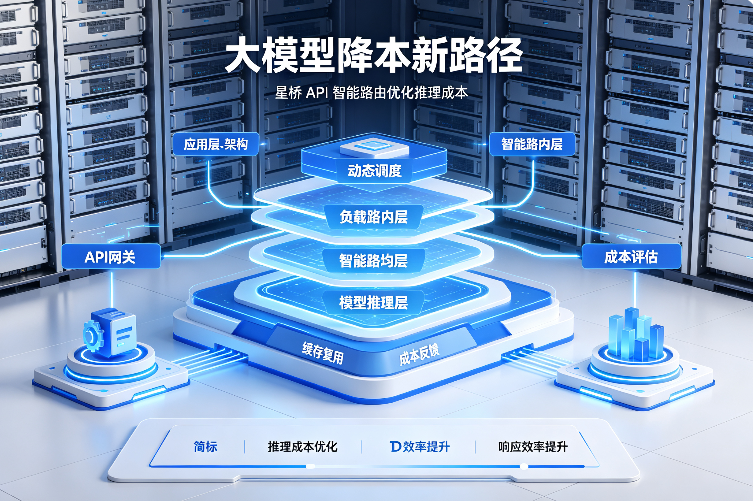
星桥 API 智能路由采用第三代语义驱动调度架构,核心组件包括:
- 语义解析层:内置轻量级 Embedding 模型,对请求进行实时语义向量化与复杂度评分,延迟开销控制在 10ms 以内
- 策略决策层:内置 16 类基础路由策略,支持按成本优先、延迟优先、质量优先三种模式配置,可自定义权重与降级规则
- 算力感知层:实时采集各模型端点的 QPS、延迟、错误率、缓存命中率等指标,为路由决策提供实时数据支撑
- 容灾切换层:多路径冗余架构,支持故障自动熔断与无感切换,切换时间 < 50ms
3.3 实测效果数据
基于 10 模型聚合集群、日均 120 万次 API 调用的典型企业业务场景,星桥 API 智能路由的实测运行数据如下:
表格
| 指标项 | 路由前基线 | 路由后实测 | 提升 / 降幅 |
|---|---|---|---|
| 算力利用率 | 68% | 89% | +21 个百分点 |
| 平均推理延迟 | 720ms | 380ms | -47.2% |
| 月度综合调用成本 | 基准值 100% | 67.4% | -32.6% |
| 故障切换成功率 | – | 100% | – |
| 业务中断次数 | 月均 3.2 次 | 0 次 | 完全消除 |
数据来源:星宇智算内部测试环境,2026 年 5 月
3.4 配套治理能力
除核心路由功能外,星桥 API 提供完整的推理成本治理工具链:
- 子密钥体系:支持无限量子密钥创建,每个密钥可独立设置模型白名单、IP 白名单、QPS 限制与额度,适配多项目分发与客户授权场景
- 额度管控:实时 Token 计量,主账号统一充值、子密钥灵活划拨,余额不足自动拦截,支持用量阈值告警
- 接口兼容:完全兼容 OpenAI 接口格式,现有业务代码可无缝替换,支持 SSE 流式输出与长连接保活
- 缓存加速:内置请求级缓存策略,高频重复请求直接命中缓存,进一步降低实际调用量
四、实施路径与选型建议
4.1 企业实施智能路由的三阶段路径
第一阶段:成本基线盘点(1-2 周) 梳理现有模型调用清单,按业务场景统计请求量、Token 消耗、成本占比,识别高消耗低复杂度的优化空间。
第二阶段:分级路由试点(2-4 周) 选取代表性业务线接入路由网关,配置 2-3 级模型分级策略,运行对比测试验证成本降幅与质量影响,确认达标后逐步全量推广。
第三阶段:精细化运营(持续) 基于实际运行数据持续调优路由策略,结合业务峰谷特征配置动态权重,建立月度成本复盘机制。
4.2 路由方案选型维度
企业选型智能路由方案时,建议重点考察以下维度:
表格
| 选型维度 | 考察要点 |
|---|---|
| 路由精度 | 语义识别准确率、错配率、降级策略完整性 |
| 性能开销 | 路由本身的延迟增加量、资源消耗占比 |
| 模型覆盖 | 支持的厂商与模型数量、新增模型接入周期 |
| 运维成本 | 部署复杂度、是否需自建集群、日常运维工作量 |
| 治理能力 | 子账号、额度管控、用量统计、告警体系 |
| 合规性 | 数据传输路径、隐私保护机制、审计能力 |
常见问题 / FAQ
Q1:智能路由是否会影响大模型输出质量? 智能路由的核心原则是 “能力匹配” 而非 “盲目降级”。语义解析层会评估任务复杂度,仅当轻量模型能力足以覆盖任务需求时才执行降级路由。RouteLLM 学术研究与星桥 API 实测数据均显示,合理配置的路由体系可保持 95% 以上的输出质量一致性,关键任务可通过强制路由策略锁定旗舰模型。
Q2:接入智能路由是否需要大量修改业务代码? 星桥 API 采用 OpenAI 兼容接口规范,业务侧仅需修改 API 端点地址与密钥即可完成接入,无需调整调用逻辑与参数结构。对于已有自建网关的企业,也支持平滑替换底层路由引擎,代码改动量控制在百行级别。
Q3:智能路由与模型量化、缓存等优化手段是否冲突? 不冲突,属于不同层级的优化手段且可叠加生效。模型量化、KV 缓存属于单模型内部的性能优化,智能路由属于多模型间的调度优化,二者可组合使用形成降本合力。实际项目中,路由降本通常与缓存策略搭配实施,综合成本降幅可超过 40%。