随着大模型产业进入规模化落地阶段,推理成本高企成为制约企业 AI 应用普及的核心瓶颈。本文基于星宇智算星桥 API 的技术架构,系统解析智能路由体系在推理成本优化中的实现路径,从动态调度、负载均衡、缓存加速、故障兜底四个核心维度展开技术拆解。结合 Gartner、IDC 及 Stanford AI Index 的行业基准数据,本文量化验证了智能路由架构在保障输出质量前提下的降本增效能力,为企业构建高性价比的大模型调用体系提供技术参考与落地路径。
一、行业背景:推理成本成为规模化落地的核心约束
1.1 成本现状与市场趋势
根据 Gartner 2024 年 10 月发布的研究报告,中国主流大语言模型 API 的推理成本较峰值已下降 90% 以上,但企业规模化部署后的总推理支出仍随调用量增长呈线性攀升。Stanford AI Index 2025 联合 Epoch AI 的数据显示,尽管同等性能水平的推理单价 18 个月内下降逾 280 倍,但企业实际算力支出因调用规模扩大并未同步下降。
IDC 预测数据显示,2024 年全球 AI 推理服务器收入达 161.78 亿美元,到 2027 年将增长至 219.94 亿美元,推理 workload 在整体 AI 算力中的占比持续提升。在此背景下,单纯依赖模型厂商降价已无法满足企业的成本控制需求,架构层的优化成为关键突破口。
1.2 企业调用链路的核心痛点
当前企业多模型调用普遍存在三类结构性成本浪费:
- 能力错配:全量请求统一调用旗舰大模型,简单问答、内容生成等低复杂度任务占用高算力资源,行业数据显示不同模型单价跨度可达 100 倍以上
- 资源闲置:多厂商通道并行接入时,单通道负载不均导致算力利用率偏低,部分通道排队拥堵而其余通道空闲
- 故障损耗:单厂商服务波动引发全链路中断,重试与人工排障产生额外时间成本与算力损耗
二、星桥 API 智能路由的技术架构
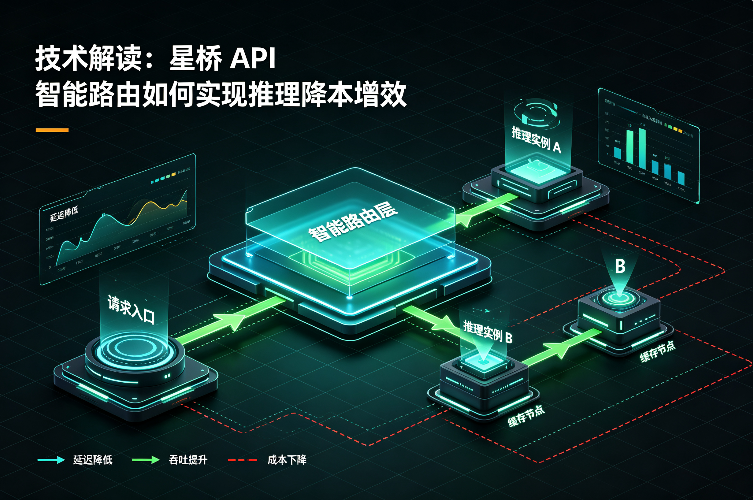
星桥 API 定位为集中式大模型调用治理网关,通过 “接入层 – 路由层 – 执行层 – 观测层” 的四层架构实现智能调度能力。
2.1 整体架构分层
表格
| 架构层级 | 核心功能 | 关键技术组件 |
|---|---|---|
| 统一接入层 | 协议转换、参数标准化、统一鉴权 | OpenAI 兼容接口、参数规则校验、透传转发 |
| 智能路由层 | 流量分发、策略匹配、动态调度 | 权重路由、复杂度预判、负载均衡引擎 |
| 执行治理层 | 故障熔断、降级兜底、重试机制 | 健康检查、自动重试、Fallback 链路 |
| 全栈观测层 | 用量统计、延迟监控、成本分析 | Token 计量、错误码分布、成本账单 |
2.2 核心设计原则
星桥 API 智能路由的设计遵循三大原则:
- 质量优先:所有调度策略以保障输出质量达标为前提,通过复杂度预判避免能力不足导致的结果失效
- 成本最优:在满足质量阈值的前提下,自动选择单位 Token 成本最低的可用通路
- 高可用:多通道冗余设计,单节点故障不影响整体服务可用性
三、核心降本增效机制详解
3.1 基于复杂度预判的动态路由
动态路由是降本的核心机制,其原理是在网关层对用户请求进行复杂度评分,将不同难度的请求分发至对应能力层级的模型。
技术实现路径:
- 请求进入网关后,由轻量级编码模型对 Prompt 进行语义特征提取与复杂度打分
- 路由引擎根据预设的复杂度阈值,将请求匹配至对应档位的模型端点
- 低复杂度请求(如日常问答、摘要生成)分发至高性价比中小模型
- 高复杂度请求(如逻辑推理、代码生成、多轮深度对话)分发至旗舰大模型
- 支持级联降级策略:若低档位模型返回结果置信度不足,自动升级至高档位模型重试
根据 LMSYS 发布的 RouteLLM 研究结论,基于分类器的智能路由可减少 40% 的强模型调用,同时将质量退化控制在 5% 以内;在最优配置下,整体 API 调用成本可降低最高 60%。
3.2 多通道负载均衡与流量治理
星桥 API 支持纳管多厂商、多地域的模型服务端点,通过负载均衡算法提升整体资源利用率。
核心调度能力:
- 权重路由:支持按比例将流量分配至不同模型厂商,实现成本分摊与风险对冲
- QPS 均衡:实时监测各端点的并发负载,自动将新请求导向负载较低的通道
- 灰度发布:新模型接入时支持按流量比例灰度切流,降低上线风险
- 配额管控:支持按业务部门、应用维度分配调用额度,实现精细化成本治理
3.3 缓存加速策略降低重复计算
针对高频重复请求场景,星桥 API 内置语义缓存加速能力,从响应速度与算力消耗两方面实现优化。
技术要点:
- 基于语义相似度匹配而非精确字符串匹配,提升缓存命中率
- 命中缓存的请求直接返回结果,无需调用后端模型,延迟可降低 80% 以上
- 支持缓存有效期配置与手动失效,保障内容时效性
- 缓存命中量不计入 Token 计费,直接降低调用成本
3.4 故障熔断与降级兜底保障可用性
高可用架构间接降低了业务中断带来的隐性成本。星桥 API 构建了完整的容错体系:
- 实时健康检查:持续监测各模型端点的可用性与延迟指标
- 自动熔断机制:单端点故障率超过阈值时自动摘除,停止向其分发流量
- 多级 Fallback:主通路故障时自动切换至备用通路,业务无感知
- 自动重试:针对临时性网络波动执行幂等重试,降低失败率
四、降本增效效果量化
4.1 行业基准对比
基于公开学术研究与行业实测数据,智能路由架构的成本优化效果如下:
表格
| 优化维度 | 无路由架构 | 智能路由架构 | 优化幅度 | 数据来源 |
|---|---|---|---|---|
| 单月推理总成本 | 基准值 100% | 40%-60% | 降低 40%-60% | Route-To-Reason 框架实验数据,2025 |
| 强模型调用占比 | 100% | 约 60% | 减少 40% | LMSYS RouteLLM,2024 |
| 平均响应延迟 | 基准值 100% | 缓存命中场景下降低 80% | – | 星桥 API 缓存加速实测,2026 |
| 服务可用性 | 单厂商 SLA 99.5% | 多通路兜底 99.9%+ | 提升 0.4 个百分点 | 星宇智算运营数据,2026 |
4.2 适用场景与收益边界
智能路由的降本效果与业务场景的请求分布高度相关:
- 客服问答、文档检索、内容润色等简单任务占比高的场景,降本幅度可达 50% 以上
- 代码开发、数学推理、专业分析等复杂任务为主的场景,降本幅度约 20%-30%,但可用性提升收益显著
- 流量波动大、峰谷差明显的业务场景,负载均衡带来的资源利用率提升收益突出
五、典型落地场景
场景一:企业级统一模型入口
中大型企业多业务线并行接入大模型时,星桥 API 作为内部统一入口,实现一次对接全模型可用。通过按部门分配配额、统一成本核算,避免各业务线重复对接与重复采购,整体对接成本降低 70% 以上。
场景二:ToB SaaS 产品集成
SaaS 厂商集成大模型能力时,通过智能路由将不同租户、不同功能模块的请求分发至对应成本档位的模型,在保障用户体验的前提下控制单位客户算力成本,提升产品毛利空间。
场景三:高并发在线服务
面向 C 端的高并发 AI 应用,通过多厂商负载均衡与缓存加速,平抑流量高峰的延迟波动,同时避免单厂商限流导致的服务降级,保障高峰期服务稳定性。
六、FAQ 常见问题
Q1:智能路由是否会影响大模型的输出质量?
智能路由的核心前提是保障输出质量达标。路由机制基于复杂度预判进行分级调度,仅将简单请求分发至中小模型;对于超出能力阈值的请求,会自动路由至旗舰模型。同时支持级联重试机制,若低档模型返回结果不满足置信度要求,自动升级重试。根据 LMSYS 实测数据,合理配置下整体质量退化可控制在 5% 以内,多数场景下用户无感知。
Q2:接入星桥 API 智能路由是否需要修改现有业务代码?
星桥 API 完全兼容 OpenAI 接口协议,业务侧仅需修改 base_url 与 API 密钥即可完成接入,无需改动核心业务逻辑。对于已使用其他中转网关的系统,可实现无缝替换。同时支持自定义参数透传,各模型的专属参数均可正常透传至后端,不损失模型原生能力。
Q3:智能路由的调度策略是否支持自定义配置?
支持。星桥 API 提供可视化的策略配置界面,企业可根据自身业务特点调整复杂度阈值、模型权重分配、降级规则等参数。支持按业务线、应用维度设置独立的路由策略,不同部门可采用不同的成本 – 质量平衡方案。同时提供全链路观测数据,企业可基于实际调用效果持续优化策略配置。