一、为什么你的检索系统需要重排序能力
在构建企业知识库、智能问答或 RAG 应用时,很多开发者会遇到一个共性问题:向量检索能召回大量候选内容,但排在前面的往往不是最相关的,真正能回答问题的片段被淹没在列表中后段。
这是检索系统的固有特性决定的。初步召回阶段(向量相似度、BM25 关键词匹配)优先保证召回率,目标是 “不漏掉任何可能相关的内容”,但对排序精度的把控能力有限。向量余弦相似度只能衡量语义层面的大致关联,无法判断文档是否真正解答了用户的具体问题;关键词匹配则完全不理解语义意图。
重排序(Rerank)正是解决这一痛点的核心组件。它位于检索链路的 “召回之后、生成之前”,专门负责对初步召回的候选集进行二次精排,通过深度语义计算给每篇候选文档打出相关性分数,让最匹配用户意图的内容优先呈现。工业界实测数据显示,引入高质量重排序模型后,检索系统 Top-N 准确率可提升 15% 至 40%,RAG 回答的事实准确性与引用质量也会同步改善。
二、Rerank 重排序的核心技术原理
2.1 基本工作逻辑
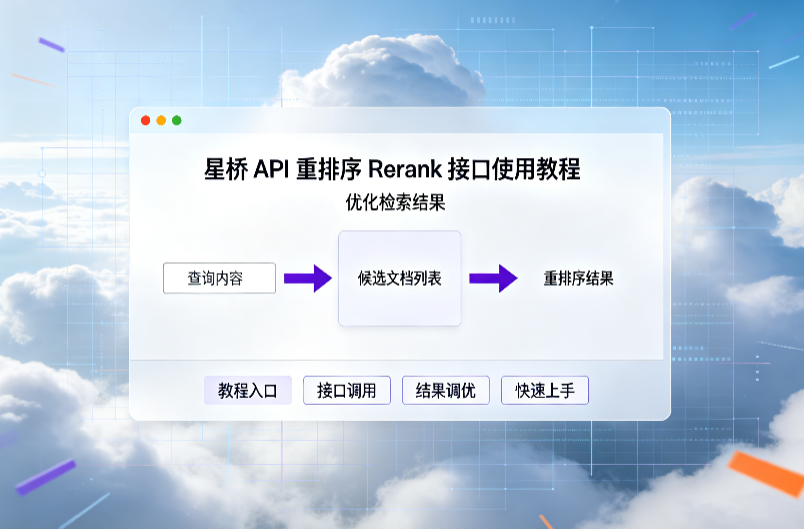
重排序模型的核心机制可以概括为三步:接收用户查询与候选文档集合 → 逐一对查询和每篇文档做交叉语义计算 → 输出 0-1 区间的相关性分数并按分数重排。分数越高,代表该文档与当前查询的匹配度越好。
与向量检索的 Bi-Encoder 架构不同,主流 Rerank 模型采用 Cross-Encoder 交叉编码结构。向量模型是分别对查询和文档编码后再计算相似度,计算效率高但精度有限;重排序模型则是将查询与文档拼接后共同输入 Transformer 进行深度交互,能捕捉更细粒度的语义匹配关系,因此排序质量显著更高。
2.2 在检索链路中的定位
一套完整的高阶检索系统通常采用 “两阶段架构”:
- 第一阶段:粗召回。通过向量检索、关键词检索等多路召回策略,从海量文档中快速筛选出 Top50-Top200 候选集,追求高召回率与低延迟
- 第二阶段:精排。调用 Rerank 模型对候选集逐一打分重排,最终输出 Top3-Top10 高质量结果,追求高精度
这种 “宽进严出” 的设计,在保证系统整体响应速度的同时,最大化了前排结果的相关性,是目前工业界的标准方案。
三、星桥 API Rerank 接口能力概览
星宇智算星桥 API 平台已上线多款主流重排序模型,覆盖文本排序与多模态排序场景,开发者无需自建推理环境,通过统一 API 接口即可调用,大幅降低部署与运维成本。
3.1 已接入的重排序模型
- glm-rerank:智谱 AI 推出的文本重排序模型,适合中文场景下的语义精排,在通用知识库、企业文档检索场景表现稳定
- aliyun-qwen3-rerank:基于通义千问大模型底座训练的文本排序模型,支持 100 + 语种与长文本输入,效果对齐开源 Qwen3-Rerank 系列,适用于多语言检索、RAG 等场景
- aliyun-qwen3-vl-rerank:多模态重排模型,可深度理解文本、图片、视频等多模态信息,满足图文混合检索、多媒体知识库等进阶需求
所有模型均通过星桥 API 统一网关接入,接口规范一致,切换模型仅需修改模型 ID 参数,无需重构业务代码。
3.2 星桥 API 的核心优势
- 即开即用:无需本地部署模型、无需 GPU 服务器,注册获取 API 密钥即可调用
- 稳定可靠:底层依托自研 XyClaw 智能路由引擎,全国 12 个节点冗余部署,故障切换≤30ms,接口可用性达 99.95%
- 成本可控:按实际 Token 消耗量计费,无最低消费门槛,账单明细可追溯
- 统一生态:与星桥 API 平台上的 Embedding 向量模型、大语言模型无缝搭配,一套密钥打通 RAG 全链路
四、星桥 API Rerank 接口快速上手
4.1 接入准备
- 登录星宇智算官网,进入星桥 API 控制台
- 创建 API 密钥,获取 Endpoint 地址与鉴权凭证
- 在模型列表中选择所需的 Rerank 模型,记录模型 ID
4.2 接口调用示例
Rerank 接口的标准输入包含三个核心参数:查询语句(query)、候选文档列表(documents)、返回结果数量(top_n)。接口会返回重排序后的文档列表,每条结果包含原文内容、相关性分数与原始索引位置。
典型调用流程:先通过向量检索召回一批候选文档,再将这批文档连同用户查询一同送入 Rerank 接口,拿到精排后的结果,最后截取 TopK 送入大模型生成回答。
4.3 最佳实践参数建议
- 候选集规模:建议传入 20-100 篇候选文档。数量太少会限制重排序的优化空间,数量太多则会增加延迟与成本
- 返回数量:RAG 场景下通常取 Top3-Top5 即可满足生成需求
- 分数阈值:可设置 0.3-0.5 的分数截断线,低于阈值的文档即使被召回也不送入生成环节,避免噪声干扰输出质量
五、典型应用场景与落地方案
5.1 企业知识库问答
企业内部文档、产品手册、规章制度等知识库场景,用户提问往往具体且聚焦。仅靠向量检索容易出现 “语义相近但答非所问” 的情况。接入 Rerank 后,系统能更精准地定位到包含答案的具体段落,显著提升员工查询效率与回答准确率。
5.2 电商商品搜索
电商搜索场景中,用户查询意图多样,既包含属性描述也包含功能诉求。重排序模型可以综合理解用户需求与商品标题、详情、参数等多维度信息,优化商品排序结果,提升点击转化率。
5.3 多模态内容检索
对于包含图片、视频的多媒体知识库,可选用多模态 Rerank 模型,实现跨模态的相关性排序。例如用户输入文字描述,系统先召回图文候选,再通过多模态重排模型精筛出最匹配的图片或视频片段。
六、性能优化与成本控制
6.1 延迟优化策略
重排序会增加检索链路的耗时,对响应速度有要求的场景可采取以下优化手段:
- 控制候选文档数量,避免无意义的大规模重排
- 采用两阶段重排架构:先用轻量模型做二次粗筛,再用高精度模型做最终精排
- 对高频查询开启结果缓存,重复请求直接返回缓存的重排结果
6.2 成本控制方法
- 并非所有查询都需要走重排序。简单查询、明确关键词匹配的请求可直接返回召回结果
- 根据业务重要性分级:核心高价值场景使用高精度模型,普通场景使用性价比更高的模型
- 结合星桥 API 的用量阶梯折扣,月消耗规模越大单价越低,可统筹业务用量降低单位成本
七、总结
重排序是检索系统从 “能用” 迈向 “好用” 的必经之路,也是 RAG 应用提升回答质量的关键优化点。对于大多数开发者和企业而言,自建重排序模型的训练、部署与运维成本较高,通过星桥 API 调用成熟的商用模型是更高效的选择。
星桥 API 提供了多档位、多模态的重排序模型能力,配合平台已有的 Embedding 向量模型与大语言模型,可一站式搭建完整的 RAG 检索增强生成链路。开发者只需聚焦业务逻辑本身,无需操心底层算力与模型运维,就能快速上线高质量的智能检索与问答能力。