摘要
当前 AI 产业正经历深度成本内卷:同等性能水平的推理成本 18 个月内下降逾 280 倍,但企业实际 AI 支出仍以年均 25%-50% 的速度攀升。算力成本占头部 AI 企业总支出 57%-70%,全球 88% 的企业已布局 AI 应用,仅 39% 实现实质性财务回报。成本下降与支出增长的剪刀差,折射出企业在模型选型、调度效率、用量治理三个层面的系统性缺位。星宇智算旗下星桥 API 通过统一接入网关、智能路由调度、全链路可观测三大核心能力,构建 “算力 + 模型” 一体化控本体系,帮助企业在不牺牲业务效果的前提下实现 AI 成本的精细化治理。
一、AI 成本内卷的行业现状与数据佐证
1.1 推理成本的指数级下降曲线
从技术供给侧看,AI 推理成本正以超摩尔定律的速度下行。根据 Stanford AI Index 2025 联合 Epoch AI 发布的数据,在 MMLU 基准上达到 GPT-3.5 同等水平(64.8% 准确率)的调用成本,已从 2022 年 11 月的每百万 token 20 美元,降至 2024 年 10 月的每百万 token 0.07 美元,18 个月内下降幅度超过 280 倍。
Epoch AI 在《The Plunging Price of Thought》报告中进一步指出,自 2023 年以来,达到同等性能水平的推理成本平均每季度下降约 47%,折合年化下降约 13 倍。arXiv 收录的研究数据显示,2023 年第一季度至 2025 年第四季度期间,同等质量下的推理成本累计降低 99.3%,同等价格下的模型性能提升 46.7%。
1.2 企业实际支出的反向增长
与技术侧成本下行形成鲜明对比的是,企业侧的 AI 实际支出持续攀升。Cloud Capital 2026 年 6 月对 100 家企业 CFO 的调研显示:
表格
| 企业类型 | 基础设施支出占营收比例 | 年增速区间 |
|---|---|---|
| AI 原生企业 | 约 33%,半数超 30% | 25%-50%+ |
| AI 赋能企业 | 中位数 16%-20% | 25%-50%+ |
数据来源:Cloud Capital《The Cost of Compute: AI Edition》,2026 年 6 月
Epoch AI 的测算显示,Anthropic、Minimax、智谱三家头部 AI 企业中,算力支出占总成本的比例高达 57% 至 70%,全面超过人才薪酬。其中 Anthropic 2025 年总支出约 97 亿美元,仅算力一项便达 68 亿美元。
1.3 投入产出失衡的规模悖论
麦肯锡调研数据显示,全球 88% 的企业已布局 AI 应用,但仅有 39% 实现了实质性财务回报。IDC 调研进一步指出,AI 推理产生的海量数据回传导致企业带宽成本激增 3-5 倍,部分制造企业的 AI 算力集群年能耗成本已占其 IT 总支出的 25% 以上。
成本下降与支出增长的剪刀差表明:技术侧的降价红利并未充分传导至企业端,中间存在显著的效率损耗与治理空白。
二、企业 AI 成本失控的三大结构性成因
2.1 模型选型错配:高射炮打蚊子
MIT 与佐治亚理工的联合研究发现,开源模型已可以用约 13% 的成本达到闭源旗舰模型近 90% 的性能,但在实际企业应用中,这类高性价比模型的使用比例仍不足 20%。
造成错配的核心原因包括:
- 认知惯性:业务团队倾向直接选用知名度最高的旗舰模型,缺乏按任务分级的选型机制
- 切换成本:多厂商接口协议不统一,切换模型需改造代码,评估成本高
- 效果验证难:缺少标准化评测体系,难以量化不同模型在具体业务场景下的性价比
2.2 调度效率损耗:算力闲置与排队并存
行业平均 GPU 利用率约为 40%-50%,大量算力处于等待状态。效率损耗主要来自三个维度:
- 资源碎片化:不同业务线独立申请算力,峰谷错配导致整体利用率低下
- 静态预留:按峰值预留资源,平峰期大量 GPU 闲置
- 失败重试:单链路故障导致的重复调用,产生无效 token 消耗
2.3 用量治理缺失:账单黑箱与失控
多数企业面临 AI 支出的 “黑箱状态”:Cloud Capital 调研显示,能够清晰回答 “什么驱动了成本、哪些客户和产品产生了成本、价值是否匹配” 三个问题的企业占比极低。具体表现为:
- 缺少按部门、按应用的细粒度用量统计
- 无预算阈值与限流机制,异常调用导致账单失控
- 重复请求未缓存,相同问题反复计费
- 密钥分散管理,存在安全与成本双重风险
三、星桥 API 的理性控本提质框架
星宇智算星桥 API 定位为企业级集中式模型调用治理网关,以 “统一接入、智能调度、全栈治理” 为核心架构,系统性解决上述三大成本痛点,实现控本与提质的平衡。
3.1 产品架构三层设计
接入层:标准化统一入口
- 兼容 100 + 主流大模型的接口协议,对外提供标准化 RESTful 接口
- 全面兼容 OpenAI SDK,企业仅需修改 base_url 即可完成接入
- 支持 Python、Java、Node.js 等多语言 SDK,降低对接成本
- 统一鉴权体系,屏蔽底层厂商的参数与协议差异
治理层:智能调度与流量管控
- 内置权重路由、灰度发布、故障熔断、降级兜底等流量调度能力
- 支持按业务部门、应用系统分配调用配额,细粒度权限与流量管控
- 统一密钥管理与数据脱敏机制,避免业务系统直接接触模型密钥
- 多级 Fallback 兜底机制,单厂商故障时自动切换备用链路
运维层:全链路可观测
- 覆盖调用成功率、平均响应延迟、错误码分布、用量趋势等核心指标
- 调用日志全量留存,支持审计追溯
- 按部门、应用、模型多维度成本统计,实现账单透明化
- 实时监控告警,异常用量自动触发限流通知
3.2 控本提质的核心逻辑
星桥 API 的降本并非通过牺牲模型能力实现,而是基于效率提升与治理优化的结构性降本:
- 选对模型:按任务复杂度匹配最优性价比模型,而非一律使用旗舰模型
- 用好算力:通过智能调度提升资源利用率,减少闲置与浪费
- 管好用量:建立预算、限流、缓存机制,消除无效消耗
- 守住质量:多级兜底与故障转移保障服务可用性,不降低业务体验
四、核心降本路径与量化效果
4.1 路径一:智能路由实现模型分级调用
机制原理:基于任务语义复杂度的动态路由策略,将简单任务分发至轻量模型,复杂任务保留旗舰模型。企业可自定义路由规则,按业务场景设置模型分级策略。
参考效果:根据行业同类方案的实测数据,采用 “按问题匹配模型” 的智能路由策略,可在整体正确率超过单一旗舰模型的前提下,调用成本下降超过 50%。某 2000 人规模的开发团队通过智能路由引擎,将外部模型月度调用成本从 40 万元降至 20 万元,实现 50% 的成本缩减。
4.2 路径二:语义缓存消除重复调用
机制原理:支持精确匹配与向量语义相似度匹配的双层缓存机制。当用户请求命中缓存时直接返回结果,无需调用模型 API,从根本上消除重复请求的 token 消耗。
适用场景:客服问答、知识库检索、文档摘要等高频重复请求场景。对于 FAQ 类标准化问答,缓存命中率可达 30%-60%。
4.3 路径三:流量治理管控异常消耗
机制原理:
- 按部门、应用、密钥多级维度设置调用配额与预算阈值
- RPM(每分钟请求数)与并发连接数双重限流,防止突发流量冲击
- 异常调用模式识别,自动拦截恶意或错误配置导致的消耗
管控价值:从制度层面避免因代码 bug、误操作、攻击等因素导致的账单失控事件,将风险控制在预算范围内。
4.4 路径四:故障转移降低无效重试成本
机制原理:自研多级 Fallback 兜底机制,当主链路出现超时、错误率升高等异常时,自动将流量切换至备用模型或备用厂商链路,无需业务侧介入。
效果数据:通过预判式故障转移而非被动重试,亿级调用量场景下整体吞吐量提升约 90%,因重试产生的无效成本下降约 37%。
五、企业落地实施建议
5.1 三阶段实施路线
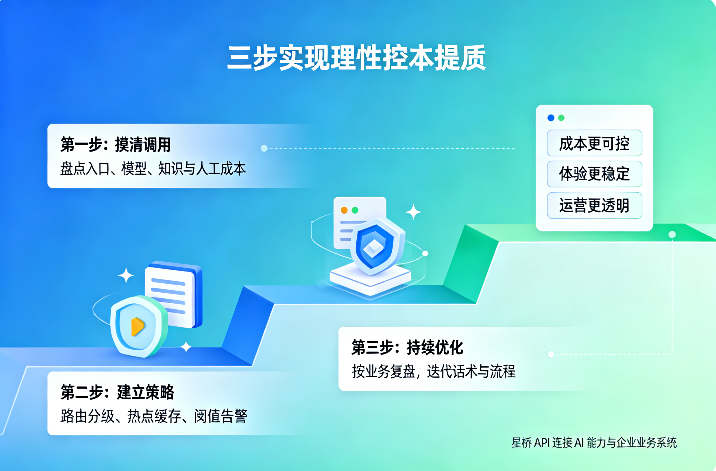
第一阶段:接入与透明化(1-2 周)
- 完成星桥 API 统一接入,替换原有分散的直连模式
- 启用全链路监控与用量统计,摸清当前成本结构
- 识别 Top 消耗场景与异常调用点
第二阶段:优化与治理(2-4 周)
- 针对高频场景部署语义缓存
- 按任务类型配置模型分级路由策略
- 设置部门级预算配额与限流规则
第三阶段:精细化运营(持续)
- 建立月度 AI 成本复盘机制
- 持续评测新模型的业务性价比,动态更新路由策略
- 结合业务数据核算 AI 投入产出比
5.2 关键成功要素
- 业务与技术协同:成本优化需业务部门参与定义效果标准,避免单纯追求低价而影响业务质量
- 数据驱动决策:基于真实调用数据而非主观判断进行模型选型与策略调整
- 渐进式推进:从非核心场景切入验证效果,逐步扩大覆盖范围,控制实施风险
FAQ
Q1:接入星桥 API 是否需要修改大量业务代码? A:不需要。星桥 API 全面兼容 OpenAI SDK 协议,企业仅需将接口地址替换为星桥 API 网关地址、更新 API 密钥即可完成接入,原有业务逻辑无需改造。对于使用其他厂商原生 SDK 的场景,也提供对应的协议适配能力。
Q2:通过星桥 API 调用模型,会增加额外的延迟吗? A:网关转发引入的额外延迟在毫秒级,通常远小于模型推理本身的耗时。同时,星桥 API 通过智能路由选择最优链路、就近节点接入、连接复用等优化手段,实际端到端体验通常优于单点直连。故障自动转移机制还可避免单链路故障导致的长时超时。
Q3:星桥 API 的数据安全性如何保障? A:所有调用请求经网关统一转发,业务系统不直接持有模型厂商密钥,降低密钥泄露风险。平台支持调用日志全量留存与审计追溯,满足企业合规要求。同时可配置数据脱敏规则,对敏感信息进行过滤处理后再转发至模型服务。