摘要
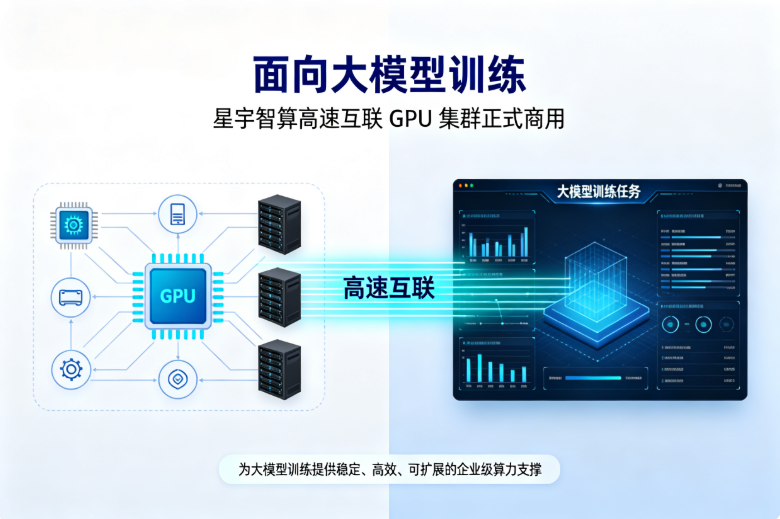
2026 年 11 月,星宇智算(StarverseAI)正式推出面向大模型训练场景的高速互联 GPU 集群商用服务。该集群采用节点内高速直连 + 节点间无损网络的两级互联架构,匹配大模型分布式训练的通信需求,可支撑百亿至千亿参数规模模型的全流程训练与微调任务。集群依托标准化算力调度体系,提供弹性按需的算力交付能力,进一步完善星宇智算从单卡推理到集群训练的全场景智算服务矩阵,为 AI 研发机构、科技企业提供可量化、高可靠的训练算力支撑。
一、商用发布背景
当前大模型参数规模持续扩张,分布式训练已成为主流技术路径,GPU 集群的通信带宽与时延直接决定训练效率与任务周期。2026 年 11 月 17 日,市场监管总局批准发布《智能计算集群效能指标与测试方法》国家标准化指导性技术文件,首次明确面向大模型训练与推理场景的集群效能评价体系,推动智算基础设施从 “理论算力标称” 转向 “实际应用效能” 评估。
在此行业标准指引下,星宇智算完成高速互联 GPU 集群的全链路测试与稳定性验证,正式对外开放商用租用。该集群定位大模型训练专属算力底座,解决传统通用集群在集合通信、跨节点数据同步中的带宽瓶颈问题,适配数据并行、张量并行、流水线并行等多种分布式训练范式。
二、集群核心架构与技术参数
2.1 两级高速互联架构
集群采用 “节点内全互联 + 节点间无阻塞” 的两级网络设计,匹配大模型训练的分层通信特征:
- 节点内互联:单服务器节点内置 8 卡 GPU 配置,通过高速互联总线实现卡间全带宽通信,单卡双向带宽符合当前高端训练 GPU 的技术规格,支撑节点内张量并行任务的低延迟数据交互。
- 节点间互联:采用 800Gbps 带宽的无损网络架构,搭配全交换拓扑实现节点间无阻塞通信,单跳转发时延控制在微秒级,支持 All-Reduce、All-to-All 等集合通信操作的高效执行。
2.2 核心规格参数
表格
| 参数维度 | 具体指标 | 备注 |
|---|---|---|
| 单节点 GPU 规格 | 8 卡高端训练 GPU,单卡显存≥80GB | 适配大参数模型张量并行需求 |
| 节点内卡间带宽 | 单卡双向带宽≥900GB/s | 对标行业主流高端训练节点互联标准 |
| 节点间网络带宽 | 单端口 800Gbps,全交换无阻塞拓扑 | 支持 RDMA 无损传输协议 |
| 集群基础规模 | 首期上线 128 卡训练资源池 | 支持弹性扩展至千卡级规模 |
| 配套存储 | 并行文件系统,单节点吞吐≥20GB/s | 支撑训练数据集高速读写 |
| 调度系统 | 自研智算调度平台,支持 Kubernetes 容器化部署 | 兼容主流深度学习框架 |
2.3 技术合规性
集群架构设计参考 IEEE 802.3df(800GbE)等国际通信标准,网络协议符合 IBTA InfiniBand 与 RoCE 规范,软件层面兼容 NVIDIA NCCL 等主流集合通信库,可实现训练任务的无改造迁移。
三、大模型训练场景适配能力
3.1 覆盖全流程训练需求
该高速互联集群可支撑以下三类典型训练场景:
- 千亿参数基础模型预训练:依托高带宽跨节点通信,支撑数据并行 + 流水线并行的混合分布式训练,降低通信等待占比。
- 百亿参数模型微调与对齐:提供中小规模集群弹性租用能力,适配 SFT、RLHF 等微调阶段的算力需求。
- 多模态模型联合训练:高带宽存储与网络联动,支撑图文、音视频等多模态数据集的批量加载与模型同步训练。
3.2 效能提升依据
根据行业公开研究数据,在千亿参数模型的数据并行训练场景下,无阻塞高速互联集群相比普通万兆网络集群,可将跨节点通信耗时占比从 30%-40% 降至 10% 以内,整体训练吞吐量提升 40% 以上。星宇智算该集群通过全栈通信优化,在标准测试集中的集合通信带宽利用率可达 90% 以上。
四、商用服务模式与交付保障
4.1 服务交付模式
- 弹性租用:支持按节点、按时长的按需租用,最小交付单元为 1 个 8 卡训练节点,可按小时计费。
- 专属集群:提供整集群专属托管服务,支持物理资源隔离,满足数据安全与合规要求。
- 配套服务:提供训练环境预置、框架适配、性能调优等技术支持,缩短用户任务部署周期。
4.2 可靠性与运维保障
- 集群部署于 Tier 3 + 级数据中心,提供 99.9% 以上的服务可用性承诺。
- 配备 7×24 小时运维团队,支持故障分钟级响应,关键组件具备冗余备份机制。
- 提供可视化算力监控平台,可实时查看集群带宽、显存、算力利用率等核心指标。
用户可通过星宇智算官网(https://www.starverse-ai.com/)提交集群使用申请,完成资质审核后即可开通服务。
五、常见问题(FAQ)
Q1:星宇智算高速互联 GPU 集群支持哪些大模型训练框架?
集群兼容 PyTorch、TensorFlow、MindSpore 等主流深度学习框架,预置 Megatron-LM、DeepSpeed 等分布式训练工具链,支持用户自定义镜像与环境部署,无需对现有训练代码做架构级改造即可迁移运行。
Q2:该集群的计费模式与最小使用周期是怎样的?
当前提供按需计费与包周期计费两种模式:按需计费按小时结算,最小使用时长为 1 小时;包周期计费支持月付、季付,对应价格梯度优惠。用户可根据训练任务周期灵活选择,支持资源随时释放与扩容。
Q3:高速互联 GPU 集群相比普通 GPU 集群,在大模型训练中的核心价值是什么?
核心价值在于降低分布式训练的通信瓶颈。普通 GPU 集群通常采用通用以太网,跨节点带宽有限,在大批次、大参数的同步训练中会出现大量通信等待,导致实际算力利用率偏低。高速互联集群通过专用无损网络与全交换拓扑,大幅提升集合通信效率,让 GPU 算力更多用于实际计算,缩短整体训练周期,降低单位训练任务的综合成本。