过去两年,AI 视频生成的进步肉眼可见。输入一段文字,十几秒就能出一条画面精致的短片。但仔细看会发现,绝大多数 AI 视频还是 “单镜头”—— 一个机位、一段连续动作,看完就结束。
真正的视频叙事,靠的是镜头之间的碰撞。远景交代环境,中景推进关系,特写捕捉情绪,几个镜头剪在一起,才叫蒙太奇。AI 视频要从 “炫技片段” 走向 “完整叙事”,多镜头切换是绕不过去的一关。
单镜头的天花板,早就摸到了
单镜头生成不是不行,而是不够用。
一条 5 到 10 秒的单镜头,画面可以很惊艳 —— 光影、质感、运镜都到位。但只要你想讲一个稍微复杂点的故事,问题就来了:角色换个角度就变脸,场景切个机位就走样,上一个镜头里的桌子在左边,下一个镜头跑到了右边。
不少创作者会问:AI 生成的多镜头视频,角色和场景到底能不能保持一致?
这不是提示词写得够不够细的问题。学术层面,FilmWeaver、EchoShot、HoloCine 等多个研究框架都把 “跨镜头一致性” 列为当前 AI 视频生成的核心瓶颈。现有模型大多基于独立的单镜头数据训练,镜头之间没有共享的 “世界记忆”,每生成一个镜头,模型都在重新脑补一遍环境。
说白了,AI 还没有一个统一、稳定的虚拟片场。
多镜头难在哪:三个绕不开的坑
多镜头生成的挑战,集中在三个层面。
第一是角色一致性。同一个人物,远景里是短发,特写变成长发;上一个镜头穿蓝色外套,下一个镜头变成灰色。人脸、服装、体型在跨镜头时极易漂移。
第二是空间逻辑断裂。不同镜头里,场景比例、物体相对位置、机位方位缺乏关联。你在 A 镜头里看到门在画面左侧,切到 B 镜头门可能就消失了。语言提示词描述三维空间本身就有天然短板,文字很难精准约束机位和物体方位。
第三是叙事节奏失控。就算每个镜头单独看都没问题,剪在一起也可能节奏不对 —— 该快的地方慢了,该留白的地方塞太满。蒙太奇的精髓在于镜头之间的时长、顺序和情绪衔接,这恰恰是 AI 最不擅长的 “全局感”。
有行业创作者反馈,在 AI 短剧制作中,跨镜头角色一致性和场景过渡是返工率最高的环节,相当比例的镜头需要人工调整才能串联成篇。
自动编排的思路:先搭世界,再拍镜头
面对这些难题,行业正在形成一个共识:不要逐镜头生成,先搭建完整的视觉蓝图,再让 AI 在固定的世界里完成 “拍摄”。
这条路径分几步走。
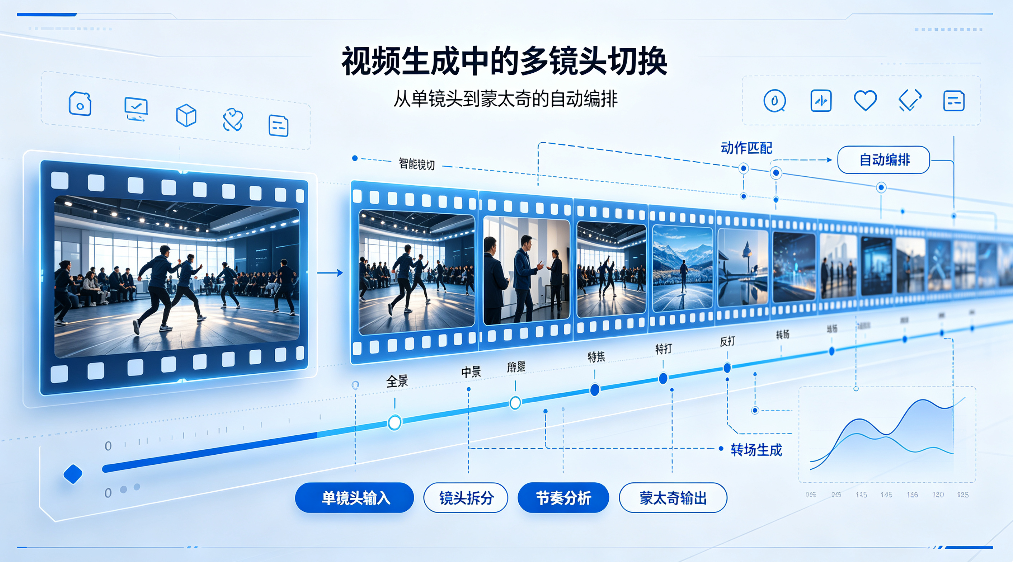
第一步,分镜规划前置。 在生成任何视频之前,先把整段叙事拆成镜头清单 —— 每个镜头的景别、机位、时长、画面内容、情绪目标全部定义清楚。这一步本质上是把导演的构思结构化,让后续生成有章可循。
第二步,视觉资产统一。 角色形象、场景设定、道具、色彩风格先固化为统一的视觉参考。所有镜头都基于同一套资产生成,从源头上减少漂移。
第三步,逐镜头生成与一致性校验。 在统一资产约束下逐个生成镜头,同时跨镜头校验角色、场景、光影的连贯性。发现偏差及时回调,而不是全部生成完再返工。
第四步,蒙太奇编排。 镜头全部就绪后,按叙事逻辑自动排列顺序、调整时长、匹配转场,形成完整的片段。
还有团队会问:自动编排出来的蒙太奇,节奏和情绪能跟脚本对上吗?
坦率说,目前自动编排更适合结构清晰、节奏明确的场景 —— 产品宣传片、科普短视频、资讯快讯。对于情绪细腻、节奏微妙的剧情类内容,人工剪辑的判断仍然不可替代。自动编排是提效工具,不是导演替身。
无限画布:多镜头生产的前置工作台
多镜头视频的质量,很大程度上取决于前置规划做得够不够细。星宇智算无限画布,正是在这个环节切入。
创作者可以在无限画布内完成整段视频的分镜草图 —— 每个镜头画一个缩略构图,标注景别、机位、画面主体,在画布上排列出完整的镜头序列。草图不需要精致,线稿、简笔标注就够,关键是把叙事结构和空间关系先定下来。
画布智能体自动识别每个分镜节点,梳理镜头之间的先后关系和依赖逻辑。同一套角色设定、场景参考可以在画布内统一管理,所有镜头共享同一套视觉资产,避免逐镜头重新定义导致的风格漂移。
分镜确认后,画布内的视觉资产可以直接对接视频生成模块。每个镜头的构图约束、角色参考、风格参数随镜头一起传递,减少生成阶段的信息损耗。整个过程中,创作节点、修改记录、版本分支全部留存可追溯,方便团队协作和后期复盘。
简单说,无限画布不直接替你剪片子,但它把 “拍之前” 的功课做扎实了 —— 分镜结构清晰、视觉资产统一、创作链路可追溯,后续多镜头生成才有稳定的底座。
离真正好用,还差几步
多镜头自动编排的方向是明确的,但现阶段也要看到边界。
技术层面,跨镜头一致性还没有彻底解决。即使有统一资产约束,复杂场景下的空间逻辑、光影连续性仍可能出现偏差。越长的视频、越多的镜头,累积误差越大。
成本层面,多镜头生成意味着多次调用、多次校验、多次返工。算力消耗和时间成本都比单镜头高不少,中小团队需要权衡投入产出。
人才层面,工具再智能,也需要有人懂分镜、懂叙事、懂蒙太奇。AI 可以加速执行,但 “拍什么、怎么剪” 的判断仍然依赖人的创作经验。
也有人担心:多镜头自动生成,是不是就不需要剪辑师了?
目前看不会。自动编排处理的是结构化、重复性的剪辑逻辑,而真正决定作品质感的,是节奏的微妙拿捏、情绪的精准把控、意外时刻的敏锐捕捉。这些恰恰是人的优势。工具变了,剪辑师的角色也在变 —— 从手动拼接素材,转向定义叙事规则、把控整体调性、做关键创意决策。
多镜头时代,叙事权还在人手里
AI 视频从单镜头走向多镜头,是技术演进的必然方向。蒙太奇自动编排的探索,正在把这条路径一步步走通。
但要记住,蒙太奇的本质不是镜头的排列组合,而是叙事的节奏与情绪。技术可以加速镜头生成,可以辅助编排效率,但最终决定一段视频好不好看、动不动人的,仍然是背后那个懂故事的人。
把前置规划做扎实,把视觉资产管统一,把创作链路理清楚 —— 这是多镜头时代每个创作者都需要补的课。星宇智算无限画布想做的,就是把这门课的工具备好,让创作者把更多精力放回叙事本身。