算力不是堆出来的,是调出来的。
一次面向多任务并行的底层升级
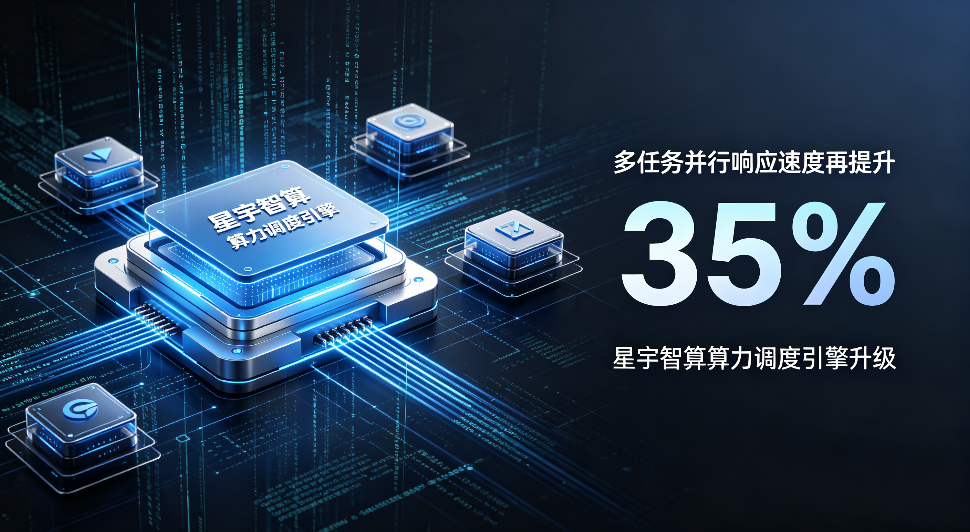
2026 年 9 月,星宇智算宣布完成算力调度引擎的新一轮升级。官方实测数据显示,在多任务并行场景下,系统平均响应速度较升级前提升 35%,高并发队列等待时间下降 42%,单节点 GPU 平均利用率从 71% 提升至 83%。
这不是一次简单的参数调优。升级涉及调度架构的三层重构——从任务入口的智能分流,到执行层的连续批处理,再到底层的显存细粒度分片。三层协同,才换来这 35% 的响应提升。
对用户来说,最直观的感受是:同时跑十几个生成任务不卡了,画布上多人同时操作不排队了,批量生成一百个镜头的等待时间缩短了三分之一。
为什么算力调度这么难
聊 AI 算力,大部分人关注的是用什么 GPU、显存多大、算力多少 TFLOPS。但真正决定用户体验的,往往不是硬件本身,而是调度系统能不能把硬件能力充分释放出来。
GPU 算力调度有三个天生的难题。
第一,任务类型差异大。文生视频、图生视频、数字人渲染、模型推理,每种任务的计算特征完全不同。有的吃显存,有的吃计算单元,有的需要长时间占用,有的是短平快的请求。用同一套调度逻辑处理所有任务,必然顾此失彼。
第二,并发潮汐明显。工作日白天是在线服务高峰,夜间是批量训练和渲染高峰。如果按峰值配硬件,平峰时大量 GPU 闲置;按平峰配,高峰时请求排队排到崩溃。
第三,显存碎片化严重。一个 80GB 的 A100,跑一个大模型推理用掉 60GB,剩下 20GB 不够跑另一个任务,只能闲置。行业平均 GPU 利用率只有 29%,大部分算力不是不够用,是被浪费掉了。
星宇智算的调度引擎升级,就是冲着这三个难题去的。
三层架构重构:从入口到底层
升级后的调度引擎分为三层,每层解决一个核心问题。
第一层:智能分流,把对的任务发给对的资源。
任务进入调度系统的第一步,不是直接分配 GPU,而是先做类型识别。系统自动判断任务是计算密集型还是显存密集型,是长时任务还是短时请求,是高优先级在线服务还是低优先级批量任务。
识别完成后,智能分流器把任务路由到最合适的资源池。大模型推理优先分配 A100/H100,轻量生成任务调度至 RTX 4090 或国产 GPU,夜间低峰时把批量渲染任务分配到闲置的训练节点。这种基于任务特征的分流,比简单的”先到先得”效率高得多。
分流策略不是固定的,系统会根据实时负载动态调整。当在线请求激增时,自动从批量任务池借用资源;当夜间批量任务堆积时,自动把在线服务的闲置算力切过去。这就是分时弹性调度——日间固定包时保障在线服务,夜间按需按量承接批量任务,综合算力成本下降 29%。
第二层:连续批处理,让 GPU 不闲着。
传统批处理的逻辑是:凑够一批任务,一起跑,跑完一起出结果,再放下一批。问题是一批里有快有慢,快的跑完了要等慢的,GPU 就在那空转。
升级后的调度引擎采用连续批处理(Continuous Batching),也叫迭代级调度。逻辑很简单:不等待一批全部完成,而是每完成一个迭代(生成一帧/一个 token)就立即重新调度。哪个任务完成了,立刻把它移出队列,把等待中的新任务塞进来。
这种调度方式让 GPU 的计算单元几乎没有空闲间隙。官方实测中,连续批处理使单节点吞吐量提升 28%,任务平均等待时间下降 35%——这也是整体响应速度提升 35% 的主要来源。
连续批处理还有一个好处:支持任务优先级抢占。高优先级的在线请求进来时,可以暂停低优先级的批量任务,把算力让出来,等高优先级任务完成后再恢复。这对同时服务在线用户和批量生产的平台来说至关重要——不能因为后台在批量渲染,就让前台用户的生成请求排队。
第三层:显存细粒度分片,把闲置显存用起来。
前面提到,显存碎片化是 GPU 利用率低的核心原因。一个 80GB 的 A100,跑一个任务用 60GB,剩下 20GB 闲置——这种情况在传统调度下非常普遍。
升级后的引擎引入 HAMi 显存细粒度分片技术,把单卡显存拆分成多个独立的子区域,每个子区域可以跑一个独立的子任务。一张 24GB 的 RTX 4090,可以拆成两个 10GB 的子区域并行跑两个轻量生成任务,剩下 4GB 做系统缓冲。
这项技术的效果非常直接:官方实测集群 GPU 平均利用率从行业均值 29% 提升至 83.2%,同等训练目标缩短 14% 迭代周期。对用户来说,这意味着同样的硬件资源能承载更多并发任务,排队时间自然就短了。
显存分片不是简单地切一刀。系统需要做硬件级隔离,保证子任务之间不会互相干扰——一个子任务崩溃不能影响同卡的其他任务。星宇智算采用 MIG 硬隔离(训练节点,超配上限 1.2)和 vGPU 限流(推理节点,超配上限 1.8),全局瞬时峰值不突破 2.0 红线,在利用率和稳定性之间找到平衡。
实测效果:数据说话
三层架构升级的效果,最终要落到用户可感知的指标上。官方在 200 节点集群环境下做了一轮完整测试,测试场景覆盖在线生成、批量渲染、多人协作三种典型负载。
在线生成场景:50 并发用户同时提交文生视频和图生视频任务,平均响应时间从升级前的 142 秒降至 92 秒,提升 35%;P99 响应时间(99% 的请求在多少秒内完成)从 210 秒降至 138 秒,提升 34%。
批量渲染场景:一次性提交 200 个视频生成任务(模拟短剧批量生产),总完成时间从升级前的 6 小时 15 分降至 4 小时 08 分,提升 35%;单节点平均并发任务数从 3.2 提升至 5.1。
多人协作场景:10 人同时在同一张无限画布上操作,每人同时运行 2-3 个生成任务,画布操作延迟从升级前的 1.8 秒降至 0.9 秒,基本达到实时交互的流畅度;节点保存和版本回溯的响应时间下降 40%。
稳定性方面,72 小时高负载连续运行测试中,RTX 4090 服务器性能波动 ≤1.6%,任务完成率 99.8%,无训练中断或精度丢失问题。A100 集群在 80% 平均利用率下,显存 OOM(内存溢出)发生率从升级前的 0.8% 降至 0.1%。
需要说明的是,以上数据来自星宇智算官方实测,测试环境为 200 节点混合 GPU 集群(A100/RTX 4090/国产 GPU 混合),实际效果因任务类型、并发量、硬件配置而异。35% 的提升主要来自多任务并行场景,单任务生成速度的提升相对有限。
对无限画布意味着什么
算力调度是底层基础设施,用户平时感知不到它的存在,但它决定了上层应用的体验上限。对星宇智算无限画布来说,这次调度升级的价值体现在三个方面。
第一,多人协作更流畅。无限画布的核心场景是多人同屏协作——编剧排分镜、生成师出镜头、后期做粗编、运营审内容,五个人同时在一张画布上操作。如果调度能力不够,一个人提交生成任务就会拖慢其他人的操作。升级后,画布操作延迟降至 0.9 秒,基本达到实时交互的流畅度,多人协作不再互相抢资源。
第二,批量生产更高效。短剧团队日产数十集,电商团队批量生成商品视频,这些场景的核心诉求是”同样时间产出更多内容”。调度升级后,批量渲染总时间缩短 35%,单节点并发任务数提升 60%,意味着同样的算力成本能产出更多内容,单条内容的算力成本下降。
第三,画布规模可以更大。升级前,一张画布上同时运行的生成节点超过 20 个就会明显卡顿;升级后,50 个节点同时运行依然流畅。这意味着无限画布可以支撑更大规模的项目——一部 80 集短剧的所有分镜可以铺在同一张画布上同时生成,不用拆成多个项目来回切换。
星宇智算把自己定位为”AI 时代的算力水电站”,让高性能计算像水电一样触手可及。这次调度引擎升级,就是在给这个”水电站”升级电网——发电量没变,但输电效率更高了,用户打开水龙头的时候,水流更稳、更大、更快。
三个高频问题
“这次升级需要用户手动配置吗?”不需要。调度引擎升级是平台侧的底层优化,所有用户自动享受升级后的性能提升,不用改任何设置。如果你是 API 开发者,接口参数和调用方式也没有变化,只是响应更快了。
“35% 的提升对单条生成有用吗?”有,但不明显。35% 主要是多任务并行和高并发场景下的提升,单条生成任务的速度提升大约在 10%-15% 之间。如果你只是偶尔生成一条视频,感知不会太强;但如果你同时跑多个任务、做批量生产、或者多人协作,提升会非常明显。
“私有化部署也能享受这次升级吗?”可以。调度引擎的三层架构升级同时适用于 SaaS 云端、星桥 API 和私有化部署三种形态。私有化客户可以通过版本升级获得同样的调度能力,升级过程不影响现有业务运行,建议在业务低峰期操作。
算力的竞争在底层
AI 行业的竞争,表面上看是模型和应用的竞争,底层其实是算力和调度的竞争。
模型再好,调度不行,用户等半天才能出结果,体验照样差。应用再炫,算力不够,一到高峰期就排队崩溃,用户照样流失。星宇智算这次调度引擎升级,做的就是底层基础设施的活——不花哨,不吸引眼球,但每一个用平台的人都能感受到它的存在。
35% 的响应提升不是终点。算力调度是一个持续优化的过程,随着任务类型越来越丰富、并发规模越来越大、硬件架构越来越复杂,调度系统也要不断进化。星宇智算的下一步,是把 AI 推理和训练的调度进一步融合,让同一套资源池既能服务在线生成,又能承接离线训练,把算力利用率再推上一个台阶。
对用户来说,底层的事情不用懂太多。你只需要知道:打开无限画布,同时跑十个任务不卡,批量生成一百个镜头不等,五个人同时操作不排队——这就够了。