一次面向成本透明化的升级
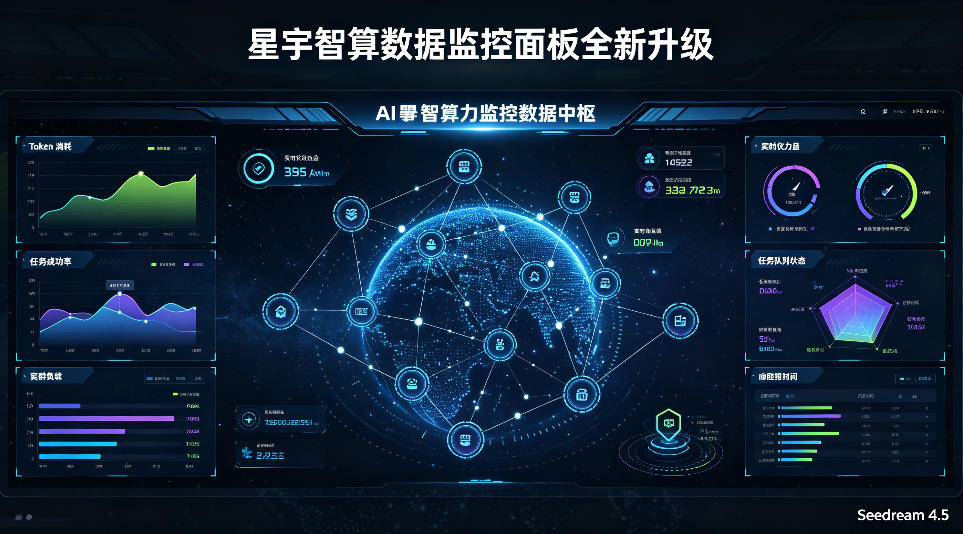
2026 年 9 月,星宇智算宣布完成数据监控面板的全新升级。升级后的面板将 Token 消耗、任务成功率、生成延迟、资源利用率四大核心指标实现实时可视化,支持按模型、按 API Key、按时间维度的多维度下钻分析,并新增异常消耗自动告警功能。
这次升级不是凭空造出来的。星宇智算此前已经有一套完整的基础设施监控体系——基于 Prometheus+Grafana 搭建,预配置了 GPU 利用率、显存占用、NVMe 存储、网络带宽等硬件指标,支持 DCGM 全指标采集和分级告警。但基础设施监控解决的是”硬件跑没跑”的问题,用户真正关心的是”钱花在哪了、任务成没成、哪个环节拖慢了”。
新升级的数据监控面板,就是从硬件监控走向业务监控的一步。对用户来说,最直观的变化是:打开控制台,不用再自己导日志、写脚本、算 Excel,Token 花了多少、哪个模型用得最多、任务成功率多少、异常消耗出现在什么时候,一眼就能看到。
AWS 在一篇关于 Token 全栈实践的博客里说得很直接:”可观测性是解决 Agentic AI Token 爆炸问题的前提——看不见的成本,无法优化。”星宇智算这次升级,做的就是让成本看得见。
升级后的六大功能模块
新监控面板分为六个功能模块,覆盖从宏观概览到微观明细的完整分析链路。
第一模块:总览仪表盘。 打开面板第一眼看到的就是总览,展示当日/本周/本月的核心指标汇总——总调用次数、总 Token 消耗、总生成时长、平均任务成功率、平均响应延迟、总费用估算。每个指标都支持和上一周期对比,涨了跌了一目了然。总览的设计原则是”30 秒看懂全局”,不用点进任何子页面,就能判断今天的业务是否正常。
第二模块:Token 消耗分析。 这是本次升级的核心功能之一。面板支持按模型、按 API Key、按时间粒度(小时/天/周/月)展示 Token 消耗趋势,输入 Token、输出 Token、缓存命中 Token 分别统计,支持 Top 排行和异常消耗标注。点击任意数据点可以下钻到该时段的调用明细,包括每次调用的提示词长度、生成长度、耗时、状态码。
需要说明的是,Token 消耗分析主要覆盖文本大模型调用。视频生成任务的计量方式不同——按生成时长(秒)和星元消耗统计,在同一个面板里有独立的”视频生成消耗”子模块,两者并列展示但不混算。用户可以在面板顶部切换”文本模型”和”视频生成”两个视图,分别查看对应计量数据。
第三模块:任务成功率监控。 另一个核心功能。面板实时展示任务完成成功率(定义为:提交的生成任务中,最终状态为”成功”的比例,不含用户主动取消的任务),支持按模型、按任务类型、按 API Key 维度拆分。成功率趋势图上会自动标注异常下降点,点击可以查看该时段的失败任务列表和失败原因分布。
失败原因分为几类:参数错误(参考图 URL 无法访问、参数超出范围等)、内容审核未通过、系统内部错误、超时。每类失败都有对应的排查建议,比如参数错误占比高,说明接入代码可能有 bug;系统内部错误占比高,需要联系技术支持。面板还支持设置成功率阈值告警——当某模型的 1 小时成功率低于 95% 时,自动通过邮件/站内信/ webhook 通知管理员。
第四模块:延迟与性能分析。 展示平均响应延迟、P95 延迟、P99 延迟的趋势,支持按模型和任务类型拆分。对视频生成任务,还展示排队时间、生成时间、后处理时间的分段耗时,帮助定位瓶颈是在调度排队还是模型推理。延迟面板支持和成功率面板联动——比如某个时段成功率下降,同时延迟飙升,基本可以判断是系统负载过高导致的。
第五模块:API Key 管理与配额。 每个 API Key 的独立用量统计、配额设置、调用频率限制都在这个模块管理。支持按 Key 设置月度 Token 配额和并发上限,达到配额的 80% 时自动预警,达到 100% 时自动暂停调用(可配置)。对多团队共用一个企业账号的场景,这个功能尤其重要——给每个团队分配独立的 Key 和配额,避免一个团队超预算影响全公司。
第六模块:调用日志与审计。 完整的调用明细记录,支持按时间、模型、Key、状态码、关键词多条件筛选,每条记录包含请求参数、响应结果、耗时、消耗计量、调用者 IP 等完整信息。日志留存 180 天,满足企业合规审计需求。支持导出 CSV 格式,方便和内部财务系统对账。
核心功能详解:Token 消耗怎么看
六大模块里,用户最关心的是 Token 消耗分析。这里单独展开讲一下怎么用。
进入 Token 消耗模块,默认展示最近 7 天的消耗趋势图,X 轴是时间,Y 轴是 Token 数量,三条线分别代表输入 Token、输出 Token、缓存命中 Token。图下方是按模型维度的消耗排行表,展示每个模型的总消耗、占比、环比变化。
几个实用的分析场景。
场景一:定位异常消耗。 某天 Token 消耗突然翻倍,在趋势图上点击那一天的数据点,下钻到按小时的消耗分布,找到消耗飙升的具体时段,再下钻到该时段的调用明细,看是哪个 API Key、哪个模型、什么类型的请求导致的。常见原因包括:某个测试环境的 Key 泄露被恶意调用、某个业务上线了新功能导致调用量暴涨、某个循环 bug 导致重复调用。定位到原因后,在 API Key 模块临时暂停该 Key 或调整配额,再排查修复。
场景二:成本优化分析。 看输入 Token 和输出 Token 的比例,如果输入 Token 占比过高(比如超过 70%),说明提示词太长,可以优化提示词模板、启用上下文缓存。看缓存命中率,如果低于行业平均水平(通常 30%-50%),说明请求的重复度低,或者缓存策略没配好,可以调整缓存键的生成逻辑。看模型分布,如果某个高价模型的调用量很大但任务简单,可以考虑切换到更轻量的模型。
场景三:团队成本分摊。 多团队共用企业账号时,按 API Key 维度导出各团队的月度消耗,直接用于内部成本核算和预算分配。不用再让每个团队自己报数,面板里的数据是最准确的。
对无限画布和 API 用户的价值
监控面板升级,对不同类型的用户价值不同。
对 SaaS 无限画布用户来说,价值主要在”生成任务管理”。无限画布的批量生成功能一次可以提交几十个任务,以前用户只能在画布上看每个任务的状态,没有全局视图。升级后,在监控面板里可以看到整个项目的任务成功率、平均生成时间、总星元消耗,哪个分镜的任务反复失败、哪个参数配置的成功率低,都能统计出来。对短剧团队来说,这意味着可以快速定位”哪些场景的生成质量不稳定”,针对性调整提示词和参数,而不是靠人工记忆和经验。
对星桥 API 开发者来说,价值主要在”成本控制和故障排查”。API 调用是按量计费的,没有监控就等于开着水龙头不知道流了多少水。Token 消耗分析帮助控制成本,任务成功率监控帮助快速发现接口故障,延迟分析帮助定位性能瓶颈,API Key 配额管理帮助防止超支。某接入星桥 API 的电商平台反馈,上线监控面板后,通过优化提示词和切换模型,月度 API 成本下降了 28%,同时任务成功率从 92% 提升到 98%。
对私有化部署客户来说,价值主要在”内部运营和合规审计”。私有化部署的监控数据完全存储在客户内网,面板支持自定义数据保留策略和访问权限,IT 管理员可以看到全公司的调用情况,业务部门只能看到自己的 Key 的数据。调用日志 180 天留存,满足金融、政务等行业的合规审计要求。
三个高频问题
“监控数据是实时的吗?延迟多久?”核心指标(调用次数、成功率、Token 消耗)的更新延迟在 5-15 秒之间,属于准实时。延迟来自两个环节:一是异步任务的状态同步(视频生成任务完成后需要回写状态),二是监控数据的聚合计算(面板展示的是聚合后的指标,不是原始日志流)。如果需要毫秒级实时监控,可以通过 API 拉取原始日志自己处理,但大部分场景下 15 秒以内的延迟足够用了。
“视频生成任务也能监控 Token 消耗吗?”视频生成不按 Token 计费,所以没有 Token 消耗数据。但面板有独立的”视频生成消耗”模块,按生成时长(秒)和星元消耗统计,支持按分辨率、时长、模型维度拆分分析。文本模型和视频生成的消耗在同一个面板里并列展示,顶部可以切换视图。如果你同时用文本模型(比如脚本生成、提示词优化)和视频生成,总览仪表盘会汇总两类消耗的总费用估算。
“监控面板的数据能导出吗?能对接我们自己的 BI 系统吗?”支持两种导出方式。一是在面板上直接导出 CSV,适合一次性的数据分析和对账。二是通过监控数据 API 拉取结构化数据,支持按时间范围、模型、Key 等维度查询,可以对接企业内部的 BI 系统、财务系统、告警系统。监控数据 API 的调用不计入业务 Token 消耗,属于管理接口。私有化部署客户还可以选择直接读取底层的 Prometheus 指标,完全自定义监控方案。
透明化是效率的前提
AI 算力的成本,正在从”硬件采购成本”转向”调用消耗成本”。
以前企业买 GPU 服务器,成本是固定的,买完就完了。现在用 API 和 SaaS,成本是动态的,调用越多花得越多,一个 bug 可能一夜之间烧掉一个月的预算。在这种模式下,没有监控就等于开车没有仪表盘——你不知道速度多少、油量多少、有没有故障,只能凭感觉开。
星宇智算这次监控面板升级,核心逻辑就是让每一分消耗都看得见、每一次失败都有迹可循、每一个瓶颈都能定位。从硬件监控到业务监控,从被动查日志到主动看面板,从事后对账到实时预警,这是 AI 平台成熟度的体现。
但监控只是第一步。看得见成本之后,还要懂得优化成本——提示词怎么写更省 Token、模型怎么选性价比最高、批量任务怎么调度效率最优、失败任务怎么自动重试。这些能力星宇智算会在后续版本中逐步加入,比如基于历史数据的智能参数推荐、自动成本优化建议、失败任务智能重试等。
对用户来说,不用等所有功能都上线。现在就打开监控面板,看看你的 Token 都花在哪了、任务成功率是多少、哪个模型用得最多。大概率你会发现一些以前不知道的消耗盲点,而发现问题,就是优化的开始。