无限画布的 “任意画幅”,不是一次渲染出来的,是分出来的。当分辨率从 1080P 拉到 4K 乃至 8K 超宽幅,单张显卡会直接撞上显存墙;把画面粗暴切块再拼接,又必然在接缝处留下明暗断层和元素错位。星宇智算 Vera 1.1 的解法,是在推理层做原生分片,并围绕空间、时间、特征、全局四个维度层层优化。本文把这套 “四层优化” 完整拆开。
先搞懂:无限画布到底难在哪
三个互相矛盾的需求挤在一起,才构成了技术门槛:
- 显存墙非线性增长:扩散模型显存随分辨率非线性上升,4K 全图推理的显存需求数倍于 1080P,单卡直接 OOM;
- 粗暴分块必出缝:各块独立降噪,光照、色彩、语义理解出现偏差,接缝处明暗分界、穿缝物体断裂错位;
- 时序漂移被放大:视频不是图片,分块越多,各块时序误差各自累积,拼起来 “这块快、那块慢”。
架构总览:不是切块拼接,而是分块原生
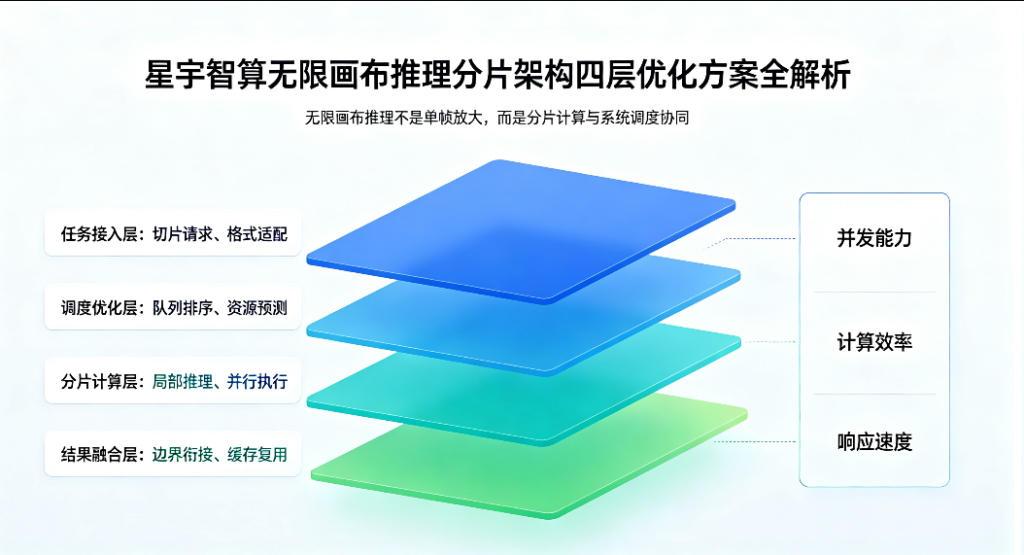
Vera 1.1 没有走 “切块生成+后期拼接” 的野路子,而是从模型推理层做分块原生设计,与双流 DiT 时序注意力架构完全打通:画布不会一次性渲染整张超大图,而是按 “空间块+时间片” 切片推理,再通过特征融合对齐 —— 对齐的不是像素,而是统一全局空间坐标系里的语义。四层优化,就架在这个骨架上。
第一层:自适应空间分块
不是平均切块,而是按内容动态决定:
- 基础分块默认 1024×1024 像素单元,支持 512–2048 区间动态调整;
- 重叠区默认占 15%–25%,画面元素越复杂,重叠比例越高;
- 遇到人物、LOGO 等核心主体时,自动偏移分块边界,避免关键主体被切开。
简单场景用大块提速,复杂场景用小块加重叠保一致 —— 不会像固定分块那样,要么浪费算力,要么拼出问题。
第二层:时序分片联动
只切空间不够,时间维度也要分片:
- 每个推理单元是 “空间块+时间片” 的组合,与 DiT 时序注意力窗口天然对齐;
- 时序分片默认 16 帧,片间保留 4 帧重叠帧,专门用于时序特征衔接;
- 每 8 个分片做一次全图特征校准,从根上掐断误差累积。
这一层,专治长视频的 “块间不同步”。
第三层:重叠区特征缓存与融合
消除拼接痕的核心模块:
- 每个分块推理时,把重叠区的 FP16 特征向量写入全局缓存池,相邻分块主动读取邻块特征作为自身推理的硬约束 —— 对齐的是特征,不是像素;
- 融合权重从重叠区中心向两侧平滑过渡,没有生硬的拼接边界;
- 融合后自动做色差校验,偏差超阈值即重算对应区域。
据第三方技术团队实测,这套机制把拼接处色差 ΔE 压到 2–3,人眼基本无法识别。
第四层:全局特征锚定
给所有分块定一个统一的 “审美标准”:
- 首帧生成时提取全局语义特征、色彩风格、主体特征向量;
- 此后所有分块、所有分片,都以这个全局锚点做基准对齐。
有了它,才不会出现 “这块偏冷、那块偏暖,这张脸尖、那张脸圆”。
数据说话:四层优化值多少
据公开压测(单卡 RTX 4090 24GB,统一 24fps):
- 全图推理 1080P:峰值显存 18.7GB,单帧 1.2 秒,主体一致性 94.7%;
- 全图推理 4K:显存需求 68.2GB,单卡无法运行;
- 固定分块+简单拼接 4K:显存 17.9GB,但拼接色差 ΔE 12.3,主体一致性掉到 82.1%;
- Vera 1.1 四层分块 4K:显存 19.3GB,单帧 5.1 秒,ΔE 2.1,主体一致性 93.8%;
- 超宽幅 7680×2160:显存 21.5GB,单帧 9.7 秒,ΔE 2.3,一致性 92.5%。
一句话总结:4K 下分块方案显存与 1080P 全图基本持平,横向画幅翻倍显存仅增约 11%,主体一致性几乎无损。代价是单帧耗时上升 —— 但用一张消费级显卡跑下原本要多卡集群的画幅,这笔账大部分团队算得过来。另据 A100-80GB 环境实测:像素级坐标偏差 ±1.3 像素,边界语义错误率 1.8%,热缓存命中率 89%。
工程落地:部署怎么选,参数怎么调
- 硬件选型:轻量测试单卡 RTX 4090 24GB(4K 以内);中型工作室双卡 4090 或单卡 H100(8K 以内、2–3 路并行);企业集群多机多卡 H100/昇腾 910B,配液冷节点支撑批量生产。
- 四个高频旋钮:分块大小(默认 1024,显存紧张降到 768)、重叠比例(默认约 0.2,高精度场景加到 0.3)、全局同步间隔(默认 8 分片,长视频建议缩到 4)、缓存精度(默认 FP16,开 FP32 画质更好但显存增约 30%)。
- 三个实战坑:分块别贪小(太碎调度开销反而暴涨)、重叠别低于 15%(纯色背景下会出亮线)、长视频别忘开全局同步(否则后半段色彩慢慢漂移)。
需要说明的是,这套架构也有边界:高频大幅度动作镜头的时序一致性会下降,它更擅长长镜头、全景延展和连续分镜 —— 选场景比堆参数更重要。
不想自己调?工作台把四层藏在了界面后面
四层架构是写给工程师看的;创作者面对的,是另一套语言。星宇智算 AI 视频工作台已内置完整无限画布能力,注册即用,支持 9 种主流画幅及自定义尺寸;每个节点自动留存提示词、参数、坐标,支持快照回滚与多人协作;需要嵌入自有业务系统可走星桥 API,数据敏感场景支持私有化部署(Ubuntu 22.04+、CUDA 12.1+,支持昇腾 910B 适配),生成内容全链路商用合规,按量计费。工程的复杂,最终都该收敛成用户的一次点选。
分而治之,连而不断
推理分片的本质,是把一道不可能的题 —— 单卡显存装不下的超大画幅 —— 拆成一道可计算的题。四层优化拆开看并不神秘:分对空间、切对时间、融好边界、锚住全局。真正拉开差距的从来不是追新模型,而是把每一块、每一帧、每一段特征都对齐到同一套标准上的工程耐心。这,才是无限画布之所以 “无限” 的底层原因。