一、散热不是配套,是起点
过去数据中心按”每机柜 5–8kW”规划风冷,现在一张 GB200 级别加速卡的热设计功耗已突破 1000W,整机柜功率密度直接跳到 130kW 以上。风冷的物理上限被击穿,液冷从”高端选项”变成”新建标配”。
当前主流路线有三条:
- 冷板式液冷:液体通过贴合芯片的金属背板带走热量,与现有服务器形态兼容、改造成本低,是当下部署量最大的方案,适配 30–80kW 主流机柜区间,PUE 通常可压到 1.1–1.25。
- 浸没式液冷:整机服务器浸入绝缘冷却液,散热能力最强,PUE 可低至 1.03–1.15,适用于单机柜 100kW 以上的超高密度场景,但初投资和运维门槛更高。
- 喷淋式:通过喷嘴向热源喷洒冷却液,目前工程化案例较少,多作为补充路线。
选型要点:不要一上来就追”全浸没”。先看芯片代际和机柜功率——30–80kW 区间冷板式性价比最优;超过 100kW、且锁定下一代 NVL 级整机柜,再评估浸没式。散热路线一旦选定,后续机柜结构、管路、CDU、二次侧水温都会被锁死,返工成本极高。
二、组网:GPU 数量上去了,瓶颈往往不在卡
千卡以上的分布式训练,真正决定吞吐的常常不是单卡算力,而是卡与卡之间怎么通信。
- 节点内:NVLink/NVSwitch 负责一台 8 卡服务器内部的高速互联,带宽和延迟远高于 PCIe。
- 节点间:这是设计重点。两条主流路线——
- InfiniBand(XDR 800G):原生无损网络,基于信用的流量控制,集合通信有效带宽可逼近 98%,是千卡级训练的事实标准。
- RoCEv2 以太网:在以太网上跑 RDMA,复用现有网络生态,但依赖 PFC + ECN + DCQCN “三件套”才能模拟无损,裸跑有效带宽在大规模集合通信中明显偏低,调优复杂度高。NVIDIA Spectrum-X 等新一代以太方案正在补齐这一差距。
- 通信库:NCCL(及其开源等价物 RCCL)负责 AllReduce、AllGather、ReduceScatter 等集合通信原语,配合 GPUDirect RDMA 让 GPU 显存与网卡直传,绕过 CPU 中转。
一个容易被忽略的判断:网络不是”把交换机买贵就行”。拓扑(Fat-Tree 还是 Rail-Optimized)、线缆长度、光模块质量、拥塞控制参数,任何一个短板都会让整张集群的有效算力打折。小规模测试跑通不代表千卡规模稳定,这是组网必须做规模压测的原因。
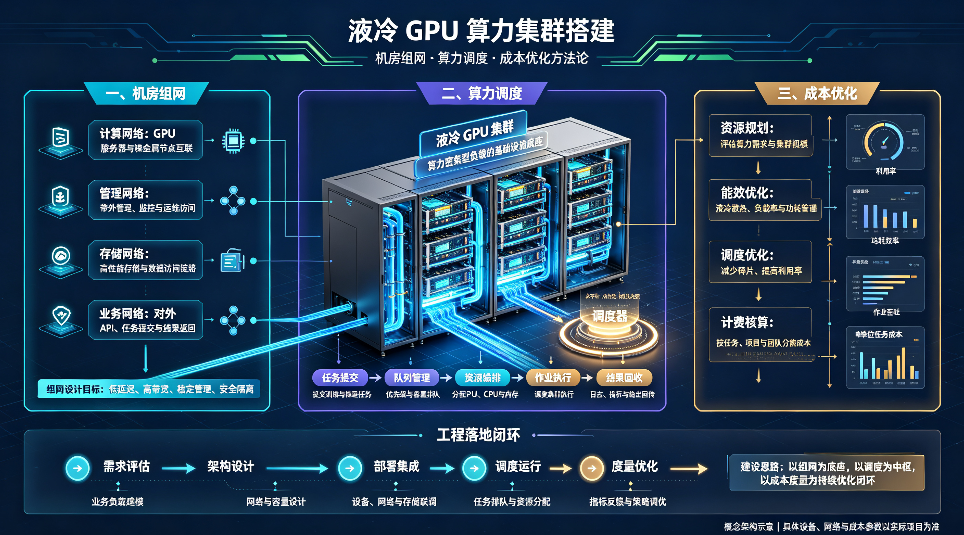
三、算力调度:硬件买对了,利用率上不去等于白买
行业里一个反复被验证的现象:整卡独占分配模式下,GPU 平均利用率长期偏低。调度层要解决的是”怎么把闲置的显存和算力捞出来”。
一套可落地的调度栈通常包括:
- 容器编排底座:以 Kubernetes 为通用底座,再叠批调度器。
- 批调度能力:Volcano、Kueue、Koordinator 等提供 Gang Scheduling(gang 调度)和 PodGroup 机制——分布式训练任务必须所有 GPU 同时到位才能启动,否则部分启动会造成资源死锁和空等。
- 拓扑感知调度:结合 NVLink / PCIe 拓扑信息做打分,尽量把通信密集的任务调度到 NVLink 域内,减少跨节点通信。
- 显存与算力切分:硬件级可用 NVIDIA MIG(仅限 A100/H100 等数据中心卡);软件级可借助 HAMi 等开源 vGPU 方案,通过 CUDA 层拦截把一张卡按显存、算力比例切给多个任务,无需改驱动、改应用。
- 混部与弹性:训练任务与推理任务按优先级混部,推理侧支持连续批处理(continuous batching)和时间片复用,峰值自动扩容、低谷自动缩容。
判断标准很朴素:调度做得好不好,不看功能列表,看两个数——GPU 平均利用率和任务排队时长。前者决定每一块钱折旧有没有变成产出,后者决定开发者愿不愿意用。
四、成本账:电费其实只占零头
很多人以为算力集群最贵的是电,这是一个常见误解。
按行业对 GW 级智算中心的 TCO 拆解,四年折旧周期下的成本结构大致是:
| 成本项 | 占比量级 | 说明 |
|---|---|---|
| GPU 加速卡及服务器折旧 | 约 45%–60% | 最大头,高端卡生命周期 3–4 年,闲置也在折旧 |
| 供电与散热配套 | 约 20% | 变配电、UPS、冷机、冷却塔、液冷管路 |
| 高速网络与存储 | 约 15%–20% | 交换机、光模块、RDMA 网卡、并行存储 |
| 实际电费 | 约 5% | 远低于直觉 |
这意味着三个反直觉的结论:
- 折旧是最大固定成本。卡买进来哪怕空跑,每天都在贬值。提升利用率不是”锦上添花”,是直接决定项目盈亏的杠杆。
- PUE 的价值不在省电费本身,而在腾出 IT 功率容量。省下来的配电和制冷容量,可以多塞 GPU。
- 选址影响极大。电价、气候(自然冷源时长)、土地和网络专线成本,在不同地区可以拉开显著差距。
自建、托管、云租赁三种模式没有绝对优劣:长期稳定、规模上千卡、有专职运维团队,自建 TCO 最优;规模不确定、业务波动大、想快速上线,弹性租赁的综合成本可能更低。关键是把利用率假设和折旧周期算清楚再决策,而不是被”自建更便宜”的直觉带着走。
五、从机房到画布:调度能力最终要落到业务上
液冷、组网、调度、降本——这一整套底层工程,最终服务的不是机房本身,而是跑在上面的业务能不能用得起、跑得快。
星宇智算(StarverseAI)在这条路径上的做法,是把底层液冷集群的弹性算力能力向上封装成两层:一层是面向开发者的 GPU 弹性算力租赁,预装 AI 环境、即点即用,把自建机房的重资产风险转成按需付费;另一层是面向内容生产的 无限画布——集 AI 剧本创作、多模态画布、3D 导演工作台与专业多轨视频剪辑于一体,创作者在云端画布上完成分镜、生成、合成、剪辑全流程,背后由调度系统在算力高峰自动扩容、低谷自动回收,按使用量结算。
这背后的逻辑和前面讲的方法论是一以贯之的:把 GPU 从”整卡独占的昂贵固定资产”,变成”像水电一样按量取用的生产资料”。中小团队不需要先建机房、养运维,也能调用到液冷级别的高密度算力;而对已经自建集群的团队,同一套调度思路——切分、混部、弹性——同样适用。
把钱花在刀刃上
液冷解决的是”装得下”,组网解决的是”跑得快”,调度解决的是”用得满”,成本优化解决的是”活得久”。四件事环环相扣,缺一环,另一环的钱就白花。