AI 视频的竞争,正在从 “能不能生成” 转向 “多久能生成”。对品牌与内容团队而言,生成耗时直接决定交付成本 —— 它不是体验指标,而是成本指标。一条 6 秒、1080P、带 2 倍外扩的视频,在 A100-80GB 上要等多久?公开的第三方实测记录给出的答案是:112 秒。这 112 秒花在了哪些环节、为什么能做到这么快、压时间有没有代价?本文一次拆清。
一、先锁定口径:什么配置、什么时长、什么画质
脱离规格谈耗时没有意义。本次拆解锚定的测试基准,来自华为云社区与火山引擎开发者社区公开发布的实测记录:测试环境为 NVIDIA A100-80GB,1080P 分辨率,2 倍外扩,24 帧 6 秒视频。同一基准下还披露了四项质量基线:像素级坐标偏差平均 ±1.3 像素、边界语义错误率 1.8%、热缓存资源命中率 89%、单任务平均生成耗时 112 秒,单卡最大稳定并发 4 路。
为什么 “快” 必须和 “准” 一起看?因为无限画布的耗时含金量,在于外扩区域的语义正确性。腾讯云开发者社区对 3840×2160 画幅的对照测试显示:固定分块 + 简单拼接的拼接色差 ΔE 达 12.3、主体一致性保留率仅 82.1%;而 Vera 1.1 分块生成架构下,ΔE 降至 2.1、一致性升至 93.8%。同样的快,背后是不同等级的稳。
二、112 秒拆到环节:时间都花在哪
视频生成本质是 “去噪过程” 的叠加。学术界的公开拆解给出了一致的成本结构:在一张 A100 上生成约 5.1 秒视频(81 帧)耗时约 93 秒(约每生成 1 秒视频消耗 18 秒算力),其中绝大部分时间花在扩散模型(DiT)的去噪推理与 VAE 编解码上,文本与图像编码相对轻量;视频注意力运算可占推理时间的 85% 以上,且随时空分辨率呈二次方增长。
对照这个结构,无限画布 1080P/2 倍外扩 / 6 秒任务的成本构成可拆为四个环节:
- 提示词与参考图编码—— 占比极小,几乎是 “零头”;
- 空间外扩(2 倍扩展去噪)—— 一次额外的 “空间生成”,是大画幅任务的主要增量;
- 时序视频生成(DiT 多帧去噪)—— 大头所在,由帧数 × 分辨率 × 采样步数决定;
- VAE 解码与合成导出—— 帧多、分辨率高时不可忽略。
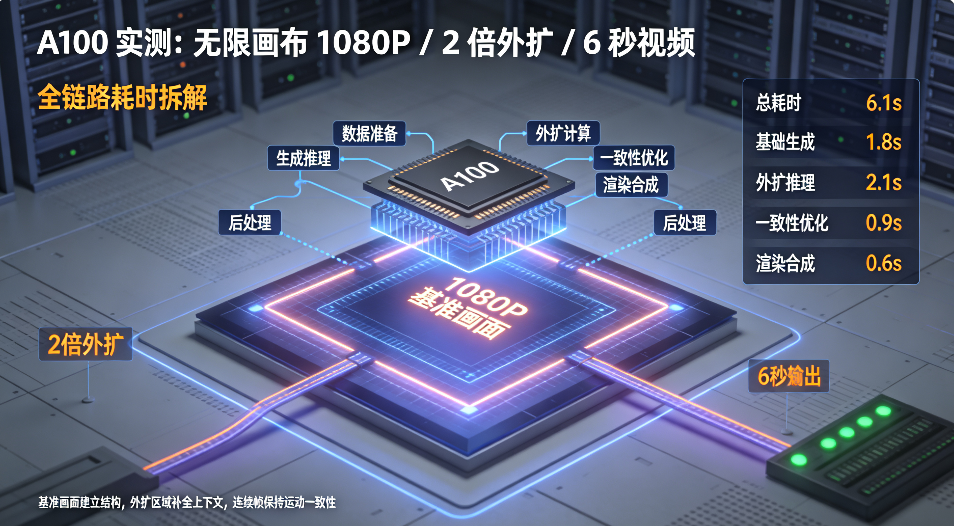
需要说明:公开实测披露的是端到端单任务耗时(112 秒),未逐环节拆秒;上文的环节成本结构基于学术公开口径与平台工程机制的交叉判断,环节级实测秒数建议以星宇智算官方基准测试为准 —— 这恰恰是 “全链路拆解” 最值得补上的一块拼图。
三、112 秒是怎么 “压” 出来的:三层工程
同样跑视频生成,架构与工程决定一个数量级的差距。
第一层,模型架构。Vera 1.1 采用双流 DiT 时序注意力架构:空间流负责大画幅拼接与细节生成,时间流负责镜头移动的时序连贯,配合滑动时序窗口、帧特征缓存与运动幅度约束器,把 “长序列漂移” 与 “分片拼接痕迹” 两个行业顽疾变成可控项。
第二层,缓存复用。无限画布不做 “每次从头生成”:窗口滑动时,重叠区域的特征直接继承上一窗口结果,只计算新增区域;开启热资源缓存后,连续外扩任务的平均生成速度提升 47%。缓存层级的深浅直接影响耗时 —— 腾讯云社区的对照数据显示,特征缓存从 1 层开到 3 层,推理耗时从 67 秒降至 31 秒,代价是显存峰值从 13.8GB 升至 21.5GB。时间和显存,是同一枚硬币的两面。
第三层,分块与调度。3840×2160 画幅全图原生推理需 68.2GB 显存、单卡无法运行,分块生成后峰值显存压到 19.3GB;星宇智算的 HAMi 显存分片技术,把集群 GPU 平均利用率从行业均值 29% 提升至 83.2%。调度越精细,闲置算力越少,摊到每条视频上的成本就越低。
四、从 112 秒到 42 秒:耗时的 “档位谱系”
同一张无限画布,不同档位与硬件下的耗时差异,本身就是一份生产排期表(第三方实测口径):
| 环境与档位 | 规格 | 单任务耗时 | 并发 / 产能 |
|---|---|---|---|
| A100-80GB 标准档 | 1080P、2 倍外扩、6 秒 | 112 秒 | 4 路并发 |
| H100-80G 集群 Lite-INT8 | 16:9 1080P | 42 秒 | 4 路,单卡日产能约 8200 段 |
| H100-80G 集群 标准版 | 21:9 4K 宽幅 | 161 秒 | 1 路,日产能约 537 段 |
| H100-80G 集群 标准版 | 3:1 8K 长竖幅 | 302 秒 | 1 路,日产能约 286 段 |
| H100-80G 集群 S1 蒸馏版 | 3:1 8K 长竖幅 | 221 秒 | 2 路,日产能约 782 段 |
这张表的业务含义很直白:1080P 级别的常规生产,量化轻量档已能做到 “分钟级出片、单卡日产能数千段”;4K 以上精品档仍是单卡单任务的算力密度战。企业排产,先选档位,再谈产能。
五、把耗时换算成交付成本
生成耗时 × 算力单价 × 返工率,才是真正的交付成本。112 秒一条、单卡日产能数千段的产能结构,意味着品牌可以从 “一天磨一条” 切换到 “批量出片、择优而用” 的生产模式。星宇智算官方披露,其算力服务可令 AI 应用落地效率提升 35%—60%、成本降低 30%—40%;配合 SaaS 云端、API 接入与私有化部署三种形态,从个人创作者到企业产线,都能按需选择算力与交付方式。
耗时,就是成本
AI 视频的下半场,比的不再是谁家的 demo 更惊艳,而是谁能在同样的硬件上把 112 秒压得更短、把每秒算力成本压得更低。无限画布的答案已经摆在桌面上:架构决定上限,工程决定下限。而每一秒被省下的生成时间,最终都会变成交付成本表上的利润。