当 “用上大模型” 不再是新闻,能否 “训练自己的模型”,正成为企业级 AI 竞争的新分水岭。而横在多数企业面前的,是算力、数据、人才三座大山。
总部位于厦门的星宇智算(StarVerse-AI)给出了新答案:不必 “大动干戈”。这家 AI 智算及应用生态平台服务商,在既有 GPU 弹性算力与图像侧 LoRA 训练能力之上,正式补充视频侧 LoRA(低秩适配)训练工具,并将其深度集成进自研视频生成引擎 Vera1.1。企业从此可以用更小的数据量、更低的算力规格,完成专属角色、风格与商品的定制化模型训练 —— 把 “训练模型” 从一项重资产工程,变成一次轻量启动。
一、企业定制模型,为何长期 “高门槛”
过去,企业做定制化模型,绕不开三座大山:
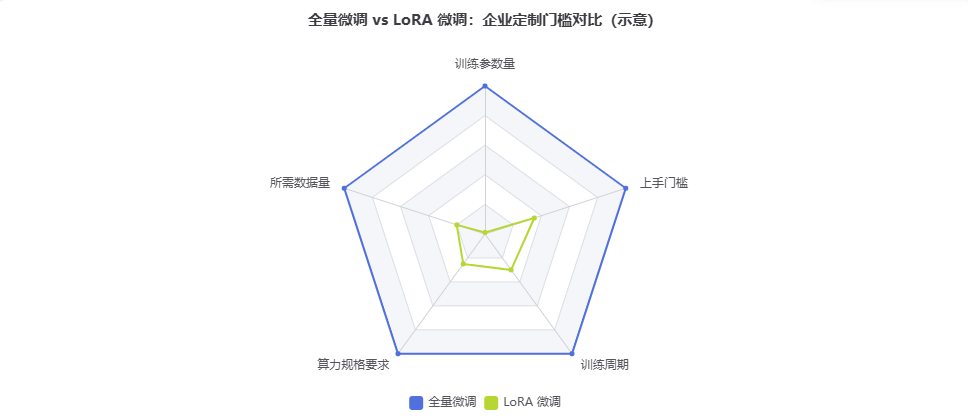
- 算力之山:全量训练往往需要高规格 GPU 集群,硬件采购与运维成本动辄百万级,普通中小企业难以承受;
- 数据之山:优质训练集动辄上万条,采集、清洗、标注的人力投入巨大,周期以月计;
- 人才之山:超参调优、损失分析、过拟合控制几乎全部依赖算法工程师,团队门槛高企。
三座大山叠加,让大量企业只能停留在 “调用通用模型+提示词将就” 的阶段,专属能力成了可望而不可即的奢侈品。
二、LoRA:让模型 “学会定制” 的那把钥匙
LoRA(Low-Rank Adaptation,低秩适配)技术于 2021 年提出,思路并不复杂:在模型注意力层注入低秩矩阵,训练时只更新不足 1% 的参数,即可逼近全量微调的定制效果。
翻译成业务语言:不必推倒重来,只需 “换装升级”。基础模型的通用能力原样保留,企业只训练一小部分适配参数,就能让模型 “认得” 特定人物、”掌握” 特定风格、”熟悉” 特定商品。这正是 LoRA 近年成为企业定制化主流方案的底层原因 —— 它把 “训练模型” 的成本结构,从指数级拉回线性级。
三、StarVerse-AI 补全训练版图:从图像到视频
星宇智算对 “训练普惠” 的布局早已展开。此前,平台已提供 Fluxgym 等零门槛图像 LoRA 训练工作站,创作者无需配置复杂环境即可训练图像模型;如今,随着 Vera1.1 迭代,面向视频场景的 LoRA 轻量化训练模块正式上线,补上了训练版图中最关键的一块 —— 视频。
Vera1.1 是星宇智算面向企业级场景的视频生成引擎,采用双流 DiT 时空解耦架构与身份表征留存技术,直击长视频生成中角色漂移、场景割裂等行业顽疾。其新增的 LoRA 训练模块基于低秩适配架构,无需对基础模型权重做全量更新,显著降低训练所需的数据集规模与算力门槛,可适配短剧、电商物料、IP 角色等视频定制场景。
至此,从图像到视频、从算力到工具、从训练到推理,星宇智算完成了定制化模型训练的全链路闭环。
四、三个关键,把训练成本真正打下来
- 算力规格下探,单卡即可起步。 行业实测显示,视频 LoRA 训练在一张 RTX 4090(24GB 显存)上即可完成,无需专用训练集群。这与星宇智算 GPU 弹性算力平台形成天然闭环 —— 平台聚合 RTX 4090 等主流显卡、支持按需租用,企业不必购卡,按小时付费即可跑通训练。
- 数据规模锐减,几十条就能开训。 相比全量训练动辄数万条样本,视频 LoRA 训练集可压缩至几十至数百条短视频片段(720P、24fps、单段 2—4 秒)。行业实测经验表明,几十条高质量样本足以支撑一个角色的专属模型 —— 质量优先于规模,100 条高质量样本的效果,往往优于 500 条低质量样本。
- 参数与流程可视化,调参不再靠 “玄学”。 训练 Rank、学习率、轮次等关键超参,可在星宇智算 AI 视频工作台可视化调整;开发者亦可通过星桥 API 完成参数透传调用。官方微调脚本与推荐参数基线,进一步压缩了 “调参试错” 的隐性成本。
五、谁在用:短剧、电商、品牌 IP 三大场景
- 短剧与漫剧:为虚拟主演训练一次 LoRA,即可覆盖数十集系列内容的角色一致性,告别逐帧修图的返工循环。据行业测算,基于平台 LoRA 轻量化训练搭建虚拟主演,单集人力相关成本可下降超过 80%。
- 电商物料:为商品训练专属风格模型,批量产出统一调性的产品短视频,主体畸变抑制、材质纹理保留等能力同步生效,素材周转效率大幅提升。
- 品牌 IP:把品牌虚拟形象、吉祥物 “训练” 进模型,跨视频保持五官、服饰、气质一致,IP 资产随使用持续沉淀、越用越值钱。
六、从 SaaS 到私有化,按企业规模选交付
| 交付方式 | 适用对象 | 核心特点 |
|---|---|---|
| SaaS 网页端 | 中小企业、内容团队 | 开箱即用,无需技术背景 |
| 星桥 API | 开发者、系统集成商 | 兼容 OpenAI 接口规范,快速嵌入现有系统 |
| 私有化部署 | 数据安全要求高的企业 | 素材本地加密存储,权限细到每一张图 |
三种方式共享同一套 Vera1.1 底座,企业可按规模与合规要求灵活选择。
七、关于 LoRA 训练,企业最关心的 5 个问题
Q1:完全不懂深度学习,能上手训练吗? A:可以。LoRA 训练的参数规模远小于全量训练,配合平台预置脚本与推荐参数基线,按流程即可产出可用模型;可视化工作台进一步降低了操作门槛。
Q2:训练一个视频 LoRA,大概需要多少数据? A:几十条高质量短视频片段即可起步(行业实测常见区间为 20—80 条)。核心是质量:镜头稳定、画面统一、标注精准的数据集,比单纯堆数量更有效。
Q3:训练成本高吗? A:取决于算力规格与训练时长。星宇智算 GPU 弹性算力支持按需租用,单卡即可完成训练,企业无需一次性投入硬件采购,训练结束即停即走。
Q4:数据和模型安全如何保障? A:数据与模型可通过私有化部署留在企业内网,素材本地加密存储、权限细粒度管控;同时提醒,用于训练的数据素材需具备完整商用授权,规避版权与肖像风险。
Q5:LoRA 训练有没有需要注意的 “坑”? A:主要有三:一是数据集质量决定效果上限,需剔除模糊、抖动、多主体混杂片段;二是 Rank 并非越大越好,过高易过拟合、损时序;三是多个视频 LoRA 同时叠加会衰减稳定性,建议一场景一模型。
模型定制,正在成为企业标配
从 “大厂的专利” 到 “企业的标配”,中间隔着的不是技术,而是门槛。把门槛降下来,把专属留下来 —— 这是 StarVerse-AI 补上这块拼图的初心,也是 “AI 时代算力水电站” 普惠愿景的落点。
你的下一个专属模型,或许只需要一张显卡、几十条素材,和一次开始。