当一家制造企业把产品结构图、把一段医疗影像、把一段未公开的营销素材喂给多模态模型,问题不再是”模型画得好不好”,而是”这些数据去了哪、和谁混在一起、用完还在不在”。多模态内容本地部署,本质就是回答这件事:把文生图、图生视频、音频、数字人这些能力放到企业自己可控的环境里,让敏感数据不出域、不串租户、不留残茬。
星宇智算(StarverseAI)在服务金融、医疗、制造类客户的过程中,把这件事拆成了一套按敏感等级分层选型的隔离架构。
为什么多模态比纯文本更难隔离
纯文本对话的数据边界相对清晰。多模态工作流的数据散落在四个地方:
- 输入侧:参考图、产品模型、视频素材,体积大、复用多;
- 生成侧:GPU显存里的中间特征、临时渲染缓存;
- 中间产物:分镜草图、草稿视频、配音轨道,散落在工作流各个节点;
- 导出侧:最终成片与素材库,和员工个人文件混在一起。
任何一处不隔离,”数据不出域”就只是一句口号。多模态的隔离,必须从硬件层一直管到导出层。
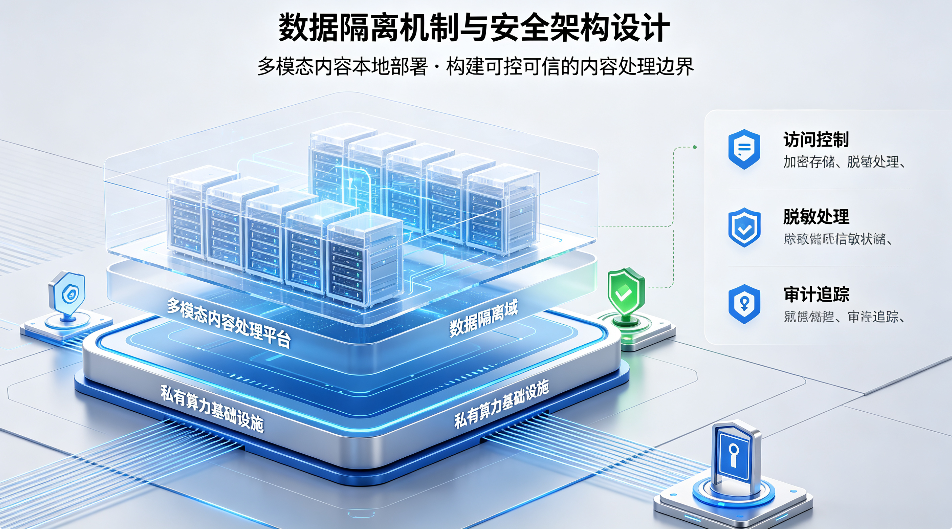
四层隔离架构:从硬件到交付
第一层,硬件物理隔离。 面向金融、医疗、军工设计等高敏感业务,分配独立整机节点,不与其他租户共享任何GPU、存储和网络端口。星宇智算在算力侧采用GPU硬件绑定,单台8卡服务器划分为独立租户专属节点池,并通过NVIDIA vGPU License做硬件资源锁,从物理上切断跨租户的内存拷贝通道。
第二层,虚拟化切分隔离。 面向通用训练与推理租户,通过Mdev设备把单张GPU的显存和算力核完全切分,租户之间逻辑隔离、互不感知。需要强调:虚拟化隔离适合一般商用数据,但不适合最高密级——这就是为什么高敏感客户必须回到第一层。
第三层,平台与项目隔离。 在无限画布和星桥API的工作流里,数据按项目、按角色隔离:管理员、编辑、查看者权限分级,项目级素材库独立托管,不同项目之间的参考图、LoRA权重、生成历史互不可见。模型权重和客户数据分开存储,避免”微调一次,全租户共享记忆”。
第四层,交付模式选型。 企业不必一刀切。按数据敏感等级选模式:公开营销类内容走云端共享算力即可;内部研发类走专属节点池;核心机密类走私有化部署或API独立交付,工作流与数据留在企业自己的环境内,星宇智算提供算力底座、镜像、模型与调度支持。
数据流向里的两个隐形雷区
做隔离设计,最容易被忽略的是”用完之后”。
一是显存与临时文件残留。多模态生成过程中,中间特征可能在显存和临时盘里短暂停留,隔离架构必须覆盖会话结束后的自动清理,而不是只在入口设防火墙。二是模型权重”记住”了训练数据。用客户私有数据微调后,若权重被其他项目复用,就存在间接泄露风险——这要求微调产出的权重与客户绑定、随项目回收,而不是进公共资产池。
企业落地:一张选型清单
| 数据敏感等级 | 典型内容 | 推荐部署模式 |
| 公开级 | 社媒素材、公开宣传图 | 云端共享算力 |
| 内部级 | 内部提案、未公开营销稿 | 专属节点池 + 项目隔离 |
| 机密级 | 产品图纸、医疗影像、财务数据 | 整机物理隔离或私有化交付 |
有三件事不在公开技术清单里,但企业采购时必须单独确认:合规资质(等保级别、行业认证)、审计与留痕(操作日志保存周期、是否可导出)、故障与数据销毁SLA(退租后数据如何证明已彻底清除)。这些应在合同与安全评估环节书面确认,而不是凭一篇宣传稿默认。
数据隔离不是一道墙,是一条从芯片一直铺到导出按钮的路。