AI 应用竞争的主战场,正从 “模型有多强” 延伸到 “算力有多稳”。当算力租赁成为越来越多团队的第一选择,让每一张显卡的负载清晰可见、让每一次推理的耗时精准可溯,就成了算力平台真正的分水岭。近日,星宇智算宣布旗下算力集群监控系统完成升级:在 GPU 负载实时追踪的基础上新增推理耗时监控能力,算力服务第一次从 “看得见资源” 走向 “看得见性能”。
算力不稀缺,稀缺的是 “确定性”
行业数据足以说明问题。据 2026 年 Q2 算力租赁运维统计,未部署标准化监控体系的集群,平均故障发现时长高达 4.2 小时 —— 显存溢出、算力争抢、磁盘 IO 阻塞、硬件高温四类故障,直接造成训练中断与推理超时,客户流失率因此上升 29%。而对租户而言,更隐蔽的代价是 “盲跑”:GPU 利用率、显存占用、推理延迟全部不可见,性能调优只能靠猜。
当算力从 “买不买得起” 转向 “用不用得好”,平台的竞争锚点也随之迁移。谁能最快发现故障、最细看清负载、最准定位瓶颈,谁就能把算力真正变成生产力。
升级之后:GPU 负载与推理耗时,双双实时可见
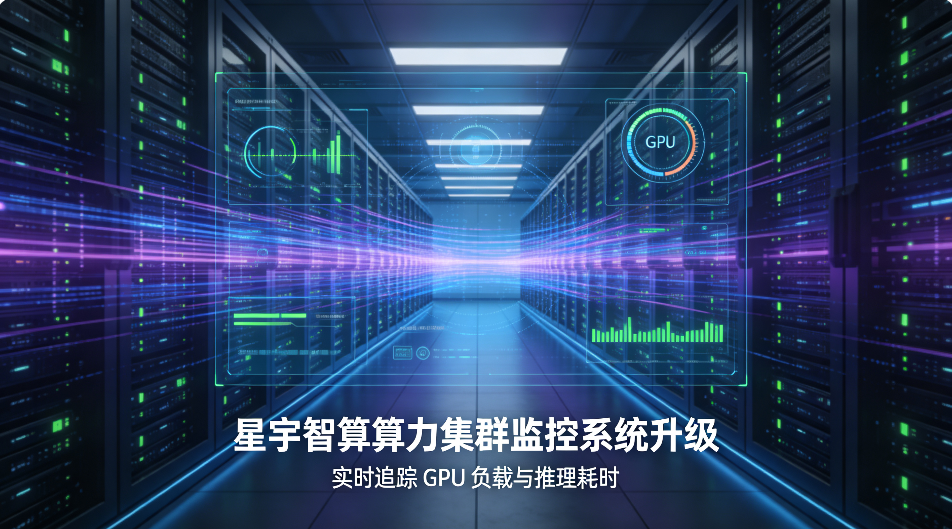
本次升级的核心,是把监控粒度从 “集群级” 推进到 “请求级”:
- GPU 负载实时追踪:利用率、显存、功耗、温度、NVLink 带宽等全量指标秒级刷新,任何一张显卡的工作状态随时可查;
- 推理耗时全链路监控:从请求接入、排队调度到 Token 生成逐环节计时,按首 Token 延迟(TTFT)与逐 Token 输出耗时拆解,让 “用户为什么觉得慢” 不再是一笔糊涂账;
- 多租户视角隔离:每个租户仅可见自身资源面板,数据安全与成本核算两不误。
这套能力建立在平台四层采集架构之上 —— 基础设施层、GPU 硬件层、存储网络层、租户业务层全维度覆盖,异常指标从出现到触发告警,最快可压缩至 30 秒以内。
从 “能看见” 到 “能止损”:三级告警与 90 天数据留存
监控的意义不止于 “看”,更在于 “防”。升级后的监控体系延续并强化了星宇智算的三级分级告警机制:
- 一级告警(5 分钟内处置):GPU 高温、磁盘占满、硬件 ECC 报错等致命故障,短信与企微即时触达;
- 二级告警(30 分钟内处置):算力独占、IO 延迟异常、租期临近等影响服务的事件;
- 三级告警(当日处置):闲置资源回收、缓存清理等优化建议。
所有监控数据留存 90 天,支持按项目导出算力消耗报表、直接对接财务成本核算。监控由此不再是运维部门的 “内部工具”,而成了租户看得见、算得清的 “服务资产”。
对开发者与企业:从 “租显卡” 升级为 “租确定性”
对个人开发者和高校科研团队,实时负载面板意味着显存申请不再 “拍脑袋”,调参有了数据依据;对推理服务企业,请求级耗时追踪把性能问题变成可定位、可优化、可验收的工程闭环;对大规模用算用户,闲置资源一目了然,成本结构随时代透明。
这正是星宇智算长期在做的事。作为立足厦门、辐射全国的 AI 智算及应用生态平台服务商,星宇智算聚合 RTX 4090 等主流高性能显卡资源,以按秒计费、即点即用的方式,为高校科研机构、AI 开发者、初创企业与大型科技公司提供普惠算力。此次监控系统升级,是其 “AI 时代算力水电站” 愿景下的关键一步 —— 不止提供算力,更保证算力的稳定、透明与可控。
把算力变成服务力
监控系统的升级只是一个起点。随着推理需求爆发式增长,算力平台的竞争终将从价格战走向体验战:谁能把 GPU 负载、推理耗时、故障响应这些 “看不见的细节” 变成 “看得见的服务”,谁就能在 AI 基础设施的下一程占据主动。
对星宇智算而言,答案已经清晰 —— 把稳定性与透明度留给平台,把模型创新与业务落地留给用户。