AI 视觉生产正在从 “单次出图” 走向 “批量渲染”。一个短剧项目可能同时排队几百个分镜,一次电商大促要铺几千张物料 —— 任务量一旦上来,最先崩的不是模型,而是调度。谁先跑、跑在哪张卡、某张卡超时了怎么办、显存不够的任务怎么分流,这些才是大规模渲染真正的工程门槛。
星宇智算在把 “无限画布” 做成生产载体的过程中,面对的正是这一层问题:画布上每一帧、每一次分镜重绘,背后都是一个需要被排队、被分配、被回收的渲染任务。
为什么单卡跑顺了,集群还是会堵
单机调优解决的是 “一张卡能跑多快”,而生产瓶颈往往出现在别处:
- 任务异构:文生图、图生视频、超宽画幅分片,对显存、算力、时长的需求差异巨大;
- 负载不均:某几张卡被大画幅任务占满,旁边的卡却在空转;
- 失败成本:一个长镜头跑到一半节点掉了,整段要重来;
- 优先级错配:正在赶片的客户任务,被一批批量素材渲染挤在后面。
队列设计要做的,本质是把这些不确定性收敛成可预测的调度规则。
一套可落地的队列骨架
工程上通常拆成四层。
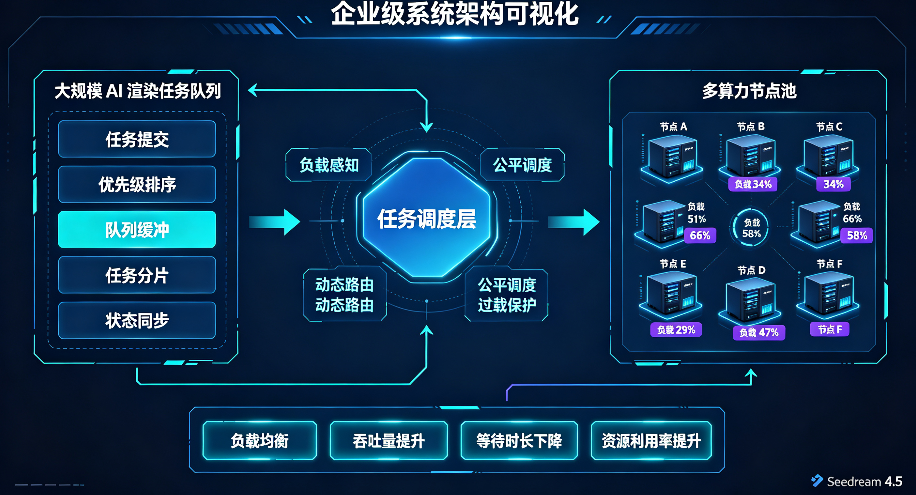
第一层:任务抽象。 把每一次渲染封装成带元数据的任务单元 —— 类型、分辨率、预估显存、优先级、依赖分镜、超时阈值。没有这层抽象,后面所有调度都是凭感觉。
第二层:多级队列。 不是 “一个大队列按顺序排”,而是按优先级、按资源画像、按客户 / 项目分多队列。交互式预览任务走低延迟队列,批量物料走吞吐队列,互不阻塞。
第三层:节点画像与调度。 给每张卡打标签:卡型、显存、当前负载、剩余配额。调度器不再 “随机挑一张闲卡”,而是按任务需求匹配 —— 超大画幅分片优先调度到高显存节点,短平快的预览渲染打到轻量实例。
第四层:分片与容错。 配合无限画布的推理分片思路,一个大画幅任务被切成多个空间窗口分发到不同节点并行渲染,再由融合层无缝拼接;单节点失败只重跑对应分片,而不是整条任务链。
负载均衡,不是 “平均分”,而是 “匹配对”
这是最容易被误解的一点。把任务均匀撒到每张卡上,看起来公平,实际浪费 —— 一张 24G 显存的卡和一张 80G 显存的卡,被分配同样的大画幅任务,结果必然是小卡 OOM、大卡闲置。
真正的负载均衡要回答三个问题:任务需要什么、节点能给什么、现在还要等多久。前者靠任务元数据,中者靠节点实时画像,后者靠队列时延估算。三者对齐之后,”均衡” 才从玄学变成可计算的策略。
算力底座,决定了调度的天花板
再好的调度算法,跑在碎片化、不可观测的算力资源上也会失效。这也是为什么 “无限画布” 这类产品必须长在统一的算力底座上:实例规格、监控指标、配额、网络吞吐要标准化,调度器才有干净的数据可用。
对创作者和团队来说,这层工程是 “看不见的”—— 他们只在浏览器里推拉画布。但正是队列把任务接住、把节点补齐、把失败藏起来,超宽长镜头和多分镜叙事才谈得上 “无限”。
工程的尽头,是让调度退到幕后
大规模渲染队列的终极目标,从来不是把调度界面做得多炫,而是让它在创作者感觉不到的时候就把活干完了。画布无限延展,任务自动排队、自动选卡、自动容错、自动回收 —— 当这套闭环跑顺,视觉创作的瓶颈才真正从 “算力够不够”,回到 “创意值不值”。