随着生成式 AI 技术逐步进入政务、国企等行业数字化场景,AIGC 不再是概念验证阶段的试点工具,而是开始融入公文辅助、材料整编、知识库检索、智能问答等业务流程。政企项目和互联网通用大模型应用存在本质差异:业务数据涉密、流程合规要求高、基础设施自主可控约束强。盲目照搬公有云通用大模型方案,会带来数据外泄、接口不可控、底层依赖等一系列风险。因此,政企 AIGC 项目建设,需要建立 “安全先行、适配为本、业务落地” 的建设思路。
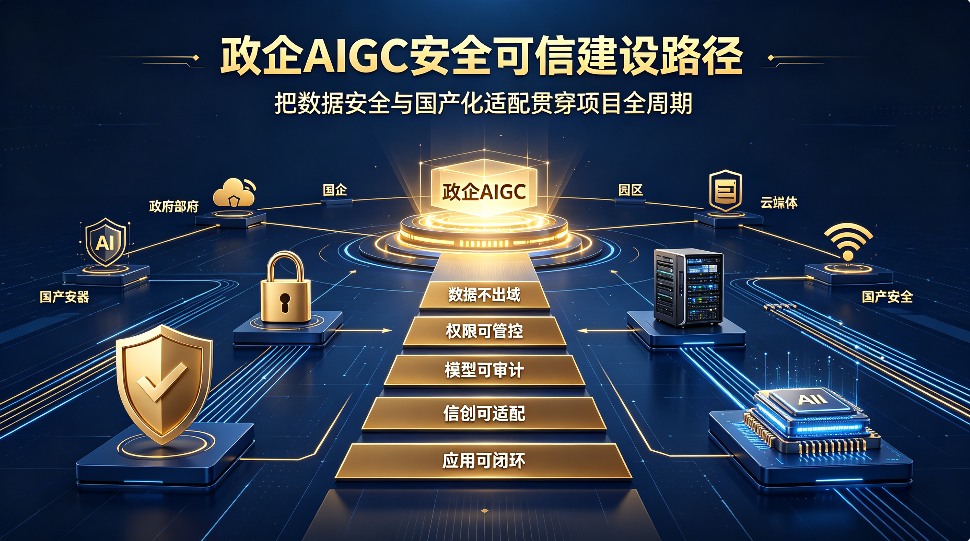
政企 AIGC 建设首要原则,是数据全链路安全管控。政企场景内包含内部业务台账、会议资料、业务档案、敏感业务信息,这类数据不适合流出企业内网。传统公有 API 调用模式,存在输入提示词、返回内容被模型侧采集的风险。安全体系建设需要覆盖数据采集、预处理、模型推理、结果输出、日志审计全链路。常见措施包括数据分级分类、敏感信息识别与脱敏、提示注入防护、访问权限细粒度管控、操作日志全留存、输出内容合规校验。模型推理可采用本地私有化部署、内网隔离推理集群,做到 “数据不出域”,从源头降低泄露风险。
国产化适配是政企 AIGC 落地的硬性底座要求。国产化适配不是单一硬件或者单一软件的替换,而是软硬协同的全栈适配,涵盖国产服务器、操作系统、芯片、中间件、数据库与大模型推理框架。项目实施中容易出现的偏差,是只关注模型本身,忽略底层软硬件兼容性,上线后出现推理延迟高、并发能力不足、接口不稳定等问题。国产化适配需要提前开展兼容性验证、性能压测、故障演练,保障大模型在自主可控基础设施上稳定运行,满足业务持续可用要求。
在安全底座与国产化底座之上,再推进业务场景落地,避免 “重模型能力、轻业务价值”。很多政企 AIGC 试点容易陷入单纯比拼模型对话效果的误区,忽略业务闭环。合理路径是依托私有知识库做检索增强生成(RAG),把存量文档入库,模型只基于授权资料作答,减少模型幻觉,同时方便溯源。优先选择高频、低风险场景试点,例如政策文档检索、文稿初稿辅助、内部知识库问答,小范围验证效果后,再逐步扩大覆盖业务。
星宇智算面向政企场景打造全栈 AIGC 私有化方案,围绕数据安全与国产化适配两大核心要求,支持部署在国产软硬件环境中。方案内置文档脱敏、提示词安全过滤、内容审计、权限管控等安全组件,支持 RAG 知识库构建、节点式工作流编排,可对接政企现有业务系统,在满足自主可控规范前提下,释放生成式 AI 效能。同时提供配套工程化服务,包含适配验证、性能调优、上线运维、安全巡检,帮助客户规避试点阶段常见的兼容性、数据泄露、不可溯源等风险,降低政企 AIGC 项目落地成本。
项目建设需要兼顾安全约束、国产化适配、投入成本、运维复杂度等多重变量。不能简单套用互联网 AI 产品的建设逻辑。项目前期应开展需求评估与风险评估,明确数据边界、合规清单、性能指标,划定试点范围。建设过程中建立安全评审机制,每一个新场景上线前完成安全核验。持续跟踪模型输出质量、审计日志、系统运行状态,形成可迭代的运营体系。
安全与适配,是政企 AIGC 长期落地的根基。