先把账算明白:百万节点难在哪
屏幕刷新一帧的预算只有 16.7 毫秒,超了就会掉帧。而传统画布大多基于 DOM 或 SVG 渲染:每个节点都是渲染树上的一个分支,节点一多,重排重绘的开销指数级上涨;一次框选要把全部节点遍历一遍,复杂度 O(n);改一个参数,整张画布重绘。这就是”拖一下、顿一下”的来源。
这不是星宇智算独有的难题,是整个图形渲染领域的共性瓶颈。工业界的主流解法早已收敛到同一套思路:空间分区加视口感知——地图引擎用瓦片金字塔,在线白板用四叉树(Miro 的 4 万元素画布、Figma 的瓦片化 WASM 渲染都走这条路线),学术界也有瓦片金字塔与 GPU 四叉树的相关研究。差别只在于,谁能把这套工程做到位。
四板斧:新渲染管线怎么”省”出来的
星宇智算 9 月 1 日发布的引擎升级,本质是把渲染管线整体重写,四个关键动作:
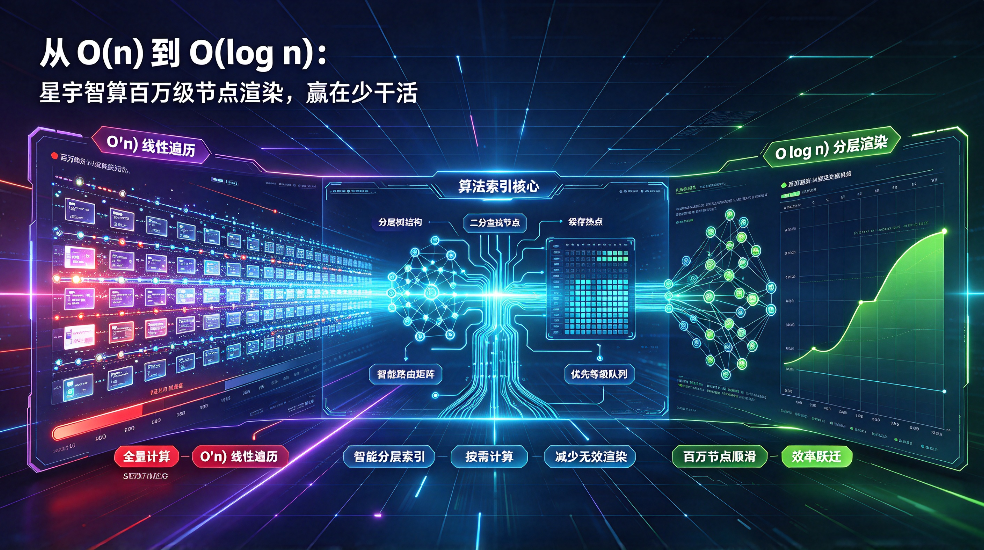
第一板斧:四叉树空间索引,把查找从 O(n) 变 O(log n)。 节点按空间位置组织进四叉树,框选、点选不再遍历全图,而是沿树向下查询。官方实验室数据:框选 5000 个节点,耗时从约 900ms 降到 62ms。
第二板斧:瓦片化加视口剔除,只画看得见的。 画布按视口切成瓦片,视口外的节点直接不渲染。一个直观的参照:8000 个节点的画布,屏幕上同时可见的往往只有两三百个——把其余的全画出来,是纯浪费。渲染优先走 WebGPU,不支持的浏览器自动回落 WebGL 2.0。
第三板斧:LOD 分级聚簇,概览和细节都要。 视图缩小时,密集节点自动聚合成簇并显示规模角标;放大超过阈值,簇再还原成原始节点。看全局结构看的是簇,看单节点看的是细节,两边各取所需。这也解释了百万节点内存峰值为什么能控制在 1.2GB——不是所有节点都常驻渲染实例。
第四板斧:脏区增量更新加 GPU 合批,只重绘改过的。 拖动节点、修改参数,只重绘受影响区域,配合 GPU 合批提交,把大量小的绘制命令合并成少数批次,不再整屏刷新。
官方性能账:量级差距是确定的
以下数据来自星宇智算官方实验室标准测试工程(Chrome 最新版 / Windows 11,独显 RTX 4060 / 核显 Intel Iris Xe):
| 测试项 | 升级前 | 升级后 |
| 官方建议节点承载 | 10 万 | 100 万 |
| 10 万节点视口平移帧率 | 24fps | 稳定 60fps |
| 100 万节点首次加载 | 超出上限 | 2.1 秒 |
| 框选 5000 节点耗时 | 约 900ms | 62ms |
| 100 万节点内存峰值 | — | 1.2GB |
核显设备开启聚簇模式后,平移帧率也能稳定在 45fps 以上。官方同时提示:不同业务图谱结构会有浮动,以自有工程实测为准。
说几个容易混的点
- 渲染 ≠ 生成。 这次升级的是”画布本身顺不顺”(渲染管线);AI 生成类任务走云端多模态算力集群,是另一条优化线。社区拆解里常说的”推理分块瓦片”(生成侧,瓦片间保留重叠带做特征对齐)和这次的”渲染瓦片”(显示侧,视口剔除)是两套东西,别混。
- 不是”Canvas 一把梭”。 可编辑节点、事件交互仍需保留在 DOM 层,GPU 负责海量节点的绘制——混合渲染是 Figma、Miro 这类产品的行业惯例,不是偷懒。
- 60fps 是目标,不是保证。 图谱结构、设备差异都会影响实际帧率;聚簇模式牺牲一点细节换流畅度,本身就是取舍。
对创作意味着什么
性能是手段,创作方式改变才是目的。节点承载上限打开后,一部长篇短剧的剧本节点、分镜、素材、成片可以完整铺进同一张画布;角色、场景资产链条一眼可循,参数改一处、下游联动清清楚楚。星宇智算官方测算,全流程收敛到统一画布后,内容生产的综合人力与算力成本可下降 68% 以上——这次引擎升级,正是让那套生产方式”跑得动”的底座。
渲染没有魔法,只有取舍
百万级实时渲染拆到底,就是三句话:只画看得见的、只查用得着的、只重绘改过的。剩下的,都是工程细节。
想上手验证的,打开星宇智算 AI 视频工作台即可;完整机制以《星宇智算技术白皮书》与官网技术文章为准。