无限画布的生成瓶颈,不在画布而在推理
无限画布支持超大画幅、多分镜连续画面的创作,但画布尺寸的扩展直接带来一个工程难题:生成计算量的爆炸式增长。一张标准 16:9 画幅的视频生成任务,计算量已经相当可观;当画幅扩展到 3:1、5:1 甚至更极端的比例,或者需要同时生成一段包含多个分镜的连续画面时,单次推理的计算量可能翻几倍甚至十几倍。
如果用单卡直接推理这类超大任务,会遇到两个瓶颈:一是显存容量不足,大模型本身的参数加上生成过程中的中间状态,可能超出单卡显存上限;二是推理时间过长,用户等待一次生成结果可能需要数分钟,严重影响创作体验。推理分片架构的核心目标,就是将超大推理任务拆分到多个计算单元上并行处理,在保证生成质量的前提下提升推理效率、降低单卡压力。
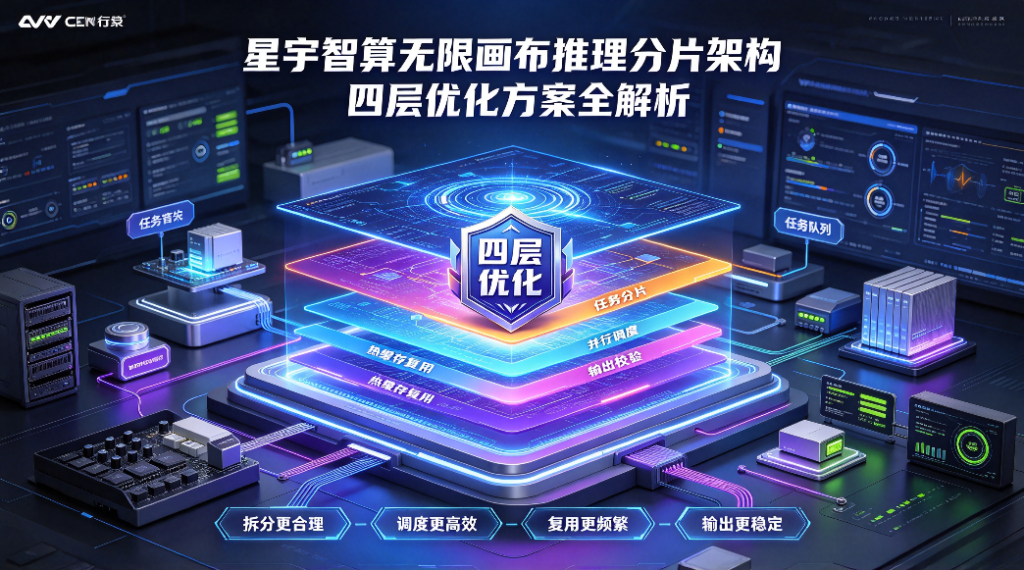
星宇智算在无限画布中采用推理分片架构,并从模型层、任务层、内存层、通信层四个维度进行协同优化。以下逐层解析这套架构的设计思路。
第一层:模型层分片 —— 把大模型拆到多卡上跑
模型层分片是推理分片架构的基础,解决的是 “单卡装不下大模型” 的问题。当前主流的视频生成模型参数量从数十亿到数百亿不等,加上推理过程中的激活值和 KV 缓存,显存需求往往超过单张消费级显卡的容量。模型层分片的核心思路是将模型的参数按照特定维度切分,分配到多张 GPU 上,每张 GPU 只负责模型的一部分计算,通过协同完成完整的推理过程。
常见的模型分片方式包括张量并行和流水线并行。张量并行是将模型中的矩阵运算按维度切分,比如将一个大矩阵乘法拆成多个小矩阵乘法在不同 GPU 上并行计算,最后汇总结果。这种方式适合计算密集型的层,但需要在 GPU 之间频繁传输中间结果,对通信带宽要求较高。流水线并行则是将模型的不同层分配到不同 GPU 上,前一个 GPU 完成前几层计算后将结果传给下一个 GPU,形成流水线。这种方式通信量相对较小,但存在流水线填充和排空的开销,在小批量推理时效率会打折扣。
星宇智算在无限画布的推理分片中,根据模型结构和任务特点动态选择分片策略,对于计算密集的层优先采用张量并行,对于层间依赖较强的部分采用流水线并行,在两者之间取得平衡。
第二层:任务层调度 —— 让分片大小匹配实际需求
模型层分片解决了 “模型怎么拆” 的问题,任务层调度解决的是 “任务怎么分” 的问题。无限画布的生成任务差异很大:有时是单张小画幅的快速预览,有时是超大画幅的高质量成片,有时是一段包含多个分镜的连续画面。不同规模的任务需要不同的分片策略,如果所有任务都用同一套分片配置,要么小任务被过度分片导致调度开销浪费,要么大任务分片不足导致推理缓慢。
任务层调度的核心是动态评估任务的计算量和显存需求,根据可用的 GPU 资源自动选择最优的分片数量和分片方式。对于小任务,可能只需要单卡或两卡即可完成,不需要启动大规模分片;对于大任务,则需要将计算和显存压力分散到更多 GPU 上。调度器还需要考虑 GPU 的负载均衡,避免出现某些 GPU 满载而另一些空闲的情况。
在无限画布的实际使用中,任务层调度的价值体现在两个方面:一是用户不需要手动配置推理参数,系统根据任务规模自动适配;二是在多用户并发场景下,调度器可以在不同任务之间合理分配 GPU 资源,提高整体资源利用率。
第三层:内存层管理 —— 把显存用在刀刃上
即使做了模型分片和任务调度,推理过程中的显存压力仍然是一个关键瓶颈。视频生成模型在推理过程中需要存储大量中间状态,包括每一层的激活值、注意力机制的 KV 缓存、以及生成过程中的临时缓冲区。这些中间状态的显存占用往往超过模型参数本身的大小,如果管理不当,即使做了分片也可能出现显存溢出(OOM)。
内存层优化从几个方向入手。首先是 KV 缓存的高效管理。在自回归生成过程中,每一步都需要缓存之前所有步的 Key 和 Value 矩阵,随着生成序列变长,KV 缓存的显存占用线性增长。通过分页式 KV 缓存管理、按需分配和及时释放,可以将缓存的实际显存占用控制在合理范围内,避免不必要的浪费。其次是激活值重计算。对于某些显存占用大但计算成本相对低的层,可以在反向传播或后续计算时重新计算激活值而不是全程存储,用计算换显存。最后是显存碎片整理。频繁的显存分配和释放会产生大量碎片,导致虽然总剩余显存足够但无法分配连续的大块显存。通过内存池和预分配机制,可以减少碎片,提高显存利用率。
在无限画布的超大画幅生成场景中,内存层优化的效果尤为明显。画幅越大,生成过程中的中间状态越多,显存压力越大。通过多层内存管理策略,系统可以在有限的显存资源下完成更大画幅的生成任务,减少因显存不足导致的生成失败。
第四层:通信层优化 —— 让多卡协同不被带宽拖慢
推理分片将任务分散到多张 GPU 上,但 GPU 之间需要频繁交换数据 —— 张量并行需要传输中间计算结果,流水线并行需要传输层间激活值,任务调度需要传输任务状态和生成结果。如果通信效率低下,多卡并行的加速比会被严重稀释,甚至出现 “多卡比单卡还慢” 的情况。
通信层优化的目标是降低通信开销、提高通信效率。首先是通信计算重叠。在 GPU 进行计算的同时,提前发起下一批数据的通信传输,让计算和通信在时间上重叠,而不是串行等待。这需要精细的流水线设计,确保数据在需要时已经到达目标 GPU。其次是通信量压缩。对于某些中间结果,可以采用低精度传输或量化压缩,减少需要传输的数据量。比如将 FP16 的激活值压缩为 INT8 传输,接收端再反量化,虽然会引入微小的精度损失,但在大多数生成任务中对最终质量影响可控,而通信量可以减半。最后是通信拓扑优化。在多 GPU 服务器中,不同 GPU 之间的通信带宽可能不同(比如 NVLink 连接的 GPU 之间带宽远高于 PCIe 连接),调度器在分配分片时会优先将通信密集的任务分配到高带宽连接的 GPU 上,减少跨节点通信。
通信层优化是推理分片架构中最容易被忽视但影响显著的一环。很多分片方案在理论上有很好的加速比,但实际部署后因为通信瓶颈无法达到预期。星宇智算在无限画布的推理架构中将通信优化作为独立的一层来设计,确保多卡协同的效率不被通信拖慢。
四层协同:不是简单叠加,而是系统工程
需要强调的是,推理分片架构的四层优化不是四个独立模块的简单叠加,而是一个需要协同设计的系统工程。每一层的优化决策都会影响其他层的效果:模型层的分片方式决定了通信模式,任务层的调度策略影响内存分配的模式,内存层的管理方式又会反过来影响任务调度的灵活性。
比如,模型层采用张量并行会增加通信量,需要通信层提供更强的优化支持;如果通信带宽有限,可能需要调整模型分片策略,减少张量并行的比例。再比如,任务层为大任务分配更多 GPU 分片,会增加 GPU 之间的通信量和内存管理的复杂度,需要内存层和通信层同步适配。
星宇智算在无限画布的推理架构设计中,将四层优化作为一个整体来调优,通过大量实际任务的测试和反馈,不断调整各层的参数和策略,找到在不同硬件配置、不同任务规模下的最优组合。这种系统级的优化能力,是推理分片架构能否真正落地的关键。
架构在演进,效率的提升没有终点
推理分片架构为无限画布的超大画幅生成提供了算力基础,但这并不意味着所有问题都已解决。随着模型规模继续增长、画布尺寸继续扩展、用户对生成速度的要求不断提高,推理架构需要持续演进。
几个值得关注的方向包括:更细粒度的动态分片,根据模型不同层的计算和通信特点自适应选择分片方式;异构计算协同,将部分计算卸载到 CPU 或专用加速器上,减轻 GPU 压力;以及推理结果的增量复用,对于相似的生成任务,复用之前的中间结果减少重复计算。
同时需要客观指出的是,推理分片的效果有其适用边界。对于非常小的任务,分片带来的调度和通信开销可能超过并行加速的收益,此时单卡推理反而更高效。对于硬件条件有限的环境(比如 GPU 数量少、互联带宽低),大规模分片的加速比会受到限制。企业在部署无限画布时,需要根据自身的硬件条件和典型任务规模,选择合适的分片配置,而不是盲目追求最大分片数。
但可以确定的是,当模型层、任务层、内存层、通信层四层优化协同运转时,无限画布的超大画幅生成能力获得了坚实的工程支撑。创作者可以在更大的画布上自由创作,不需要因为算力限制而妥协画幅或质量。推理分片架构给出的,是无限画布从 “概念可行” 到 “生产可用” 的关键一步。