AI 生成内容的高清长图、超大画幅视频渲染场景中,算力瓶颈、显存溢出、推理耗时过长,一直是行业普遍痛点。传统方案常采用整体加载方式处理大图张量,随着画布尺寸扩张,显存占用呈指数级上涨,极易触发内存超限,造成任务中断。星宇智算无限画布依托自研时空解耦 DiT 与 Layer-Diffusion 节点式引擎,推出推理分片架构四层优化方案,针对性解决超大尺寸生成任务的推理效率难题。
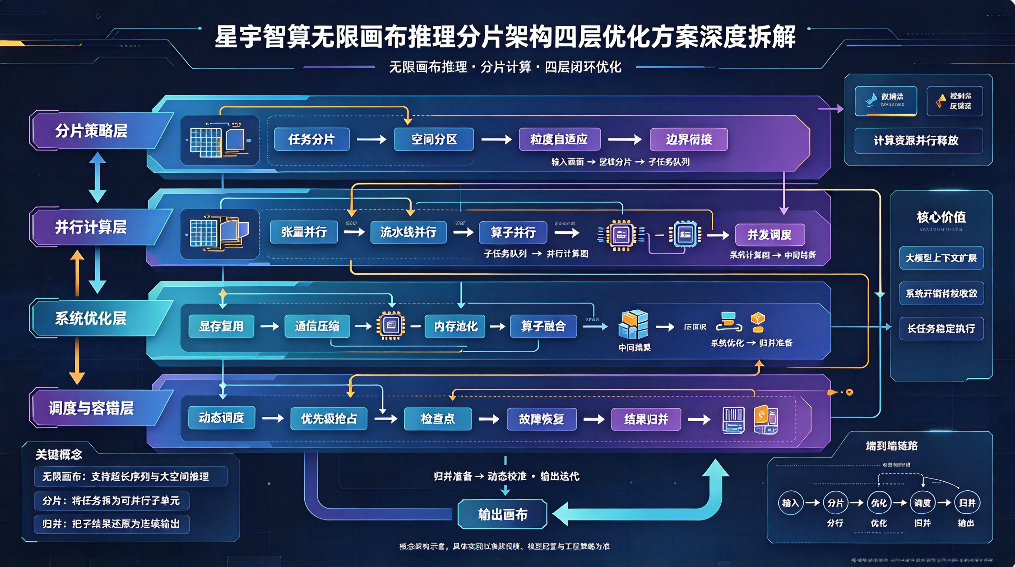
第一层:张量边界自适应分片切割。 不同于固定尺寸均分分片的传统做法,星宇智算无限画布采用张量边界感知算法,根据画面内容复杂度、特征分布动态划分分片单元。纹理密集区域划分更小分片,纯色平滑区域合并大分片,同时保留分片之间重叠特征缓冲区,规避分片拼接处出现断层、纹理错位问题。这一层优化把超大画布张量拆解为可并行处理的子任务,降低单步推理显存峰值,为后续分层计算打下基础。
第二层:分片特征解耦与并行调度。 在完成分片切割之后,架构对空间特征、时序特征做解耦处理,依托节点式引擎实现多分片任务并行调度。系统会根据当前硬件资源负载,自动分配分片任务到可用算力单元,避免算力闲置或者资源争抢。无限画布原生支持多卡协同推理,在处理长幅图像、连续帧视频生成任务时,并行调度能力可以显著压缩整体推理耗时。
第三层:分片中间特征缓存复用。 多数分片推理方案会重复计算重叠区域特征,带来冗余算力开销。星宇智算无限画布四层优化的第三层,重点实现中间特征缓存复用机制。对跨分片共享的底层特征只计算一次,缓存至高速显存池,相邻分片推理时直接读取缓存特征,减少重复张量运算。实测场景下,该机制可降低 20%~35% 的冗余计算量,算力资源利用率得到明显提升。
第四层:分片融合与全局一致性校正。 各分片独立推理完成后,进入全局融合校正环节。系统不再简单拼接图像区块,而是读取缓存的全局特征信息,对分片交界区域做特征平滑融合,同时执行全局色彩、细节一致性校验。消除分片边界伪影,保证整张超大画布视觉连贯,不会出现局部风格割裂。该层兼顾生成质量,守住大尺寸画面的细节完整性。
落地价值:兼顾大尺寸生成能力与算力成本控制。 这套四层推理分片架构,是星宇智算无限画布底层能力的核心升级。在不降低画面细节质量的前提下,大幅放宽单卡可支持的画布上限,降低超大画幅任务的硬件准入门槛。设计师、内容创作者无需顶配算力硬件,即可高效制作巨幅海报、全景图、长卷轴画面与长时序 AI 视频素材。
面向未来:持续迭代底层生成引擎。 星宇智算将持续迭代无限画布的时空解耦 DiT、Layer-Diffusion 节点式引擎,持续优化分片推理延迟、显存占用指标,拓展更多分辨率、更长时序的生成场景,为 AI 视觉内容生产提供稳定高效的底层算力底座。