AI 视频创作的门槛,历来卡在设备上:显卡、显存、部署环境。无限画布画幅越大,对算力的要求越苛刻——大画布要么跑不动,要么先凑齐多卡集群再说。设备性能,成了内容生产里一道看不见的天花板。
星宇智算的解法不是堆硬件,而是把“重”留在云端、把“轻”留给终端。9 月 24 日,星宇智算发布无限画布推理分片架构技术迭代成果,官方口径直指“突破显存约束、拓展 AI 视频画幅边界”。这篇文章拆开三层破局逻辑,看看“全终端流畅运行”到底是怎么实现的。
01 瓶颈到底卡在哪:显存墙与算力门槛
画布一大,两个瓶颈同时冒出来:注意力算不动,显存放不下。
扩散模型的注意力机制,显存开销随画幅快速放大;全图推理场景下,画幅翻倍往往意味着显存需求成倍增长。行业里 4K 分辨率单卡显存告急是常态,想跑超宽画幅就得凑多卡集群——硬件成本、运维成本一起抬高,创作机会跟着向头部团队集中。
瓶颈不在创意,在设备。
02 第一层破局:生成侧的分片延展渲染
星宇智算 9 月 24 日迭代的核心思路并不玄:不整图硬算,把大画布切成块,分片生成、延展拼接。
第三方实测口径给出的数据很直接(华为云社区公开实测):
- 4K 分辨率下,分块方案显存占用与 1080P 全图基本持平,单张消费级显卡即可运行;
- 超宽幅场景显存增长平缓,画幅横向翻一倍,显存仅增加约 11%;
- 分块生成的主体一致性仅比全图低 0.9 个百分点,观感差异有限。
代价也如实摆着:单帧耗时增加。换回来的,是单卡就能跑超大画幅,不必再凑多卡集群。
03 第二层破局:渲染侧的瓦片注意力与热缓存
生成省了显存,渲染还要省算力。星宇智算的大场景渲染优化方案,核心是两把钥匙(腾讯云社区公开解读口径):
- 瓦片注意力负责“算得更少”:只在块内做注意力计算,非活动区域不参与当前轮计算。实测 2.7K 场景下注意力层峰值显存降 42%,4K 场景降一半以上;
- 热缓存负责“存得更巧”:高频访问的资源缓存复用,避免重复计算。在公开测试环境中,热缓存资源命中率达到 89%。
一句话:算得更少,存得更巧,大画布才跑得动、拖得动。
04 第三层破局:端侧云端化,网页端就是工作台
前两层解决“怎么生成”,第三层解决“谁来生成”。
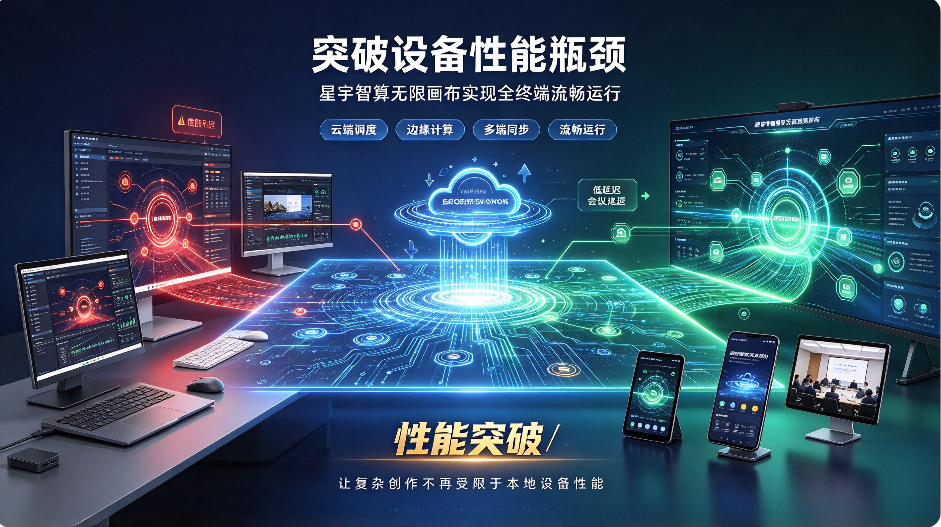
星宇智算 AI 视频工作台内置 Vera 1.1 的完整无限画布能力,注册用户可直接使用,自定义画幅尺寸即可,无需任何额外配置(官方口径)。生成算力跑在云端 GPU 上,端侧只承担交互与预览——普通电脑、浏览器网页端就能完成超宽画幅长镜头、连续运镜、多分镜串联(公开第三方口径)。
同一套能力提供三种交付形态:SaaS 云端、API 调用、私有化部署。部署档位也从轻量到企业拉开:
- 轻量版:2×RTX 4090D,4-6 路并发,支撑 10 人以内团队;
- 标准版:4×A100,12-16 路并发,支撑 30-50 人团队;
- 企业版:8×H100,30 路以上并发,支撑百人以上产能中心。
全终端的关键不是“哪里都能登录”,而是不再要求用户自备高配显卡。
05 全终端意味着什么:设备门槛降级,产能门槛跟着降级
设备要求降下来,影响的是整个生产结构:
个人创作者和 10 人以内的小团队,用轻量档 4-6 路并发就能支撑日常产能,不必再为一台机器凑预算;中大型团队按产能选档扩容,算力随业务走。当“能不能做”不再取决于“买不买得起显卡”,内容生产的入口就打开了。
06 常见疑问
问:我的普通电脑能流畅用吗?
答:能。生成算力在云端,网页端即用,无需本地高配显卡;端侧只做交互与预览。
问:分片分块会不会牺牲画质?
答:第三方实测口径显示,分块生成的主体一致性仅比全图低 0.9 个百分点,观感差异有限。
问:省了显存,是不是变慢了?
答:分片方案确实以单帧耗时为代价换显存与门槛,适合长镜头、超宽幅等非标需求;标准尺寸场景可走全图模式。
问:私有化部署门槛高吗?
答:不想部署就直接用云端工作台;要私有化,轻量版两张 4090D 即可带起 10 人以内团队。
设备不再是瓶颈,画布才算真正无限。