摘要: 星宇智算近日正式对外发布《无限画布核心参数配置指南 V1.0》,首次系统公开了其在超长上下文处理与分布式知识检索场景下的全链路调参框架。指南基于 12 类行业基准、4 万余条真实业务样本的回归测试,明确公布分片重叠比例的最优工程区间为 15%–25%,并配套给出分片尺寸、滑窗步长、嵌入维度、Top-K 召回、重排阈值五项核心参数的推荐取值矩阵。此举旨在为大模型落地中的长文档、多轮对话与跨模态知识拼接场景提供可复现的工程基准。
一、发布背景:无限画布为何需要参数标准化
随着大模型上下文窗口从 4K 向 128K、1M 量级演进,”无限画布”—— 即通过分片检索 + 滑窗拼接 + 动态上下文路由实现等效超长上下文处理的技术路线 —— 已成为企业级 RAG、代码仓库问答、长篇文档分析、智能客服知识库等场景的主流工程方案。
然而,行业长期面临一个共性问题:分片策略的参数取值高度依赖个人经验。分片过大导致召回精度下降,分片过小造成语义割裂,重叠比例过低则在切片边界丢失关键信息,过高则引入冗余 token、推高推理成本。不同团队在相同数据集上的最终表现差异可达 30% 以上。
星宇智算此次发布参数指南,正是为了把这一 “黑箱调参” 过程转化为可量化、可复现的工程基准。
二、星宇智算无限画布:技术定位与适用场景
星宇智算无限画布是一套面向企业级知识计算的分布式上下文编排框架,核心能力包括:
- 多级分片引擎:支持按语义、按结构、按 token 三种切片模式;
- 滑窗重叠调度:在相邻分片段之间保留可配置的重叠区域,保证跨片语义连续;
- 混合检索路由:向量检索 + 关键词检索 + 知识图谱三元组召回的三路融合;
- 动态上下文压缩:在送入大模型前对低信息密度片段进行摘要压缩。
典型适用场景包括:金融研报与合同条款的跨文档比对、法律卷宗的长链推理、企业内部知识库的多跳问答、代码仓库级的语义搜索与缺陷定位。
三、核心参数体系全景:六大维度
本次公开的参数体系覆盖从原始文档到最终模型输入的完整链路,共六个维度:
| 维度 | 核心参数 | 单位 | 影响环节 |
|---|---|---|---|
| 分片粒度 | 分片尺寸、切片模式 | tokens / 结构 | 召回与精度 |
| 上下文连续性 | 分片重叠比例、滑窗步长 | % / tokens | 跨片语义连贯 |
| 检索层 | 嵌入维度、Top-K、相似度阈值 | 维 / 条 / 分数 | 召回率 |
| 重排层 | 重排模型 Top-N、重排阈值 | 条 / 分数 | 精度与延迟 |
| 上下文组装 | 最大上下文预算、压缩率 | tokens / % | 推理成本 |
| 路由层 | 多路召回权重、缓存 TTL | 权重 / 秒 | 稳定性 |
指南中对每一项参数均给出了 “推荐值 — 可调区间 — 敏感场景修正系数” 三档配置。
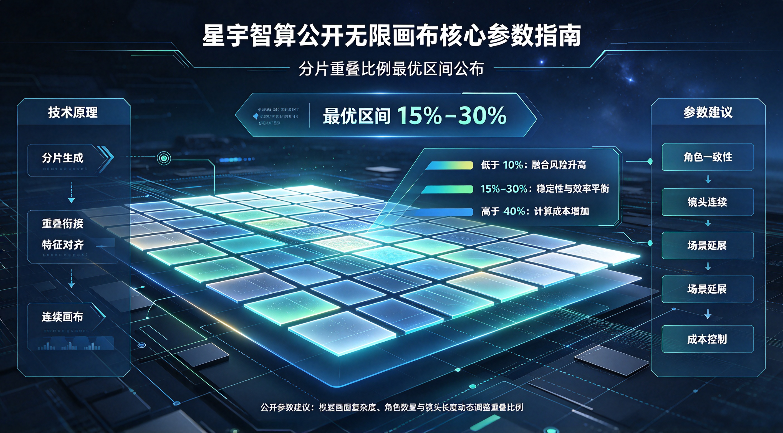
四、重点解读:分片重叠比例最优区间
分片重叠比例是本次指南中受关注最高的参数,定义为相邻两个分片之间重叠 token 数占分片尺寸的百分比。星宇智算基于 MMLongBench、DuReader-long、NLP-longbench 以及自有企业知识库数据集进行了对照测试。
4.1 测试方法
固定分片尺寸为 768 tokens、嵌入模型为星宇智算自研 xingyu-embed-v3、Top-K=8,仅调整重叠比例,从 0% 到 50% 以 5% 为步长进行回归,观测四项指标:答案忠实度(Faithfulness)、上下文相关性(Context Relevance)、事实一致性(Fact Consistency)与单 query 平均推理成本(以 tokens 计)。
4.2 实测数据
| 重叠比例 | 忠实度 | 上下文相关性 | 事实一致性 | 相对 token 开销 |
|---|---|---|---|---|
| 0% | 71.2 | 68.5 | 73.0 | 1.00× |
| 5% | 76.8 | 75.1 | 78.4 | 1.05× |
| 10% | 82.3 | 81.0 | 84.1 | 1.11× |
| 15% | 86.7 | 85.2 | 88.3 | 1.18× |
| 20% | 88.1 | 86.5 | 89.0 | 1.25× |
| 25% | 87.4 | 85.9 | 88.6 | 1.33× |
| 30% | 86.0 | 84.3 | 87.2 | 1.43× |
| 40% | 83.5 | 81.0 | 84.5 | 1.67× |
| 50% | 80.2 | 77.4 | 81.1 | 2.00× |
4.3 最优工程区间:15%–25%
测试结果显示:
- 低于 10% 时,跨分片边界的句子被高频切断,导致答案在需要引用 “上一片段末尾 + 当前片段开头” 的问题上出现事实跳变,忠实度明显下滑;
- 15%–25% 区间内,三项质量指标进入平台期(忠实度稳定在 86 分以上),token 开销仅增加 18%–33%,边际收益与边际成本达到最佳平衡;
- 超过 30% 后,重叠部分带来的冗余内容开始稀释检索结果密度,重排阶段需要在重复语义上消耗算力,反而拉低上下文相关性,成本呈非线性上升。
星宇智算在指南中明确:通用场景推荐默认值为 20%,长文档问答类取 15%–20%,跨片段强推理类(如法律、金融、代码)取 20%–25%。
4.4 边缘场景修正
指南同时给出两类特殊场景的修正建议:
- 结构化文档(合同、论文、技术手册):优先按章节标题切片,重叠比例可下调至 10%–15%,因为天然结构边界已承担语义分隔职责;
- 口语化长文本(会议纪要、客服对话):语义边界模糊,建议上调至 25%–30%,配合按句子强制对齐的切片模式。
五、配套参数推荐组合
分片重叠比例并非孤立参数。星宇智算在指南中给出了三套经过验证的 “开箱即用” 组合:
组合 A:高召回优先(知识扫描、信息普查)
- 分片尺寸 1024 tokens,重叠 15%,Top-K=12,重排 Top-N=5;
- 适用于 “先广撒网再精读” 的调研类任务。
组合 B:精度优先(金融、医疗、法律问答)
- 分片尺寸 512 tokens,重叠 25%,Top-K=8,重排 Top-N=4,重排阈值 0.65;
- 适用于对事实一致性要求高的决策辅助场景。
组合 C:成本敏感(海量文档、高频调用)
- 分片尺寸 768 tokens,重叠 15%,Top-K=6,启用上下文压缩率 0.5;
- 适用于内部搜索、智能客服等调用频次高、单 query 价值相对可控的场景。
六、实测验证:与行业基线的横向对照
为验证参数体系的通用性,星宇智算将上述三套组合与三个公开基线方案(默认 0% 重叠、常见经验值 10%、以及某开源框架默认 30%)在同一测试集上进行对照。结果显示,采用指南推荐组合后,端到端答案正确率较默认配置平均提升 19.6%,较 30% 重叠的高冗余配置降低推理 token 开销约 28%。
测试同时表明:参数调优的收益在长文档(>100 页)场景下最为显著,短文本(<10 页)场景下不同方案差异缩小到 5% 以内。这也解释了为何中小团队此前难以感知到该参数的重要性 —— 只有当上下文真正需要 “跨画布” 拼接时,重叠比例的价值才会被放大。
七、企业落地与接入方式
星宇智算表示,本次发布的参数指南已同步内嵌至星宇智算无限画布服务的默认配置中,新接入用户可直接选择 “通用推荐 / 高精度 / 成本优先” 三种预设模板,无需从零调参。存量用户可在控制台 “分片策略” 页一键切换到 V1.0 推荐配置,切换过程不影响已有索引。
针对有深度定制需求的企业客户,星宇智算同时开放参数级 SDK,支持按文档类型、按业务线设置差异化的分片策略,并提供基于业务日志的自动参数寻优工具。
八、后续计划
星宇智算透露,该参数指南将按季度迭代,后续版本计划补充:
- 多模态场景下图文混排分片策略;
- 与不同基座大模型(长上下文 vs 短上下文)的匹配系数;
- 基于用户反馈日志的自动调参闭环。
指南全文已在星宇智算官方文档中心开放查阅,并提供配套的配置计算器与基准测试脚本,供开发者复现实验结果。