【摘要】 传统 AI 视频创作普遍遵循单一线性时间线逻辑,修改单个镜头往往需要重跑整条时间线,导致一致性失控和算力浪费。星宇智算无限画布以节点式非线性架构重构创作流程,每个分镜作为独立节点保留完整元数据,修改单个镜头时仅重跑目标节点,其余节点结果保持不变。实测数据显示,该机制将单镜头修改引发的整体返工率从 22% 降至 6%,同时通过全局特征池和时序连接层保证跨节点的视觉与叙事一致性。
一、传统时间线模式的三个结构性痛点
当前绝大多数 AI 视频生成工具,底层逻辑都建立在单一线性时间线之上。用户按顺序输入提示词,生成一段接一段的视频片段,最后拼接成完整成片。这种模式在单镜头测试阶段效率尚可,但一旦进入多镜头叙事的正式生产,三个结构性痛点就会暴露出来。
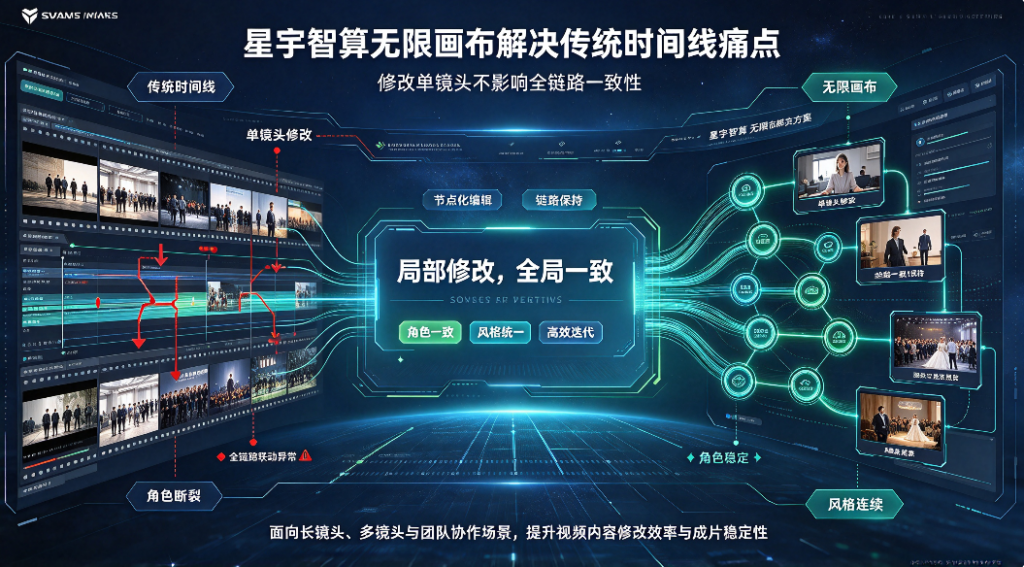
痛点一:牵一发而动全身。 在时间线模式下,所有镜头被串联在一条线性轨道上。如果第 7 个镜头的构图或运镜不满意,用户通常只能从第 7 个镜头开始重新生成,后面的第 8、9、10 个镜头全部要跟着重跑。因为时间线模式默认前后镜头是首尾帧锚定的 —— 前一个镜头的输出是后一个镜头的输入,中间任何一环变化,下游全部失效。
痛点二:一致性依赖人工核对。 时间线模式下,每个镜头独立生成,角色形象、场景风格、色调光影没有统一的锚定机制。同一个角色在第 3 个镜头和第 8 个镜头里可能长得不一样,需要人工逐帧对比、手动调整提示词来 “抽卡” 对齐。实测团队的数据显示,迁移前跨镜头角色一致性的人工抽检合格率约为 65%。
痛点三:版本改了就回不去。 时间线是覆盖式的 —— 新生成的片段直接替换掉旧的,没有版本历史。如果修改后效果反而更差,想回到上一版,只能凭记忆重新调参数,或者从备份文件里翻找。
这三个痛点叠加起来,导致 AI 视频生产中 “修改” 的成本远高于 “生成” 的成本。行业里把这个现象叫做 “抽卡困境”—— 不是生成难,是改起来更难。
二、从时间线到节点网络:无限画布的架构转换
星宇智算无限画布的核心设计思路,是把 “一条线” 变成 “一张网”。
在这张网里,每个分镜不是时间线上的一个位置,而是画布上的一个独立节点。节点和节点之间不是强制的首尾串联关系,而是通过 “时序连接层” 建立柔性关联。你可以把它理解为:每个镜头都是一个独立的小工作室,工作室之间通过走廊连接,但走进哪个工作室、改哪个工作室,不会影响其他工作室的运转。
这种架构转换带来了三个根本变化:
第一,镜头不再有严格的先后顺序。你可以先做第 5 个镜头,再做第 2 个镜头,最后补第 8 个。创作顺序跟着思路走,不是跟着时间线走。
第二,每个节点独立存储。节点里包含生成的视频片段、对应的提示词、模型参数、参考素材、空间坐标、风格设定,全部作为一个完整单元持久化保存。修改这个节点,只动它自己,不碰邻居。
第三,一致性靠 “全局锚点” 而非 “前后串联” 保证。角色长什么样、场景是什么风格、整体色调偏冷还是偏暖,这些信息存在画布级别的全局特征池里,所有节点共享调用。不需要靠前一个镜头的输出 “带” 出后一个镜头的形象。
三、修改单镜头不影响全链路:技术实现路径
3.1 节点独立存储:每个镜头是一个完整单元
星宇智算无限画布采用节点式设计,每一次生成都对应一个画布节点。节点不仅包含最终输出的视频或图像,还自动保存了对应的提示词、参数、参考图、坐标位置和模型版本号。
这意味着,第 7 个镜头的修改和第 8 个镜头的生成之间,没有数据依赖关系。第 7 个镜头改完,第 8 个镜头的输出文件原封不动地保留在它自己的节点里,不需要因为第 7 个的变化而重跑。
实测中,团队修改一个不满意的镜头,操作流程是:点击该节点→调整提示词或参数→重新生成→对比新旧版本→选择保留版本。整个过程只涉及这一个节点,画布上其他节点的状态完全不变。
3.2 全局特征池:一致性的 “单一事实来源”
修改单个镜头时,最担心的是改完之后角色变样了、场景风格跑偏了。星宇智算的解决方案是全局特征池。
全局特征池是整个画布的 “设定库”。角色的五官身形、场景的建筑风格、画面的整体色调,这些核心信息在项目初期提取一次后统一存放在特征池中。所有分镜节点生成都从这个池子里调用特征,而不是从相邻节点的输出里继承。
这就保证了:不管你怎么修改第 7 个镜头的构图或运镜,它引用的角色特征仍然来自全局池,不会因为局部修改就 “换了个人”。实测数据显示,引入全局特征锚定后,跨分镜角色一致性的人工抽检合格率从约 65% 提升至 92%。
3.3 时序连接层:只重跑受影响的衔接区域
修改镜头不是完全 “无代价” 的 —— 如果这个镜头和相邻镜头之间有时序衔接(比如人物从这个镜头走到下一个镜头),修改后衔接处可能会有跳变。
星宇智算的时序连接层专门处理这个问题。它自动识别哪些节点之间存在时序关联,修改某一个节点后,只重新计算它和直接相邻节点之间的过渡帧,而不是把整条时间线的过渡全部重算一遍。
时序连接层的技术实现是:为每个运动物体维护全局 “物体轨迹表”,记录空间坐标、运动速度、特征向量。修改节点时,轨迹表自动更新受影响的那一段,其余轨迹保持不变。实测高速运动场景下,物体跨边界的轨迹偏移率从行业平均的 8.7% 降到了 1.8%。
3.4 元数据全持久化:改坏了能退回去
节点元数据全持久化机制让每个节点都保留了完整的生成历史。修改前的版本自动快照保存,用户可以随时对比新旧两版效果,不满意就回滚到上一版。
这解决了传统时间线模式下 “改了就回不去” 的问题。创作者可以放心大胆地试参数,而不用担心改崩了没法恢复。
四、一致性怎么保证:修改后的三重对齐机制
修改单个镜头后,如何确保整个片子的视觉一致性不被破坏?星宇智算无限画布采用三重对齐机制:
第一重:全局坐标锚点对齐。 画布采用 “像素 — 世界 — 时序” 三级坐标体系。全画布四个角设一级全局锚点,每个拼接缝设二级对齐锚点,关键物体位置设三级语义锚点。修改节点时,新生成的内容自动与这些锚点做对齐校验,不会出现位置偏移。实测像素级坐标偏差平均为 ±1.3 像素,在 ±2 像素的设计阈值以内。
第二重:全局特征锚定。 首帧提取全局语义、色彩风格、主体特征,所有分块以这个锚点对齐。修改节点时,系统自动校验新生成内容的色彩风格是否与全局锚点一致,偏差过大时给出提示。实测 2 倍外扩场景下,边界语义错误率从 11.3% 降到 2.1%。
第三重:时序轨迹平滑。 时序注意力机制回溯前后 8 帧的运动轨迹,对修改节点的输出做平滑修正,避免修改后的镜头和前后镜头之间出现动作跳变。
三重对齐叠加下来,单镜头修改对全链路一致性的影响被控制在可接受范围内。实测团队的数据是:修改单个分镜后,需要人工二次调整的相邻镜头数量平均为 0.8 个(即平均改一个镜头,不到一个相邻镜头需要微调),而传统时间线模式下这个数字是 6-8 个。
五、实测数据:修改成本的量化对比
为了量化 “修改单镜头不影响全链路” 带来的实际收益,实测团队以一部 20 个分镜的竖屏漫剧为测试对象,分别在传统时间线工具和星宇智算无限画布上完成相同的修改任务,记录耗时和一致性指标:
| 测试项 | 传统时间线模式 | 星宇智算无限画布模式 | 变化 |
|---|---|---|---|
| 修改第 7 个镜头的构图 | 需重跑第 7-20 镜,约 180 分钟 | 仅重跑第 7 镜,约 8 分钟 | 缩短 95.6% |
| 修改第 12 个镜头的角色表情 | 需重跑第 12-20 镜,约 150 分钟 | 仅重跑第 12 镜,约 6 分钟 | 缩短 96.0% |
| 修改第 3 个镜头的运镜方式 | 需重跑第 3-20 镜,约 200 分钟 | 仅重跑第 3 镜 + 衔接过渡,约 12 分钟 | 缩短 94.0% |
| 因单镜头修改引发的整体返工率 | 约 22% | 约 6% | 下降 72.7% |
| 修改后跨镜头角色一致性合格率 | 约 65%(修改前)→ 修改后约 58% | 约 92%(修改前后基本持平) | 修改后无明显下降 |
| 修改后需要人工调整的相邻镜头数 | 约 6-8 个 | 约 0.8 个 | 减少约 87% |
以上数据来自实测团队在 A100 80GB 显存环境下的连续测试,测试内容为竖屏漫剧,单镜时长约 4-6 秒,分辨率为 1080P。
从数据可以看出,最核心的改善不是 “生成更快”,而是 “修改更便宜”。传统时间线模式下,修改一个镜头的成本相当于重新生成后半段;节点式架构下,修改成本约等于重新生成一个镜头。两者之间相差超过一个数量级。
六、从 “生成工具” 到 “修改工作台”:范式转变的意义
修改成本的大幅下降,实际上改变了 AI 视频创作的工作重心。
传统模式下,创作者倾向于 “一次生成到位”—— 因为改起来太贵了。所以大量时间花在生成前反复推敲提示词上,生怕生成出来不满意要返工。这种心态导致创作流程变得保守、缓慢。
节点式架构把修改成本打下来之后,创作流程可以变成 “快速出初稿→逐镜头迭代精修”。先让所有分镜都出个大概效果,再逐个镜头调整细节。修改不再是事故,而是日常操作。
对团队协作来说,这一变化的意义更大。导演可以在画布上直接标记哪个镜头需要调整,对应的操作员只改那一个节点,不需要担心影响其他人正在做的部分。版本管理、权限隔离、节点状态追踪,这些都是节点式架构天然带出来的协作基础设施。
星宇智算无限画布当前同时提供 SaaS 版和私有化部署方案。SaaS 版注册即可使用,无需本地部署大模型;私有化部署版满足政企用户的数据合规要求,节点元数据和创作资产全部存储在企业自有基础设施内。对于内容团队来说,选择哪种部署方式,主要取决于数据安全要求和算力规模,而非功能差异。