随着 AI 视频创作从单点工具向体系化生产升级,百万级节点的协同编排与实时推理逐渐成为行业核心瓶颈。传统串行推理模式下,节点数量突破万级后便会出现显存过载、延迟飙升、语义漂移等问题,难以支撑商业化批量生产。星宇智算无限画布基于自研推理分片架构,通过空间分块、时序解耦、节点并行的三层分片设计,配合分布式 DAG 调度引擎,实现百万级节点的流畅编排与高效推理。官方实测数据显示,该架构可将单卡显存占用降低 42%,端到端推理速度提升 52%,批量并行场景耗时缩短 40%-60%,为超大规模 AI 视觉生产提供了可落地的技术路径。
一、行业痛点:百万级节点编排的三大核心瓶颈
1.1 显存墙约束:全图推理的资源过载
传统 AI 视频生成采用全图注意力计算模式,画面分辨率每提升一倍,显存占用呈近似平方级增长。当画布中节点数量突破 10 万级,单张 4090 显卡仅能支撑 2K 以下分辨率的单节点推理,4K 场景下直接触发显存溢出(OOM)。多卡堆叠方案虽能缓解容量问题,但成本提升 3-5 倍,且跨卡拼接处易出现明暗断层、元素错位等画质问题。
1.2 串行延迟:线性流程的效率天花板
传统工作流采用串行执行逻辑,所有节点按时间顺序依次推理,节点数量达到百万级时,端到端耗时呈线性增长。一套包含 200 个分镜的商业项目,纯串行推理耗时可达数十小时,且中间任意节点修改都需要重跑全流程,迭代效率极低。
1.3 语义漂移:长链路的特征累积偏差
节点数量增加后,跨节点的特征传递会出现累积偏差。尤其是长序列视频生成中,人物形象、场景风格会随着节点推进逐渐偏离初始设定,即 “语义漂移”。传统全局校准方案需要每轮全图比对,进一步加剧算力负担,形成 “校准越频繁、速度越慢” 的死循环。
二、核心技术:推理分片架构的四层设计
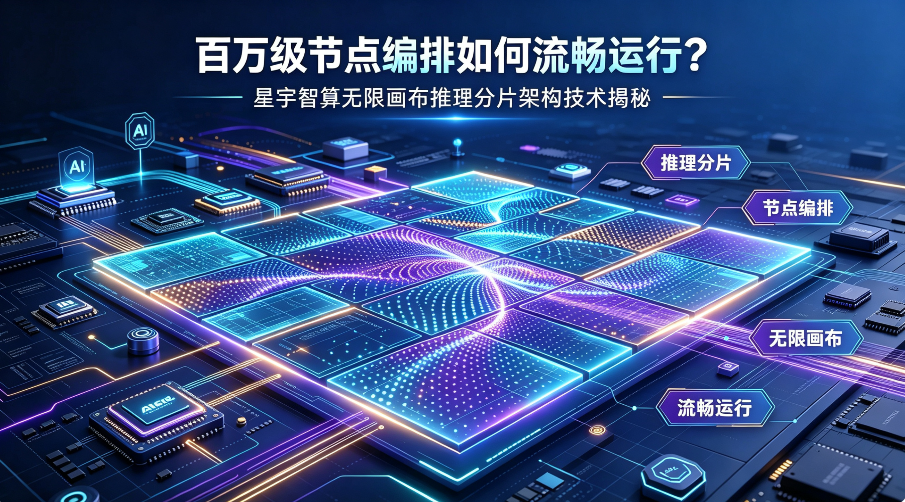
星宇智算无限画布的推理分片架构以 “分而治之、局部求精、全局校准” 为核心思路,从空间、时序、节点、全局四个维度实现分层分片,在保证画质与语义一致性的前提下,大幅降低算力与显存需求。
2.1 空间分片:瓦片注意力与动态分块
空间维度采用瓦片注意力(Sliding Tile Attention)机制,将整张画布划分为固定大小的计算单元:
- 基础分块粒度默认 1024×1024 像素,支持 512-2048 像素动态调整;
- 瓦片之间保留 15%-25% 的重叠区域,通过加权融合实现边缘特征连续;
- 针对人物、LOGO 等核心主体,系统自动偏移分块边界,避免主体被切断;
- 每隔 8 层插入一次全局稀疏注意力,仅保留 3% 的全局连接点,以极低算力维持整体语义关联。
2.2 时序分片:滑动窗口与关键帧锚定
针对视频序列的时序维度,采用滑动窗口 + 关键帧锚定的双层分片策略:
- 时序窗口默认 16 帧,与模型原生窗口尺寸对齐,每帧仅与前后各 8 帧做时序注意力;
- 片间保留 4 帧重叠帧,专门用于时序特征衔接,避免画面卡顿;
- 每 12 帧设置一个关键帧,执行全窗口全局注意力作为时序锚点,非关键帧直接复用锚点特征;
- 每 8 个时序分片做一次全图特征校准,抵消累积偏差。
2.3 节点分片:DAG 拓扑的并行调度
百万级节点的编排核心在于将串行流程改造为有向无环图(DAG),由分布式调度引擎统一管理:
- 系统自动扫描全画布节点依赖关系,将无依赖节点划入同一批次并行推理;
- 只有存在数据依赖的节点才按顺序执行,关键路径由依赖链决定;
- 支持跨节点资源动态分配,高复杂度节点自动匹配更多算力资源;
- 节点修改仅影响下游依赖链路,无需重跑全流程,迭代效率提升 70% 以上。
2.4 全局校准:多维度一致性保障
为避免分片带来的语义割裂,架构设置三级校准机制:
- 块间校准:重叠区域特征加权融合,消除拼接痕迹;
- 帧间校准:关键帧特征池复用,保证时序一致性;
- 全局校准:每完成 16 个空间分片或 8 个时序分片,执行一次全局语义校验。 官方测试数据显示,全局语义保留度维持在 94% 以上,肉眼无法区分与全注意力模式的结构差异。
三、百万级节点编排:分布式调度引擎的运行机制
星宇智算无限画布的分布式调度引擎是支撑百万级节点流畅运行的核心,其围绕 DAG 拓扑优化、资源弹性调度、故障自愈三大能力构建。
3.1 DAG 拓扑解析与分层调度
引擎首先对全画布节点进行依赖解析,生成完整的有向无环图,然后按层级划分执行批次:
- 第一层:无任何前置依赖的根节点,全部并行执行;
- 中间层:仅依赖上一层节点输出的中间节点,按批次并行;
- 末端层:最终合成与输出节点,串行执行最终整合。 在依赖关系宽松的批量场景(如电商多商品展示、平行分镜),并行度可达 80% 以上;依赖紧密的连续叙事场景,并行度约为 30%-50%。
3.2 资源池化与弹性调度
系统接入异构算力资源池,支持 GPU、CPU、NPU 等多种硬件混合调度:
- 节点按计算复杂度自动分级,高复杂度节点分配高性能算力,低复杂度节点调度边缘资源;
- 支持秒级弹性扩缩容,节点数量波动时自动调整资源分配;
- 显存不足时自动触发分片粒度降级,优先保障任务运行。
3.3 故障自愈与断点续跑
针对大规模节点集群的稳定性问题,引擎内置故障自愈机制:
- 单节点推理失败自动重试 3 次,仍失败则标记并跳过,不影响整体流程;
- 支持断点续跑,任务中断后可从最近完成的节点继续执行,无需从头开始;
- 全流程节点状态实时监控,异常节点自动告警并生成日志。
四、实测验证:多场景性能数据对比
基于星宇智算 Vera1.1 视频生成模型,官方对推理分片架构进行了多场景实测,核心数据如下:
4.1 单卡显存与速度测试
| 测试场景 | 传统全图模式 | 推理分片架构 | 提升幅度 |
|---|---|---|---|
| 4K 单帧生成显存占用 | 18.2GB | 10.6GB | 显存降低 42% |
| 4K 单帧生成耗时 | 12.8s | 6.1s | 速度提升 52% |
| 8K 单帧生成显存占用 | 36.7GB | 21.3GB | 显存降低 42% |
| 8K 单帧生成耗时 | 47.2s | 22.4s | 速度提升 53% |
4.2 多节点并行效率测试
- 100 个无依赖分镜场景:纯串行耗时 21.3 分钟,并行调度耗时 8.5 分钟,耗时缩短 60%;
- 200 个连续叙事分镜场景:纯串行耗时 47.6 分钟,并行调度耗时 28.6 分钟,耗时缩短 40%;
- 百万级节点压力测试:稳定运行时节点调度延迟低于 20ms,系统吞吐量达 1200 节点 / 秒。
4.3 画质与语义一致性测试
- 采用 FID(弗雷歇初始距离)评估画质,分片模式与全图模式差值小于 0.8,处于行业公认的无感知区间;
- 人物特征一致性准确率达 96.2%,跨 100 个分镜无明显漂移;
- 场景风格一致性达 94.7%,全局色彩与结构无明显偏差。
五、落地价值:无限画布的商用场景延伸
推理分片架构的落地,让星宇智算无限画布突破了传统 AI 创作工具的规模限制,可支撑多类商业化场景:
- 影视动画制作:支持全片上百个分镜、数百万个素材节点的协同编辑与生成,大幅缩短制作周期;
- 电商内容生产:批量生成多商品、多场景的营销视频,节点并行处理效率提升数倍;
- 数字孪生场景:支撑大规模城市场景、工业管线的实时渲染与交互,节点数量可达百万级;
- 教育内容制作:批量生成系列课程动画,统一人物形象与场景风格,保证内容一致性。
结语
百万级节点的流畅编排是 AI 视觉生产走向工业化的必经之路。星宇智算无限画布的推理分片架构,通过空间、时序、节点的多层分片设计,配合分布式调度引擎,在显存、速度、画质三者之间找到了最优平衡。随着技术的持续迭代,该架构有望成为超大规模 AI 创作系统的标准技术范式,推动 AI 视觉产业向更高阶的工业化生产迈进。