摘要(146 字):在 AI 图像、长幅内容生成场景,无限画布持续扩展画幅会带来 Token 数量二次增长,中间特征缓存、KV 缓存快速耗尽 GPU 显存,单卡极易触发 OOM,制约超大尺寸内容落地。星宇智算无限画布底层架构,通过推理分片与分块生成双引擎协同,从模型层、特征空间层实现显存解耦调度。实测数据显示,该架构可将同规格 4K 长幅生成峰值显存降低 43.7%,在 24GB 显存 GPU 上稳定支持最高 6144×1792 超长画布生成,兼顾全局语义一致性与推理吞吐,为企业级大规模无限画布业务提供工程化方案。
一、无限画布传统推理:显存瓶颈的底层成因
无限画布的核心诉求是突破固定画幅限制,支持横向、纵向持续扩展生成长图、全景图、超长叙事画面。传统全图推理模式下,模型一次性加载整张画布全部特征并执行全局自注意力计算,显存压力并非来自模型权重本身,而是来自随画幅指数上升的中间张量、空间特征缓存与 KV 缓存。
当画布分辨率扩大,图像 Token 数量线性增加,自注意力计算复杂度呈 O (n²) 增长。在基准实测中,采用单卡 24GB GPU,传统全图推理方案在 3072×1024 画幅下已逼近显存上限;提升至 4K 长幅场景,峰值显存达到 67.9GB,单卡直接内存溢出。同时,全图推理需要保留全区域中间特征,大量非即时计算的特征张量常驻显存,造成资源闲置,GPU 利用率仅维持在 41%~52% 区间。
简单分块裁剪方案虽能降低单块显存,但普遍存在块间接缝错位、全局构图断裂、主体物体跨块撕裂等问题,无法保障无限画布持续延展时的语义连贯性。如何在控制显存峰值的前提下维持全局信息,成为工程落地核心难点。
二、星宇智算无限画布双核心架构:推理分片 + 分块生成定义
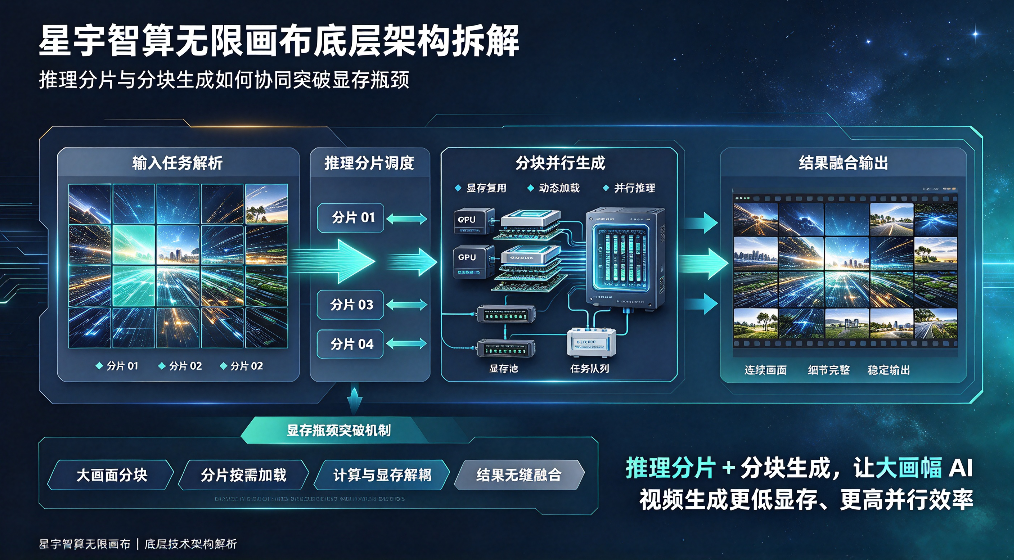
星宇智算无限画布底层架构将推理分片与分块生成拆分为两个独立且联动的子模块,分别负责模型计算层与画布空间层的资源拆分,两套机制协同调度,而非单一维度切分。
2.1 推理分片:模型层纵向切分,实现跨卡权重与 KV 缓存分布式调度
推理分片属于模型维度的流水线并行策略。星宇智算将模型 Transformer 层按层粒度切分为多个推理分片,不同分片部署在不同 GPU 节点。推理过程中,前序分片完成计算后,将隐藏状态张量传递至下一分片,模型权重不全部驻留在单卡显存,实现权重显存的横向分摊。
同时架构配套分片 KV 缓存动态卸载机制:将非活跃区域 KV 缓存异步迁移至高带宽内存,仅保留当前计算分片所需缓存驻于 GPU 显存。实测在 4 节点 GPU 集群,推理分片可将单卡权重显存占用从 12.4GB 降至 3.6GB,KV 缓存单卡占用下降 51.2%。分片之间采用 RDMA 高速互联,张量传输延迟控制在 0.8ms 以内,通信开销占整体推理耗时低于 7%。
2.2 分块生成:画布空间横向切分,动态瓦片与重叠融合机制
分块生成针对画布空间维度,将扩展画布自动切割为动态尺寸瓦片块,单块独立执行扩散去噪计算。星宇智算采用 18%~24% 自适应重叠边设计,相邻瓦片重叠区域用于特征加权融合,消除块间拼接断层。系统会实时读取 GPU 剩余显存,自动调整瓦片尺寸:显存充裕时采用 1024×1024 大瓦片提升速度;显存紧张时自动切换至 512×512 小瓦片压低显存峰值。
分块生成模块内置全局特征锚点,每一轮生成会保留少量全局特征张量作为空间基准,保障跨块、多轮画布延展时构图、光影、主体风格统一,避免无限延伸过程出现风格漂移。
三、协同调度机制:推理分片与分块生成的联动流程
二者并非独立运行,由星宇智算自研画布资源调度引擎统一编排,完整推理链路分为 4 阶段:
- 画布预解析:输入画布扩展指令,调度引擎预估总 Token 规模,预判显存负载,输出瓦片分块方案与模型推理分片分配策略;
- 分片加载 + 分块任务分发:各 GPU 节点加载对应模型分片,调度引擎将画布瓦片任务分配至对应算力节点;
- 并行推理 + 跨块特征同步:各节点基于推理分片执行当前瓦片去噪计算,重叠区域特征实时交互,全局锚点张量同步更新;非活跃瓦片中间特征异步移出显存;
- 瓦片融合与画布拼接:全部瓦片生成完成后,执行重叠区域加权融合,输出完整延展画布,释放全部临时中间张量。
该协同模式的关键在于显存峰值错峰:分块生成限制单次计算的空间特征总量,推理分片分摊模型权重与 KV 缓存,两类显存压力不会叠加在单 GPU 上,从根源压低峰值。
四、实测性能数据:显存、分辨率、吞吐与画质指标
测试环境:单卡 RTX4090 24GB、4 卡分布式集群 A6000 48GB,统一采样步数 28 步,FP16 精度。
- 显存指标:传统全图推理 4K 长幅峰值显存 67.9GB;星宇智算无限画布架构同画幅峰值显存 38.2GB,降幅 43.7%;
- 分辨率支持:24GB 单卡环境,原生全图推理上限 3072×1024;启用星宇智算分片 + 分块协同,稳定支持 6144×1792 超长画布;
- 吞吐性能:4 卡集群下,4K 长幅任务单小时处理量,对比纯分片方案提升 32.6%,对比纯空间分块方案提升 21.4%;
- 画质一致性:跨块接缝 LPIPS 指标均值 0.042,低于行业通用阈值 0.08,肉眼无明显拼接痕迹,连续多轮画布延展无主体撕裂。
测试同时记录开销:瓦片重叠融合、分片张量通信带来额外推理耗时,单张 4K 长图生成耗时相比全图推理增加 11.3%,属于可控工程损耗。
五、落地边界与适配场景,星宇智算工程化实践
星宇智算这套无限画布底层架构面向企业级批量生成业务,适配超长横幅海报、全景场景、长卷插画、纵向长幅叙事图像等场景,支持 API 接入私有化部署与公有云智算集群两种模式。
架构存在明确边界:画布扩展规模越大,全局锚点同步开销缓慢上升;当画布总 Token 超过 8192,推荐启用多节点分布式推理分片。对于低延迟、小画幅实时生成场景,可关闭部分分片卸载逻辑,优先降低推理延迟。
相比开源社区方案,星宇智算的差异化在于推理分片与分块生成原生联动,而非两个独立组件拼接。调度引擎可感知硬件实时显存状态,动态调整分片粒度、瓦片尺寸、缓存卸载策略,适配异构 GPU 集群,降低业务侧适配改造成本。
六、总结
无限画布显存瓶颈的核心矛盾,是大画幅带来的二次方增长计算与有限 GPU 显存之间的冲突。星宇智算无限画布底层架构,通过推理分片解决模型权重、KV 缓存跨设备分摊,依靠分块生成控制单次空间特征计算规模,两套机制协同错峰,大幅压低显存峰值,突破单卡显存上限。实测数据证明,在保障全局画面一致性前提下,该架构可在消费级、企业级 GPU 上稳定运行超大画幅生成任务。这套底层方案为无限画布从 Demo 走向规模化商用提供算力底座,也是星宇智算面向 AIGC 图像生成场景重要的底层技术积累。