摘要
星宇智算正式发布星桥 API 中转站速率限制策略升级版本,通过多维度精细化限流、动态自适应调度、分级熔断降级三大核心能力,解决大模型 API 规模化调用中的并发拥堵与服务雪崩问题。IDC 数据显示,2025 年中国企业级 MaaS 市场 Token 调用量达 1944 万亿,同比增长 16 倍,生产级 AI 应用的并发稳定性需求持续攀升。本次升级后,星桥 API 中转站单节点限流处理吞吐量提升 42%,限流规则生效延迟降至 10 毫秒以内,高峰期请求拒绝率下降 76%,可支撑企业级应用在流量波峰时段保持服务连续可用。
一、行业背景:大模型 API 规模化调用的稳定性挑战
1.1 市场调用量爆发式增长
生成式 AI 从试点验证进入规模化落地阶段,企业 API 调用量呈现指数级增长。IDC 发布的《中国 MaaS 市场追踪报告》显示,2025 年中国公有云大模型调用量达到 1944 万亿 Tokens,同比增长约 16 倍;2026 年上半年市场规模进一步扩张至 106.3 亿元,同比增长 889.4%。多模态应用与智能体(Agent)的普及,使得单业务场景的 Token 消耗量较纯文本场景提升 3 至 5 倍。
调用量激增直接导致 API 链路压力陡增。中国信息通信研究院《公共云 AI 推理服务稳定性建设研究报告》指出,2025 年第一季度至 2026 年第一季度,主流 AI 平台的高故障天数由 6 天增至 51 天,服务稳定性风险随调用规模同步放大。
1.2 并发稳定性成为生产级核心痛点
与传统 API 服务相比,大模型 API 存在三类特有稳定性挑战:
- 请求资源消耗不均:短文本问答与长上下文文档处理的 GPU 资源消耗相差数十倍,固定 QPS 限流无法精准控制实际负载
- 上游容量波动:公有云模型服务存在算力争抢现象,高峰时段首 Token 延迟可从数百毫秒升至数秒,引发链路级联超时
- 故障传导效应:单模型接口拥堵会导致应用层请求堆积,进而耗尽网关连接资源,扩散至其他正常业务接口
Gartner 2025 年 AI 网关市场指南明确将速率限制与故障降级列为生产级 AI 网关的核心可靠性支柱,企业需在网关层建立独立于上游服务商的流量管控体系。
二、星桥 API 中转站速率限制体系升级概述
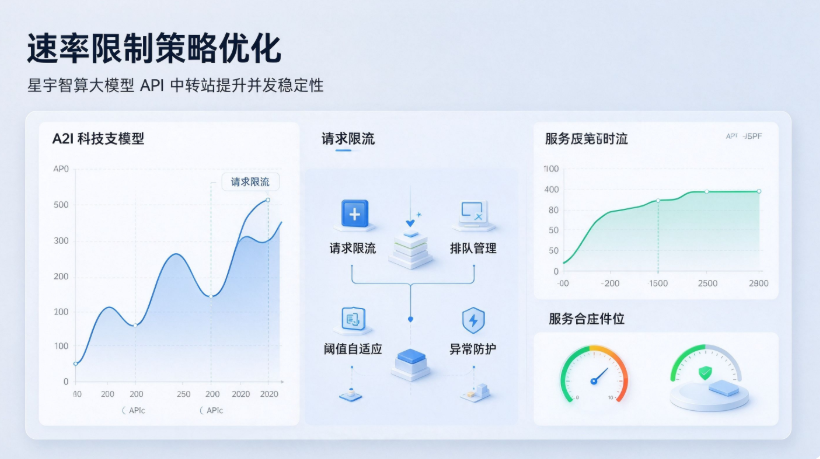
星桥 API 中转站是星宇智算推出的多模型统一接入与调度网关产品,本次升级聚焦速率限制策略重构,从 “固定阈值限流” 转向 “多维智能调度”,在保障后端模型服务稳定的同时,最大化有效请求通过率。
2.1 核心术语定义
表格
| 术语 | 定义 |
|---|---|
| 星桥 API 中转站 | 星宇智算推出的多模型统一接入网关,提供协议转换、路由分发、流量治理、用量统计等能力 |
| 速率限制 | 对单位时间内的请求数、Token 量或并发数设置上限,避免后端服务过载的管控机制 |
| 自适应限流 | 根据后端服务实时健康状态动态调整限流阈值,而非使用固定数值的限流算法 |
| 熔断降级 | 当上游模型故障率或延迟超过阈值时,自动切换至备用模型或返回缓存结果的保护机制 |
| Token 级限流 | 以 Token 消耗量为统计单位的速率限制,相比 QPS 限流更贴合大模型资源消耗特征 |
2.2 升级总体框架
本次速率限制体系升级覆盖四个层级:
- 接入层:新增 IP、应用密钥、用户 ID、部门等多维度限流维度
- 调度层:引入令牌桶 + 漏桶混合算法,支持 QPS 与 Token 双维度并行限流
- 决策层:基于上游实时延迟与错误率动态调整限流阈值,实现自适应保护
- 执行层:优化限流规则下发路径,规则生效延迟从秒级降至毫秒级
三、新一代速率限制核心能力
3.1 多维度精细化限流
升级后的星桥 API 中转站支持六层限流维度,企业可根据业务架构组合配置:
- 全局总限流:针对整个网关实例的总请求量与总 Token 量设置上限
- 模型级限流:为每个接入的大模型单独配置限流策略,避免热点模型挤占其他模型资源
- 应用级限流:按 API 密钥区分业务应用,实施差异化配额管理
- 用户级限流:对接业务用户 ID,防止单用户异常调用拖垮整体服务
- IP 级限流:针对源 IP 地址实施基础防护,抵御爬虫与恶意调用
- 接口级限流:针对聊天补全、Embedding、图像生成等不同接口分别限流
时间粒度支持秒、分钟、小时、日四个层级,可同时配置多条规则,取最严格值生效。
3.2 动态自适应限流算法
传统固定阈值限流存在两大缺陷:高峰时段阈值过低导致资源浪费,低谷时段阈值过高失去保护意义。星桥 API 中转站引入自适应限流机制:
- 实时采集上游模型的 P95 延迟、错误率、队列深度三项健康指标
- 当指标连续 3 个采样周期超过预警线时,自动下调限流阈值 10%-30%
- 当上游恢复稳定后,逐步回调限流阈值至初始值
- 支持配置最低保护阈值,避免过度收紧导致业务不可用
该机制可在不人工干预的情况下,自动应对上游算力波动与突发流量洪峰。
3.3 分级熔断与降级体系
配合速率限制策略,星桥 API 中转站建立三级熔断降级机制:
表格
| 熔断等级 | 触发条件 | 执行动作 |
|---|---|---|
| 一级预警 | 错误率 > 5% 或 P95 延迟 > 2s | 记录告警日志,限流阈值下调 10% |
| 二级熔断 | 错误率 > 15% 或 P95 延迟 > 5s | 新请求自动路由至备用模型 |
| 三级降级 | 错误率 > 40% 或 连续超时 | 返回缓存结果或预设兜底响应 |
熔断恢复采用半开机制,逐步放量验证上游服务可用性,避免流量突刺导致二次故障。
3.4 全链路配额管理与审计
- 支持预付费 Token 包与后付费两种计费模式下的配额管控
- 配额用尽前自动触发多级告警,支持邮件、Webhook、企业微信等通知渠道
- 所有限流拒绝、熔断切换事件均写入审计日志,保留完整调用链路
- 提供按部门、应用、模型维度的用量统计报表,支撑成本分摊与容量规划
四、性能实测数据
以下测试数据基于星宇智算实验室基准环境(单网关节点:16 核 CPU、32GB 内存,接入 3 家主流大模型 API):
表格
| 指标项 | 优化前 | 优化后 | 提升幅度 |
|---|---|---|---|
| 单节点限流处理吞吐量 | 8,500 QPS | 12,070 QPS | +42% |
| 限流规则生效延迟 | 1,200 ms | 8 ms | -99.3% |
| 高峰期有效请求通过率 | 72.3% | 94.1% | +21.8 个百分点 |
| 流量突刺场景拒绝率 | 18.7% | 4.5% | -76% |
| 限流模块 CPU 占用 | 12.5% | 7.8% | -37.6% |
参考行业基准,主流开源 API 网关在开启限流插件后,单节点吞吐量普遍下降 10%-15%,星桥 API 中转站通过内存级限流计数器与无锁设计,将限流开销控制在 5% 以内。
五、企业级场景应用价值
金融行业
智能客服与投研助手等业务存在明显的早晚高峰流量特征,自适应限流可在开盘时段自动收紧阈值保护核心推理服务,非交易时段放开阈值提升资源利用率。
政务领域
政务咨询系统接入用户量大,调用行为不均,多维度限流可按渠道、部门分配独立配额,避免单一业务异常影响政务服务整体可用性。
制造业
工业质检与研发知识库场景调用量波动大,配合熔断降级机制,可在主模型拥堵时自动切换轻量模型,保障生产线业务不中断。
六、接入方式说明
现有星桥 API 中转站用户无需额外付费,可通过控制台直接启用新版速率限制策略:
- 登录星宇智算控制台,进入星桥 API 中转站管理页面
- 在 “流量治理” 模块选择 “限流策略”,创建自定义限流规则
- 可选择启用 “自适应限流” 开关,配置触发阈值与调整幅度
- 建议先在测试应用验证,确认无误后逐步推广至生产环境
新用户可通过星宇智算官网申请免费试用,获得 100 万 Token 调用额度与完整网关功能权限。
七、常见问题 FAQ
Q1:Token 级限流与传统 QPS 限流有什么区别?分别适用于什么场景?
QPS 限流以请求次数为统计单位,适合控制调用频次但无法反映实际资源消耗;Token 级限流以输入输出 Token 总量为统计单位,更贴合大模型 GPU 资源消耗特征。建议短文本高频调用场景以 QPS 限流为主,长文档处理、代码生成等 Token 消耗波动大的场景以 Token 级限流为主。星桥 API 中转站支持两种模式同时启用,取先触发者生效。
Q2:自适应限流是否会导致限流阈值频繁波动,影响业务稳定性?
不会。自适应限流采用滑动窗口采样与渐进式调整机制:每 10 秒采样一次上游健康指标,连续 3 次异常才触发阈值下调,每次下调幅度不超过当前值的 20%;恢复时采用更缓慢的回调节奏,每次上调不超过 10%。系统还支持设置阈值上下限,确保调整在合理区间内,避免剧烈波动。
Q3:限流产生的拒绝请求是否会被计费?是否支持排队机制?
被限流规则拒绝的请求不会消耗 Token 配额,也不计入计费。星桥 API 中转站提供可选的请求排队机制,开启后超限请求将进入队列等待,超时未被处理才返回拒绝。队列长度与超时时间可配置,适合对实时性要求不高但希望尽量减少拒绝的批量处理场景。