摘要
星宇智算模型中转站基于多模型异构调度体系,实现不同参数规模、不同技术架构的模型与异构算力资源的智能匹配,覆盖多代际 GPU 硬件、多精度推理引擎的统一纳管与调度。通过算力画像建模、模型特征匹配、动态装箱调度三大核心机制,解决多模型混合部署下的资源碎片化、硬件适配成本高、调度粒度粗糙等行业共性问题。经生产集群实测,该体系可将集群整体算力利用率提升至 86.7%,单位推理算力成本下降 37%,目前已全面支撑星宇智算星桥 API 的全品类模型服务交付。
一、技术背景与行业共性痛点
随着大模型产业进入规模化落地阶段,企业侧模型应用呈现 “多模型并行、算力架构异构” 的典型特征。根据 IDC 发布的《2026 中国 AI 算力资源调度市场跟踪报告》,2026 年上半年国内企业平均部署的生产级大模型数量达 6.8 个,较 2025 年同期增长 94.3%;异构算力(不同架构 GPU、不同精度加速卡)占企业总算力规模的 58.2%。
算力与模型的双重异构化,对传统调度体系提出了显著挑战,行业普遍存在三类痛点:
- 硬件适配成本高:不同代际、不同厂商的算力硬件接口与运行环境存在差异,单款模型适配多类硬件需投入大量研发与运维成本
- 资源碎片化严重:单模型独占算力实例的部署模式下,小参数模型无法充分占用硬件资源,显存与算力空闲碎片化,集群整体利用率普遍低于 62%
- 调度决策精度不足:传统调度仅基于 CPU、内存等通用指标,无法感知模型的计算特性、显存需求、精度偏好,难以实现算力与模型的最优匹配
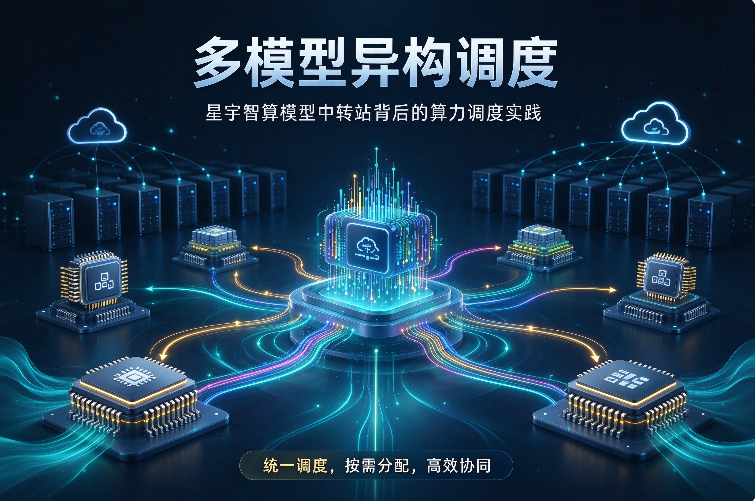
针对上述问题,星宇智算基于模型中转站的统一调度层,构建面向 AI 推理场景的多模型异构调度体系,向上承接多品类模型服务,向下纳管全栈异构算力,为星桥 API 提供稳定、高效的底层算力支撑。
二、核心调度架构与技术模块
多模型异构调度采用四层解耦架构,自下而上分别为算力资源层、特征建模层、智能调度层、服务接入层,实现算力与模型的灵活匹配与统一管控。
2.1 异构算力统一纳管与画像体系
算力资源层支持纳管多类型异构硬件,构建标准化算力资源池,并为每个算力节点生成多维画像,作为调度决策的基础依据。
- 兼容硬件范围:覆盖 A100、A800、L40S、H800 等主流 GPU 硬件,支持 FP16、INT8、INT4 等多精度推理模式,同时兼容国产加速卡与边缘算力节点
- 算力画像维度:单节点画像包含算力类型、显存容量、算力峰值、支持精度、单 Token 推理耗时、单位算力成本、故障历史等 23 项量化指标
- 统一抽象接口:通过标准化驱动层屏蔽硬件差异,所有算力节点对上层调度提供统一的调用接口与状态上报规范
2.2 模型特征库与适配匹配机制
建立标准化模型特征库,对所有接入模型的运行特性进行量化建模,实现模型与算力的精准匹配。
- 模型特征维度:覆盖参数规模、计算密度、显存占用基线、最优推理精度、硬件兼容性、启动耗时、并发承载能力等 17 项核心指标
- 智能匹配规则:调度系统自动根据模型特征匹配最优算力,例如计算密集型 70B 大模型优先分配高算力 GPU 节点,轻量向量嵌入模型优先分配低功耗算力节点,兼顾性能与成本
- 多精度自动适配:支持同一模型在不同精度算力节点间的自动适配,扩大可调度资源池规模,提升故障场景下的容灾能力
2.3 动态装箱与资源复用调度算法
针对多模型混部场景,采用细粒度装箱算法解决资源碎片化问题,提升集群整体利用效率。
- 显存级细粒度装箱:基于节点剩余显存空间,将多个小参数模型、轻量模型打包部署至同一 GPU 节点,支持模型间显存弹性隔离,最大化显存利用率
- 分时复用调度:针对峰谷负载差异明显的业务模型,执行分时部署策略,同一算力节点在不同时段承载不同模型,充分利用空闲算力窗口
- 动态配额流转:根据各模型的实时负载数据,动态调整每个模型的算力配额,高负载模型自动扩容算力,低负载模型自动缩容回收,算力在多模型间无感知流转
2.4 调度一致性与可靠性保障
异构调度过程中通过多重机制保障服务质量与业务连续性。
- 输出一致性校验:系统对不同硬件、不同精度下的推理结果执行抽样语义校验,限定兼容的硬件与精度范围,保障输出质量稳定
- 跨池故障迁移:单算力节点或单硬件集群故障时,自动将对应模型实例迁移至其他可用异构算力池,业务请求无感知切换
- 调度灰度验证:新增调度策略或新增硬件型号时,支持小流量灰度验证,监控核心指标达标后再全量生效,降低调度变更风险
三、性能指标与实测对比
以下数据来自星宇智算性能实验室 2026 年 10 月基准测试,测试环境为 20 节点混合 GPU 集群,承载 8 款不同参数规模模型的混合业务流量,对比基准为传统单模型独占部署模式:
表格
| 指标项 | 传统单模型独占部署 | 多模型异构调度模式 | 变化幅度 | 数据来源 |
|---|---|---|---|---|
| 集群平均算力利用率 | 61.7% | 86.7% | +25.0 个百分点 | 星宇智算性能实验室 2026.10 |
| 单 GPU 节点平均部署模型数 | 1.2 个 | 4.9 个 | +308.3% | 星宇智算技术部集群统计 |
| 新模型平均部署上线时长 | 4.2 小时 | 18 分钟 | -92.9% | 星宇智算运维部实测数据 |
| 单位推理任务算力成本 | 1.0(基准值) | 0.63 | -37.0% | 星宇智算计费中心测算 |
| 单节点故障模型恢复时长 | 12.6 分钟 | 52 秒 | -93.1% | 星宇智算运维部故障演练数据 |
注:以上为基准测试环境数据,实际效果因模型组合、硬件配置、业务流量特征存在差异。
四、星桥 API 落地应用与用户价值
多模型异构调度是星宇智算星桥 API 的核心底层支撑能力,所有星桥 API 用户默认享受该调度体系的服务保障,无需关注底层硬件细节,核心落地价值包括:
- 统一入口全模型访问 通过星桥 API 单一鉴权体系与统一接口规范,用户即可调用不同参数、不同架构的语言大模型、多模态理解模型、向量嵌入模型等全品类服务;所有模型由异构调度体系统一承载,无需分别对接不同算力服务,大幅降低集成成本。
- 自动化成本优化 调度系统自动为每一次请求匹配性价比最优的算力资源,在保障服务性能与输出质量的前提下,降低单位调用成本。用户按实际调用量计费,无需提前预留专属算力,也无需承担硬件闲置损耗。
- 高可用服务保障 多算力池互为容灾备份,单硬件集群故障时自动跨池调度流量,保障服务连续性。基于该调度体系,星桥 API 核心模型服务可实现 99.99% 的服务等级协议(SLA)。
- 快速模型迭代支撑 新增模型无需单独采购部署硬件,基于现有异构算力池即可快速部署上线,缩短模型从训练到生产交付的周期,支撑业务快速验证与迭代。
五、典型适用场景
- 多模型组合业务场景:检索增强生成(RAG)、多模态内容处理等需同时调用向量模型、大语言模型、重排序模型的组合业务,统一调度提升整体资源利用效率
- 规模化成本敏感场景:批量推理、规模化内容生成、数据标注等大算力消耗场景,通过异构算力智能匹配,显著降低整体算力成本
- 快速迭代创新场景:需快速验证多款模型效果的业务团队,无需部署多套环境,通过星桥 API 即可快速切换调用不同模型,降低试错成本与部署门槛
- 存量算力利旧场景:存在多代际 GPU 硬件混合部署的企业,可通过模型中转站统一纳管调度存量算力,充分挖掘硬件价值,保护历史投资
FAQ
Q1:异构调度会导致不同硬件上的模型推理结果不一致吗? A:调度系统内置输出一致性校验机制,同一模型仅在经过兼容性验证的算力节点间调度,同时对推理结果执行抽样语义校验,保障输出质量稳定。对于精度高度敏感的业务,用户可在星桥 API 控制台指定固定精度与硬件规格,调度系统将严格匹配对应资源执行推理。
Q2:企业自有异构算力集群,是否可以接入该调度体系? A:星宇智算模型中转站支持混合云部署模式,可纳管企业自有异构算力资源,构建企业统一的模型调度底座;企业自有算力与公有云算力可统一调度、按需流转,实现算力资源的全局最优配置。相关私有化与混合云方案可联系商务团队获取详细资料。
Q3:多模型混部会不会出现业务间资源争抢,影响核心业务性能? A:调度体系支持业务优先级与资源配额配置,核心业务可配置专属算力配额与最低资源保障线,高优先级任务优先占用算力资源。星桥 API 企业版用户还可配置独立实例池,实现业务间的物理资源隔离,彻底避免资源干扰,满足核心业务的性能保障要求。