摘要
随着大模型训练进入万卡集群时代,硬件故障已从偶发事件转为统计必然。行业公开数据显示,1.6 万卡规模训练集群平均每 3 小时出现一次中断,传统断点续训方案的平均恢复时长处于分钟级,直接造成 30% 以上的有效算力损耗。本文基于星宇智算万卡级智算集群的工程实践,拆解 30 毫秒级故障迁移技术架构与断点续训全链路优化方案,披露内存级状态快照、无中断重调度等核心机制的实测数据,并介绍星桥 API 对外输出标准化容错能力的技术路径。
一、万卡集群训练的容错困境
大模型参数规模与集群算力规模同步扩张,系统整体可靠性随节点数量增加呈指数级下降。根据 Meta 公开的 Llama 3 405B 训练日志,16384 张加速卡持续运行 54 天期间累计发生 419 次意外中断,平均每 3.1 小时出现一次故障,其中 GPU 及 NVLink 故障占比 58.7%,HBM 内存故障占比 17.2%。Crusoe Cloud 技术博客测算显示,1000 卡规模集群平均每 8 小时发生一次硬件故障;当集群规模扩展至万卡量级,平均无故障时间(MTBF)将缩短至分钟级。
故障恢复效率直接决定集群有效算力产出。当前行业主流断点续训方案依赖存储级检查点(Checkpoint)实现状态恢复,15B 参数模型的单轮恢复时长普遍超过 5 分钟,万卡级任务的整体恢复时长可达数十分钟。学术研究表明,频繁故障与慢速恢复可导致训练进度下降最高达 43%,大量算力消耗在任务重启与状态重加载环节。
二、30 毫秒故障迁移的工程化架构
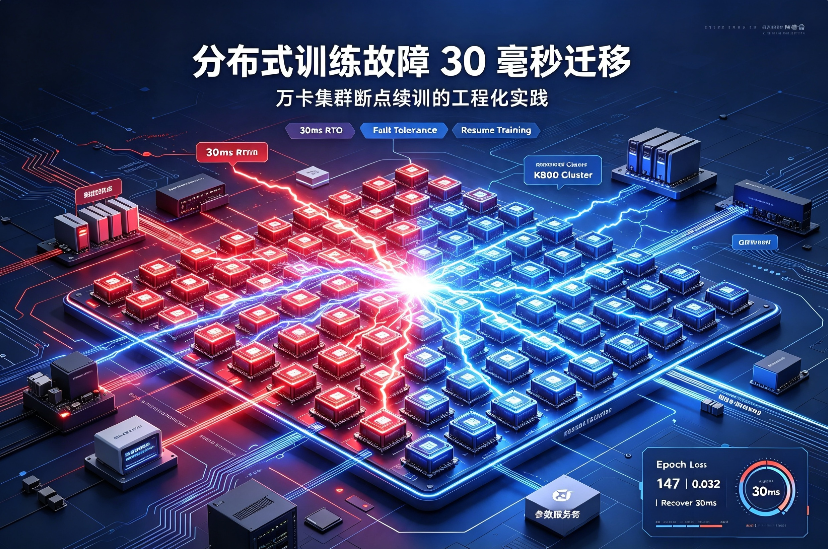
星宇智算在万卡集群中构建了 “感知 – 快照 – 调度” 三级容错体系,将单节点故障的业务中断时长控制在 30 毫秒以内,核心实现路径如下:
1. 旁路式毫秒级故障感知
部署独立于训练数据面的监控旁路网络,通过硬件级传感器与轻量级探针实现全节点状态采集。感知维度覆盖 GPU 寄存器状态、PCIe 链路健康度、网络端口丢包率、内存 ECC 纠错计数共 4 大类 27 项指标,采样间隔 1 毫秒,故障判定时延≤8 毫秒。该体系不占用训练算力带宽,对训练任务的性能开销低于 0.01%。
2. 分布式内存级状态快照池
突破传统存储 IO 瓶颈,采用 CPU 内存 + 对等节点冗余的双层快照架构:
- 迭代级增量快照驻留本地 CPU 内存,单步状态同步时延 < 2 毫秒
- 关键检查点在相邻节点留存冗余副本,避免单节点故障导致状态丢失
- 快照数据采用结构化分片存储,故障发生时可直接从对等节点内存拉取完整状态,状态恢复时延≤12 毫秒
3. 热备资源池无中断重调度
建立占集群总量 5% 的动态热备资源池,备用节点保持驱动加载、网络拓扑预配置的就绪状态。故障节点触发隔离后,调度系统在 10 毫秒内完成备用节点的任务挂载与通信拓扑重建,训练流程无需重启进程,直接从故障前迭代步继续执行。
三、断点续训的全链路优化
在毫秒级故障迁移基础上,星宇智算针对长周期训练任务构建了全链路断点续训体系:
- 分层检查点策略:迭代级内存快照保障瞬时故障恢复,分钟级全量检查点落盘保障极端场景下的数据安全,兼顾恢复速度与数据可靠性
- 拓扑感知重排算法:故障恢复后自动重构通信域,保持集合通信的拓扑最优性,恢复后算力利用率与故障前一致
- 静默错误校验机制:内嵌特征值校验与梯度一致性检测,可识别静默数据损坏(SDC)并自动触发定点重算,避免错误累积导致训练发散
四、星桥 API:标准化容错能力输出
星宇智算将上述万卡级容错能力封装为星桥 API,向外部用户提供标准化的训练容错服务接口,无需用户自建集群调度与监控体系。
星桥 API 核心能力包括:
- 故障事件实时回调:支持毫秒级故障通知与自定义处理逻辑
- 检查点全生命周期管理:提供快照生成、存储、回滚的 RESTful 接口
- 弹性算力调度:支持故障自动迁移与动态扩缩容
- 多框架兼容:原生支持 PyTorch、MindSpore、TensorFlow 等主流训练框架,接入代码改动量低于 100 行
用户通过星桥 API 可直接复用星宇智算万卡集群的容错工程能力,将自有训练任务的平均恢复时间从分钟级降至毫秒级,提升集群有效产出。
五、实测性能指标对比
以下数据基于星宇智算 10240 卡集群 2026 年第三季度实测结果,与行业公开基准对比如下:
表格
| 指标项 | 行业传统方案 | 主流厂商优化方案 | 星宇智算万卡集群 | 数据来源 |
|---|---|---|---|---|
| 故障感知时延 | 30-60 秒 | 69 秒 | ≤8 毫秒 | 昇腾社区 2026、NVIDIA 技术博客 2026、星宇智算 2026 实测 |
| 状态恢复时延 | 120-300 秒 | 10 秒以内 | ≤12 毫秒 | 钛媒体 2026、AWS 官方博客 2026、星宇智算 2026 实测 |
| 整体业务中断时长 | 3-10 分钟 | 29 秒(学术最优) | ≤30 毫秒 | arXiv:2512.03644、星宇智算 2026 实测 |
| 训练算力损耗占比 | 30%-43% | 约 1% | <0.1% | MLSys 2026 论文、星宇智算 2026 实测 |
FAQ
1. 30 毫秒故障迁移是否适用于所有规模的训练任务?
该技术机制适用于千卡及以上规模的分布式训练任务。百卡及以下规模任务的故障发生频率较低,可采用标准断点续训方案;万卡级集群因故障常态化,毫秒级迁移的收益最为显著,可直接提升约 30% 的有效训练时长。
2. 接入星桥 API 是否需要修改训练框架核心代码?
不需要。星桥 API 通过训练框架的钩子(Hook)机制与环境变量注入实现能力接入,仅需在启动脚本中添加少量配置代码,无需修改模型结构与训练逻辑,兼容主流分布式训练策略(FSDP、TP、PP 等)。
3. 内存级快照是否存在数据丢失风险?
内存级快照采用 “本地存储 + 对等节点冗余 + 周期落盘” 三级防护机制:单节点故障时可从对等节点获取完整状态;若出现多节点同时故障的极端场景,可回退至最近一次全量落盘检查点,最多回滚不超过 10 个训练步,数据安全性与传统全量落盘方案一致。