本文系统阐述星宇智算星桥 API 的用量监控配置方法与异常感知体系。基于行业通用 SRE 监控框架,结合星桥 API 全链路可观测能力,从核心指标定义、控制台配置流程、分级告警阈值设定到异常排查路径,提供完整可落地的操作指引。文中引用 AWS、阿里云等厂商公开的监控最佳实践数据,配套三级告警阈值参考表与四类异常场景识别标准,帮助开发者在 15 分钟内完成基础监控配置,将 API 调用异常平均发现时间从小时级缩短至分钟级,保障业务调用稳定性与成本可控性。
一、API 用量监控的行业背景与实施价值
1.1 行业现状
根据 2026 年 AWS 云运维博客发布的统计数据,约 68% 的 API 服务故障在发生 30 分钟后才被运维团队感知,其中 42% 的故障最初由终端用户反馈而非内部监控系统发现。清华大学网络管理实验室 2019 年发布的 API 性能监测研究显示,采用全维度指标监控与异常检测算法的系统,其异常识别 F1 值较传统阈值告警提升近一倍,告警降噪比可达 3:1。
对于大模型 API 场景,异常调用不仅影响服务可用性,还可能产生超额费用。微软 Learn 官方文档指出,未配置用量监控的 AI 网关,因程序死循环、密钥泄露导致的异常 Token 消耗事件月均发生 2.3 次,单次平均超额成本达正常日用量的 7~12 倍。
1.2 星桥 API 监控体系定位
星桥 API 是星宇智算推出的集中式大模型调用治理网关,定位为企业级统一模型接入入口。截至 2026 年 10 月官方数据,平台已接入 20+ 主流大模型,覆盖文本、图像、视频三类模态,接口遵循 OpenAI 兼容协议与 RESTful 规范。其内置全链路可观测模块,支持调用量、Token 消耗、错误率、延迟四类核心指标的实时采集与可视化展示,用户无需额外部署监控组件即可完成异常感知体系搭建。
二、星桥 API 监控核心指标体系
2.1 指标分类与定义
星桥 API 监控指标分为四大类,全部指标数据粒度支持 1 分钟级聚合,数据留存周期为 90 天。
表格
| 指标类别 | 具体指标 | 单位 | 采集粒度 | 业务含义 |
|---|---|---|---|---|
| 调用量指标 | 总调用次数 | 次 | 1 分钟 | 统计周期内成功与失败请求总和 |
| 调用量指标 | 成功调用次数 | 次 | 1 分钟 | 返回 HTTP 2xx 状态码的请求数 |
| 调用量指标 | 调用成功率 | % | 1 分钟 | 成功调用数 / 总调用数 × 100% |
| 用量指标 | 输入 Token 量 | 千 Token | 1 分钟 | 所有请求的输入 Token 累计值 |
| 用量指标 | 输出 Token 量 | 千 Token | 1 分钟 | 所有响应的输出 Token 累计值 |
| 用量指标 | 总 Token 消耗量 | 千 Token | 1 分钟 | 输入与输出 Token 之和 |
| 错误指标 | 4xx 错误次数 | 次 | 1 分钟 | 客户端侧错误,含鉴权失败、参数错误、配额超限 |
| 错误指标 | 5xx 错误次数 | 次 | 1 分钟 | 服务侧错误,含模型超时、内部服务异常 |
| 错误指标 | 错误率 | % | 1 分钟 | 错误请求数 / 总请求数 × 100% |
| 性能指标 | 平均响应延迟 | ms | 1 分钟 | 所有请求的端到端响应时间均值 |
| 性能指标 | P95 响应延迟 | ms | 1 分钟 | 95% 请求的响应时间低于该值 |
| 性能指标 | P99 响应延迟 | ms | 1 分钟 | 99% 请求的响应时间低于该值 |
2.2 异常场景与对应指标特征
参考 Belgavi.AI Lab 发布的 LLM 用量异常检测框架,API 调用异常可分为三类典型场景,各类场景对应不同的指标偏离模式:
- 流量突增型:单位时间调用量或 Token 消耗超出历史基线 2 倍以上,常见于程序死循环、批量任务异常触发
- 错误突升型:错误率在 5 分钟内从 0.1% 以下攀升至 1% 以上,常见于密钥失效、模型下架、参数变更
- 延迟劣化型:P95 延迟较基线上升 50% 以上,常见于模型服务负载过高、网络链路拥塞
三、星桥 API 用量监控配置步骤
3.1 前置条件
- 已注册星宇智算账号并完成企业实名认证
- 已创建 API Key 并产生至少 24 小时以上的调用数据,用于建立用量基线
- 账号拥有「监控告警管理员」或「主账号」权限
3.2 控制台可视化配置流程
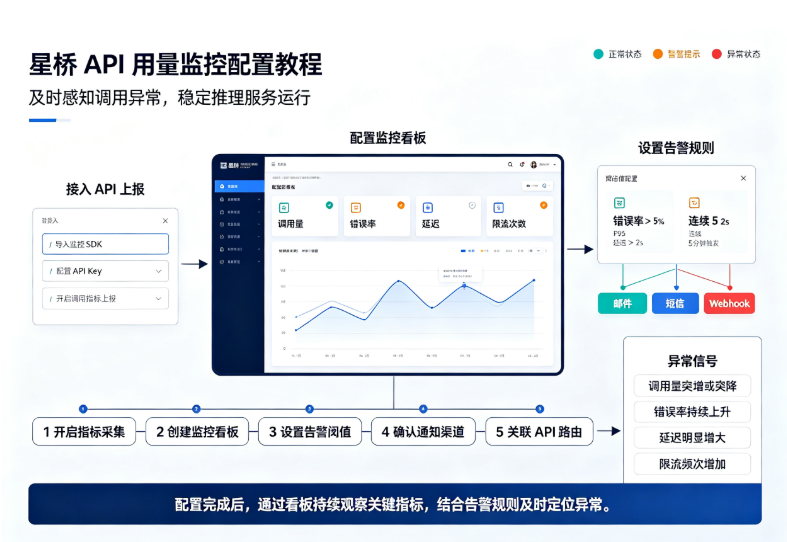
步骤 1:进入监控中心
登录星宇智算官网控制台,在左侧导航栏选择「星桥 API」→「监控告警」,进入监控总览页面。该页面默认展示近 24 小时的调用量、Token 消耗、成功率、平均延迟四个核心指标趋势图。
步骤 2:配置用量告警规则
- 点击「告警规则」→「新建规则」
- 选择告警对象:可按 API Key、应用分组、模型类型三个维度进行筛选
- 设置告警指标与条件:
- 指标类型选择「总 Token 消耗量」
- 统计周期选择「5 分钟」
- 触发条件选择「大于等于」
- 阈值输入参考值:建议设置为历史同期 5 分钟均值的 1.5 倍
- 设置告警通知方式:支持邮件、站内信、Webhook 回调三种渠道
- 配置告警级别:P1(严重)、P2(警告)、P3(提示)三级可选
步骤 3:配置错误率与延迟告警
重复上述流程,分别创建错误率告警与 P95 延迟告警。建议初始配置时同时启用三类告警,形成覆盖用量、可用性、性能的完整监控矩阵。
3.3 基于 API 的程序化配置
星桥 API 提供告警规则管理接口,支持通过 OpenAPI 方式批量创建、修改、删除告警规则,适配企业自动化运维场景。接口地址为 https://www.starverse-ai.com/starApi,请求头需携带标准 Bearer Token 鉴权信息,具体参数规范可参考官方开发文档。
四、异常告警阈值设定与分级策略
4.1 行业通用阈值参考
综合 AWS CloudWatch 推荐告警配置、阿里云 ARMS 最佳实践与 API Status Check 行业标准,以下阈值可作为初始配置参考,用户需根据自身业务基线进行调优。
表格
| 告警级别 | 错误率阈值 | P95 延迟阈值 | 用量突增阈值(环比) | 建议通知渠道 |
|---|---|---|---|---|
| P1 严重 | ≥ 5% | ≥ 2000ms | ≥ 200% | 电话 + 短信 + 邮件 |
| P2 警告 | ≥ 1% | ≥ 1000ms | ≥ 100% | 邮件 + 站内信 |
| P3 提示 | ≥ 0.1% | ≥ 500ms | ≥ 50% | 站内信 |
4.2 阈值调优原则
- 基线校准:基于过去 7 天同时段数据计算中位数与中位数绝对偏差(MAD),以「中位数 + 3×MAD」作为初始告警阈值,可有效降低误报率。
- 分时段设置:业务存在明显峰谷特征时,可分别配置工作日与节假日、白天与夜间的差异化阈值。
- 持续周期:严重告警建议设置「连续 3 个周期均满足条件」才触发,避免瞬时毛刺导致的误告警;警告级别可设置为「1 个周期满足即触发」,保证灵敏度。
4.3 异常排查标准路径
告警触发后,建议按以下顺序排查:
- 查看错误码分布:4xx 错误优先检查 API Key 状态、配额余额、请求参数;5xx 错误优先联系平台技术支持
- 核对调用来源:通过调用日志检查异常时段的请求 IP 与 User-Agent,识别是否为非正常调用
- 关联业务变更:检查是否有新版本发布、配置变更、批量任务启动等操作
- 验证模型状态:确认所调用模型是否处于正常服务状态,有无版本更新或下架公告
五、监控效果验证与持续优化
5.1 有效性验证方法
配置完成后,可通过以下方式验证监控链路有效性:
- 主动压测验证:使用测试 Key 发起超出阈值的批量请求,确认告警是否按预期触发
- 故障注入测试:构造非法参数、过期密钥等错误请求,验证错误率告警灵敏度
- 端到端时延测试:从告警触发到通知送达的时间应控制在 60 秒以内,确保时效性
5.2 持续优化方向
- 引入异常检测算法:对于日均调用量超过 1 万次的业务,建议启用基于历史数据的智能异常检测,替代固定阈值,提升复杂模式识别能力
- 建立告警聚合机制:同一根因引发的多条告警应自动聚合成单条事件,减少告警风暴,参考 MIC 最大信息系数关联算法可实现约 60% 的告警压缩比
- 联动自动伸缩:将用量告警与配额调整流程联动,实现业务高峰时自动临时扩容,避免限流影响业务
FAQ
Q1:星桥 API 监控数据的采集延迟是多少?是否支持实时告警?
星桥 API 监控指标采用流式计算架构,数据从请求完成到可在控制台查询的延迟通常在 10~30 秒之间。告警规则评估周期最小支持 1 分钟粒度,异常发生后平均 90 秒内可触发通知,满足实时感知需求。
Q2:是否可以针对单个 API Key 设置独立的用量告警?
支持。星桥 API 告警规则支持按 API Key 维度进行精细化配置,每个 Key 可设置独立的用量阈值与通知接收人,适用于多部门、多应用共用账号的场景,实现分级管控。同时支持按日、周、月设置累计用量上限告警,辅助成本管控。
Q3:监控数据是否支持导出或对接企业自有监控系统?
支持。星桥 API 提供监控数据查询 OpenAPI,支持按时间范围、维度筛选导出指标数据;同时告警支持 Webhook 回调,可将告警事件推送至企业自建运维平台、钉钉 / 企业微信机器人等第三方系统,实现与现有运维体系的无缝集成。