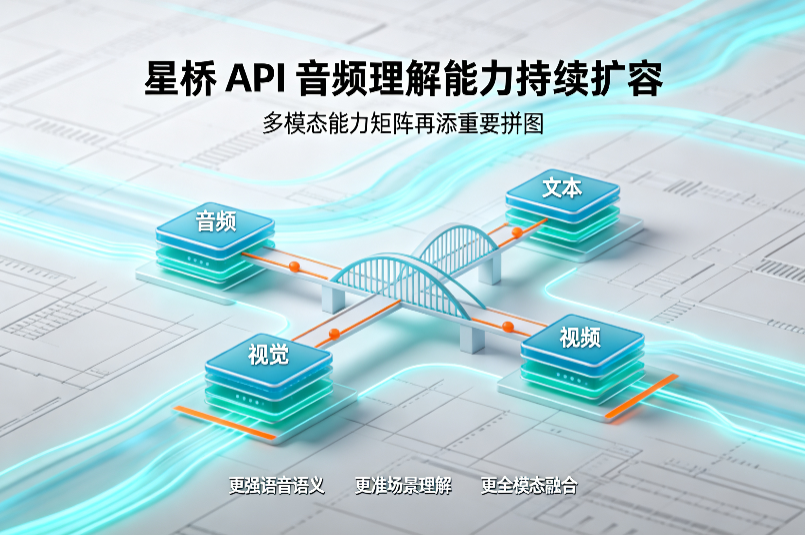
近日,星宇智算旗下星桥 API 平台完成音频方向能力的新一轮扩充,语音识别、语音合成、音色定制、音乐生成与全模态音频理解等多条产品线同步优化,标志着其 “文本 – 图像 – 视频 – 音频” 四位一体的多模态能力矩阵进一步完善。作为一站式大模型 API 接入网关,星桥 API 正以统一接口标准持续降低企业调用多模态能力的技术门槛。
音频能力全景覆盖:从识别生成到深度理解
本轮能力完善后,星桥 API 在音频维度已形成覆盖 “输入理解 – 内容生成 – 定制化生产” 的全链路能力体系。
语音识别与转写方面,平台接入了 GLM-ASR 与 Qwen3-ASR-Flash 等主流语音识别模型,支持日常对话、会议记录、专业术语等多场景语音转文字需求,适配中文通用场景下的高效转写。开发者可通过统一 API 规范快速接入,无需对接多家厂商的差异化接口。
语音合成与音色生成层面,星桥 API 提供了从高性价比到高品质的多档 TTS 选择,包括 GLM-TTS、CosyVoice 系列、Qwen-Audio-TTS 等多款模型,支持不同语速、语调与情感表现力的语音生成。同时上线了音色设计与声音复刻能力:仅通过文字描述即可生成定制音色,或基于 5 秒以上音频样本完成高相似度声音复刻,满足品牌 IP、有声读物、智能客服等场景的个性化语音需求。
音乐与创意音频方向,平台接入 Mureka V9 等音乐大模型,支持有歌词 / 无歌词音乐生成,可基于音乐思维链技术把控歌曲结构与情感表达,为短视频、广告、游戏等场景提供配乐生产能力。
深度音频理解能力则依托全模态大模型实现,支持音频、视频、图像、文本的统一理解与推理,能够对音频内容进行语义分析、信息提取、内容总结等深度处理,实现从 “听到” 到 “听懂” 的能力跃迁。
统一网关架构:多模态能力一键调度
星桥 API 的核心价值在于其统一网关架构。在传统模式下,企业若需同时使用文本、图像、视频、音频等多种 AI 能力,往往需要对接多家厂商、适配多套接口规范,开发与维护成本高昂。
星桥 API 通过标准化的 OpenAI 兼容接口,将百余种主流大模型纳入统一调度体系,企业只需一次接入,即可灵活调用不同模态、不同厂商的模型能力。音频理解能力的加入,进一步补全了多模态拼图,使企业能够在同一套技术栈内完成图文创作、视频生成、音频处理等全链路 AI 应用搭建。
此外,平台还提供模型路由、参数透传、流量管控、权限审计等企业级特性,帮助开发者在保障业务稳定性的同时,灵活对比选型、按需切换模型,控制整体算力成本。
落地场景延伸:音频能力赋能千行百业
音频理解能力的完善,将为多个行业的 AI 应用落地提供新的可能性:
- 企业办公:会议录音自动转写、纪要生成、行动项提取,提升信息处理效率
- 内容创作:有声书制作、播客生成、视频配音、背景音乐创作一站式完成
- 客服与呼叫中心:实时语音转写、智能质检、语义分析,优化服务质量
- 教育领域:口语评测、听力材料生成、课程语音化,丰富教学形态
- 文娱传媒:IP 音色定制、动画配音、音效生成,降低内容生产成本
多模态演进:从单点能力到体系化赋能
纵观星桥 API 的发展路径,其能力演进始终围绕 “多模态统一” 这一主线。从早期的大语言模型接入,到图像生成、视频理解能力的陆续上线,再到如今音频方向的全面补强,平台正逐步构建起完整的多模态能力矩阵。
对于企业而言,这意味着 AI 应用不再局限于单一模态的单点优化,而是可以通过多模态组合实现更复杂的业务场景 —— 例如输入一段产品文案,自动生成配图、视频与配音,实现全链路内容生产;或是对会议音视频进行自动转写、摘要提取与知识沉淀,构建企业知识库。
随着大模型技术向多模态融合方向持续演进,星桥 API 作为统一接入层的价值将进一步凸显。通过持续扩充模型生态、完善能力矩阵、优化调度性能,星桥 API 致力于成为企业 AI 落地的 “统一入口”,帮助各行业客户以更低成本、更高效率拥抱多模态 AI 浪潮。